

1
遇见·摘要
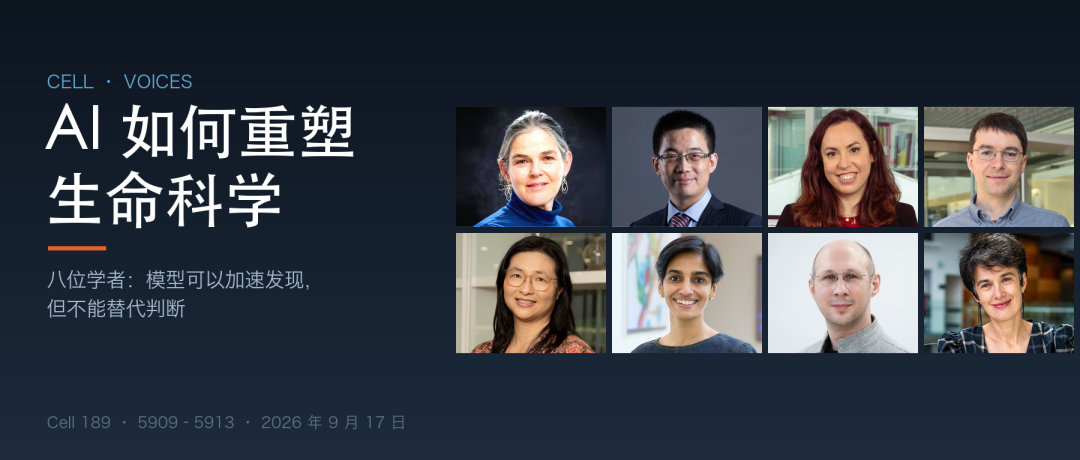
同一期刊、同一个问题、八种学科背景的回答。2026 年 9 月 17 日《Cell》的 Voices 栏目请八位研究者各自回答“AI 正在怎样改变生命科学”。没有人否认加速正在发生,也没有人认为模型可以替代判断;而真正缺的东西,八个人说得很不一样。
图文摘要
2
遇见·内容
2026 年 9 月这一期的题目是“Changing minds: How AI is transforming the life sciences”,八位作者各写一篇短文,彼此不做对谈,也不互相引用。他们分别来自制药与机器学习(Daphne Koller,insitro 与斯坦福大学)、结构生物学(卢培龙,西湖大学)、计算生物学(Laura Cantini,巴斯德研究所)、免疫信息学(Yuri Pritykin,普林斯顿大学)、生物统计(Jean Y. H. Yang,悉尼大学)、神经科学(Kanaka Rajan,哈佛医学院)、蛋白注释(Martin Steinegger,首尔大学)与临床 AI(Mihaela van der Schaar,剑桥大学与弗朗西斯·克里克研究所)。
八篇短文放在一起,像一次不约而同的诊断:算力与模型已不是瓶颈,卡住的地方在数据那一端。
因果模型不会自己长出来
Daphne Koller 的判断很直接:药物发现的瓶颈从来不是化学,而是我们追着疾病跑却不了解病因——错误的靶点、错误的细胞、错误的人群。AI 最该回答的是因果问题:面对以整个人为尺度测量的结局,究竟是哪个基因、在哪类细胞里、通过什么机制在驱动它,扰动之后它会不会反过来。这条链条跨五到六个数量级,从 ICD 编码一直落到单细胞的分子状态,没有人能在脑子里装下它。
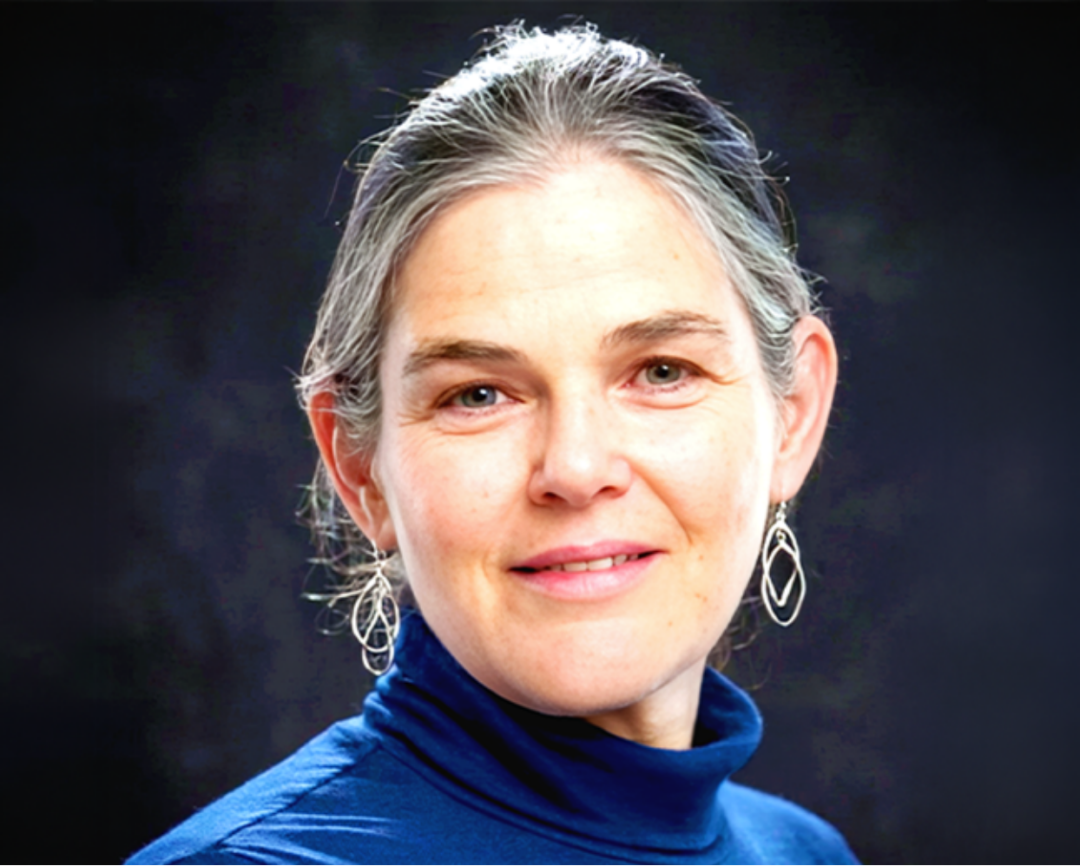
真正的因果杠杆只有两处来源。一是人类遗传学,自然界替我们做的随机实验;二是对人类细胞的直接扰动,我们自己做的实验。两者都不完整:遗传学告诉你某个基因重要,却说不清它怎样起作用;扰动告诉你基因如何起作用,却说不清它对人是否重要。把两者合起来,模型才可能从结局推理到机制,让靶点的选择建立在证据上而不是期待上。
在 Koller 看来,最常见的错误不在 AI 对生物学的理解,而在人怎么用它:拿手上现成的观察性数据训练模型,再指望它给出因果答案。预测模型学到的是共现,不是因果,规模再大也换不来。更麻烦的是训练所需的因果数据原本就稀缺,因果既不能爬取也不能推断,只能靠扰动一个系统再记录结果测出来。把这类数据成规模地生产出来才是真正的工程量,也是目标仍然遥远的原因。目标从来不是虚拟细胞,而是多尺度的人的因果模型。
结构预测之后,卡在功能这一侧
卢培龙从序列—结构—功能这个老范式讲起。数十年的积累存下了海量蛋白序列与高质量结构,才有了 AlphaFold 这样的预测模型,以及 RFdiffusion、ProteinMPNN 这样的设计工具。这些工具的作用已超出“预测一个结构”:它们能提示蛋白如何与离子、小分子、核酸和多糖编织成互作网络,据此识别未知的大分子复合物及其缺失组分,也能加速蛋白类药物、诊断试剂与研究工具的开发。
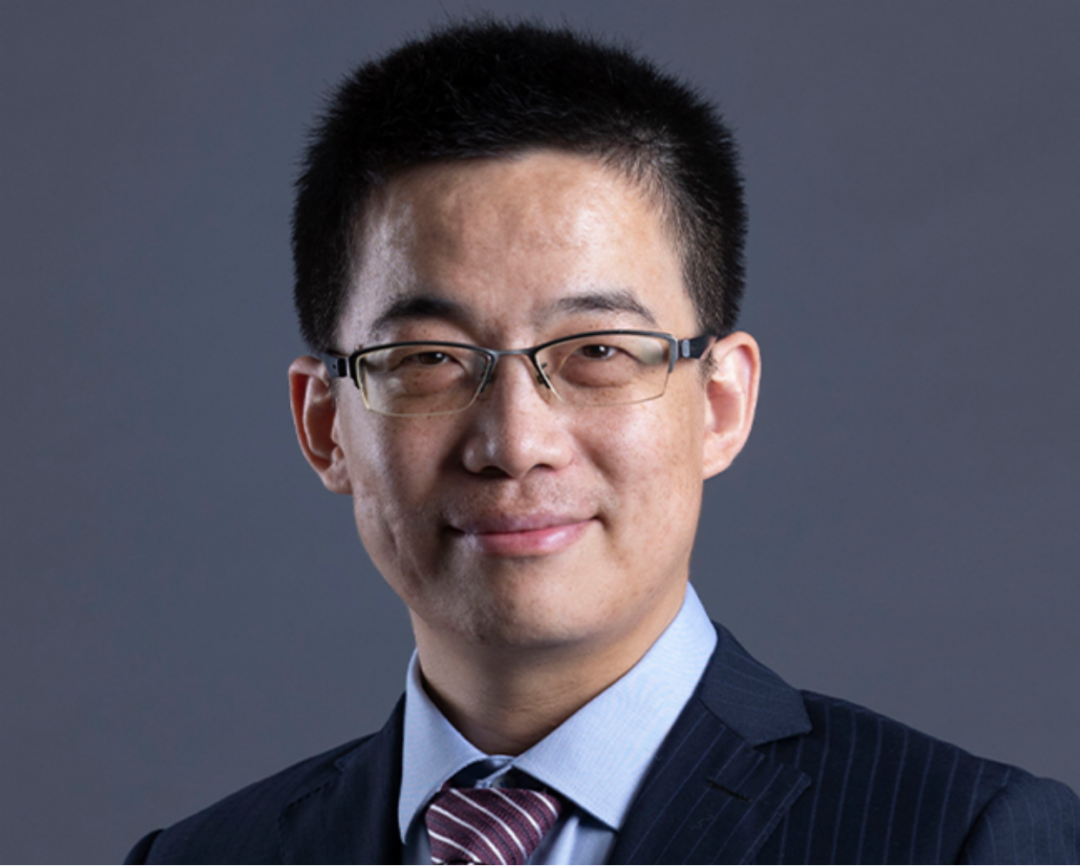
问题出在后半段。序列到结构这一段进展显著,结构到功能这一段仍然空着,而缺口主要不在算法,在功能数据本身——数量、质量与标准化都不够。现有系统仍难以预测动态的构象集合、复杂的核酸架构与超大组装体,也难以设计出高活性的酶和动态分子机器。功能往往来自依赖环境的动力学与细胞环境,静态的结构模型表达不了这些。
他把话说回到人身上:解释复杂的生物学背景、在意外结果里认出偶然发现、为不确定的计算预测设计关键实验,这些仍要由人来完成。这个时代最要紧的资产是批判性思维——判断哪些问题适合交给 AI,从成堆的预测里挑出值得追的那几条,并对模型幻觉保持警觉。
规模之外,模型还要装进生物学的结构
Laura Cantini 的出发点是单细胞技术:多模态、带空间坐标,一次能测数百万个细胞,等于给细胞的组织方式开了一扇前所未有的窗。基础模型随之成为从这种复杂度里提取模式的主力。但领域里最基本的问题仍未解决——一个细胞凭什么决定走向某一种命运,驱动这些转变的调控逻辑又是什么。
理由在于尺度与组合复杂度:成千上万的分子在数百万细胞中非线性地相互作用,横跨分子、空间与时间三个尺度,经典统计方法很难单独覆盖这片变异空间;现代 AI 提供的正是从高维系统里学习所需的表征能力。整合异质模态、推断基因互作网络、从大规模单细胞与空间数据建模动态过程,这些已经成了常规操作。
她更在意两处隐忧。其一,基础模型处理批次效应已相当熟练,但能否学到稳健可泛化的细胞动态表征,取决于训练数据的结构、规模与分辨率,而单细胞与空间数据仍然稀疏、采样不均、常缺模态覆盖。其二,生物结构在模型里怎么表示:不少生物学基础模型是从语言或视觉架构改造来的,对基因调控网络、空间组织与时序程序所定义的约束只捕捉了一部分。忽视这些结构,得到的模型可能很会预测,却在机制上站不住。
结论因此落在范式上:从默认“生物数据弱结构”的学习方式,转向更贴近多尺度组织的模型,把机器学习与领域原理放在一起,让系统不只预测细胞行为,还能生成机制性的、可检验的假设。
免疫细胞工程,需要更严的输出评估
Yuri Pritykin 把问题推到最难的一端。AI 正在逼近一个统一模型:从基因组序列一路连到细胞、多细胞乃至个体表型。免疫系统或许是最难的一处,也恰恰是解决之后最要紧的一处。进展最快的是基因调控,因为序列到功能的问题定义得比较清楚、训练数据也充足;即便如此,模型仍受限于数据——免疫细胞类型的全谱、健康与疾病之间连续的状态谱,都还覆盖不全。
再往外一步更难。免疫细胞的命运不只由基因组、表观基因组与三维分子互作决定,还取决于细胞之间的物理接触、细胞因子信号以及在组织里的空间位置,而这些都随时间变化。AI 的位置独特,正在于能把这几层尺度接起来,学会预测、控制并最终工程化免疫应答。前提是产出跨模态、跨时空情境的测量与扰动,并且以图谱和共享资源的形式积累,而不是围着某一个假设转。
他由此提出一个交换条件:深度学习当年减少了手工特征工程,基础模型如今减少了对“先用具体假设论证数据生产”的要求。输入端放宽了论证,输出端就必须收紧评估——严格的基准测试、讲清适用边界、发表阴性结果、与那些有时表现更好的简单模型正面比较。过早宣布问题已解决,只会把注意力从尚未解决的地方挪开。此外还需系统性地并入免疫学的领域知识:正如数学的形式化催生了近期 AI 在一批长期悬置问题上的突破,把生物学的逻辑形式化,是让 AI 能推理复杂生命系统的前提。
把 AI 当实验台,而不只是预测器
Kanaka Rajan 的问题落在另一个层面:大脑如何协同工作。眼下关于多智能体 AI 的讨论很多,关心的是 AI 之间怎样互相交互、汇聚资源、解决复杂问题;而在生物世界里,这种协作是日常。人的生活大多在三到十人的小群体里展开——家庭、朋友圈、工作团队,能否有效协调与心理健康直接相关。这些紧密连接一旦消散,随之而来的是孤独、隔离,以及和抑郁、痴呆相关的社交退缩,后果不可轻视。
现有神经科学技术足以揭示孤立状态下的单个大脑,她想知道的却是一小群人在实时互动中如何协调。标准脑成像一次只能扫一两个人,观察性研究能记录自然的群体行为,却看不到背后的神经活动。过去几乎无法弥合这道缝,因为不能在观察复杂群体互动的同时记录多个大脑内部。
Rajan 的做法是用 AI“智能体”:被设定为与真实大脑受同样生物约束的模拟角色,用小鼠、蝙蝠这类社会性动物的真实行为与神经数据训练。几个智能体放在一起互动,就能在规模化建模群体动态的同时,追踪每个智能体内部与彼此之间的神经动态。这样一来,活体动物上不可能或不伦理的实验变得可行——选择性切断某条沟通通道、缩小群体、引入干扰,观察协调究竟怎样、又为什么崩解,再把结论拿去与真实脑记录对照。
顺着这个框架,可以勾出群体保持连接、适应丧失、冲突后恢复所对应的神经特征;识别跨物种的共通模式,也有助于设计针对社交隔离的干预。更远一点,它给出了构建与人类协作、本质安全可信而非仅仅聪明的 AI 系统的蓝图。在这项工作里,AI 是揭示机制的关键,而前提是这些智能体必须用与真实大脑相同的架构和限制去解决协调问题。
从描述到预测,从注释到机制
Jean Y. H. Yang|悉尼大学
基因组学、空间组学与成像已把测量推进到从分子、细胞到整块组织的分辨率,约束不再是产生数据,而是整合:怎样把不完整、彼此异质的观测拼在一起,理解组织如何被组织起来、在疾病中又如何改变。Yang 的判断是 AI 能把生物学从描述性的科学变成预测性的科学。一个具体的可能是从部分测量重建并预测组织的分子状态——比如只用组织学图像和有限的空间数据推断基因或蛋白表达。模型在学习组织结构、细胞排布与分子活动之间的关系之后,可以搭出“虚拟组织”,把没有被直接测到的分子特征揭示出来,进而提出假设、指导实验、预测组织对疾病与治疗的反应。
她也把边界说清楚了:AI 不会取代科学家。它的长处是从海量数据集与文献里找模式,而提出正确的问题、把模式放回语境里解释,仍然由人负责;模型该如何基准化、用哪些数据集与生物学设定、以什么标准判定它可靠且可泛化,也由人决定。她自己的用法是把 AI 当作一个可以来回追问的对象——检验想法、打磨假设、整理思路,判断某个解释在生物学上是否站得住,列出竞争解释,再找出能区分它们的证据。
Martin Steinegger|首尔大学
Steinegger 的问题来自环境样本:土壤、海水、废水。做这类数据的人都会撞上同一堵墙——被鉴定出的蛋白里常有 80% 至 90% 找不到可识别的序列近亲,只能标成 hypothetical,实践中干脆被排除在生物学解释之外,于是我们只盯着像已知的那一小部分,把测到的大部分放过去。AI 把这道墙推开了一半:两个蛋白可以几乎没有可检测的序列相似性,却共享同一个折叠。为这些未知蛋白预测结构,然后比形状而不是比序列,能给其中大约一半找到关系。病毒研究受益尤其明显——病毒蛋白极难注释,可病毒似乎共用一套蛋白折叠的语言,于是它们可以被比较、被放回演化脉络里,针也就从草堆里露出来了。
他更看重下一步:预测病毒蛋白怎样结合宿主蛋白,等于把注释变成机制——不再问某段序列是否来自病毒,而问它感染谁、如何与宿主相互作用。规模化的多聚体预测与界面分析是这条路的核心,其中相当一部分也许能在计算端完成。障碍有两个。复合物预测依赖互作双方共享的演化信号,而病毒与宿主之间的这类信号常常很弱;模型能分辨大的结构差异,却对付不了细微的差别。宿主范围有时只由几个替换决定——同一个折叠、几个残基换掉,病毒就获得了感染人的能力,而两张预测结构看上去几乎一模一样。能不能分辨这么小的差别,正是“认出病毒”与“弄懂病毒”之间的分界。现有模型在折叠这一层已经做得很好,下一个前沿在残基这一层。
医学里,预测准确不等于理解
Mihaela van der Schaar 在 AI、生物学与医学的交界处做了十多年,因果机器学习、合成数据、数字孪生都是她参与推动的方向。她认为医学与临床试验最该由 AI 解决的问题是:如何在更早的时候、在不确定之下、为对的那个病人做出更好的决定。医学是动态的——病人会恶化、康复、复发,对同样的治疗反应不同,在复杂的照护路径里移动。AI 能把这些差异放进同一个推理框架:结合纵向与多模态数据、建模疾病轨迹,并且不只问会发生什么,还要问哪个动作能改变结局。
这一点在临床试验里尤其要紧。许多失败并非分子本身的失败,而是病人选择、终点选择、剂量、时机、招募、依从性出了问题,或者建立在从未被压力测试过的假设上。因果模型、合成数据与数字孪生可以帮助判断哪些病人最可能获益、哪些亚组信号是真的、哪些试验设计本身是脆弱的。
她随即划出界线:医学不只是模式识别,它是因果的、不确定的、生物的、伦理的、深具情境的,预测准确与理解并不是一回事。试验应当随证据积累而学习,可持续学习不能变成不受控的适应;AI 应当支撑生物学、统计、运营与监管上的推理,而不是即兴设计一个试验、或替代科学判断。每一次适应都必须透明、可审计、经过前瞻性验证,并由事先定好的规则治理。
这也是她看重自己在弗朗西斯·克里克研究所角色的原因:下一个前沿不只是“AI 用于医学”,而是理解生物学足够深、从而真正改变医学的 AI。如果 AI 能帮人推理机制、疾病演化、实验设计与生物异质性,临床 AI 就不止是风险预测,而是从生物学发现通往更好疗法与更好试验的一座桥。
八个人的答案,指向同一处
AI 正在怎样改变生命科学?八篇短文放在一起看,反复出现的不是工具名,而是三种稀缺物。Koller 说因果数据只能靠扰动测出来,规模换不到;Steinegger 说下一个前沿在残基层面,折叠这一层的模型已经饱和;van der Schaar 说每一次适应都必须透明、可审计、可前瞻验证。三句话说的是同一件事——AI 得嵌进机制与实验之间,而不是站在它们外面。
八位作者没有一位认为模型会取代科学判断,分歧只在“最缺的那一块”是什么:有人指向因果数据,有人指向功能数据的量与标准,有人指向评价方式本身。这份分歧本身值得留意,因为它决定了接下来几年该把资源投在哪里。
3
遇见·文章信息
文章题目:Changing minds: How AI is transforming the life sciences
全文链接:https://doi.org/10.1016/j.cell.2026.08.019
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢