

2026年10月31日,碳硅智慧首席科学家、浙江大学侯廷军教授团队联合中国药科大学等多家科研机构及企业,在国际权威期刊Nucleic Acids Research在线发表了题为“PROTAC-DB 4.0: an expanded knowledgebase of targeted protein degradation modalities with AI-powered knowledge discovery”的研究论文。
该研究推出了新一代靶向蛋白降解数据库PROTAC-DB 4.0。在此前版本的基础上,研究团队不仅大幅扩充了PROTAC分子及其实验数据,还首次系统整合了分子胶(Molecular Glues,MGs)和多种新型功能性靶向嵌合体(X-functional Targeting Chimeras,XTACs),构建了覆盖多种靶向降解与诱导邻近技术的综合性知识平台。更值得关注的是,PROTAC-DB 4.0引入了基于大语言模型(LLM)和检索增强生成(RAG)的智能问答系统,将结构化分子数据与科学文献相结合,使研究人员能够通过自然语言完成复杂的化合物检索、机制分析和知识发现。这一升级标志着PROTAC-DB正从传统的化合物信息数据库,向融合专业数据、文献知识与人工智能的交互式科研平台演进。
靶向蛋白降解快速发展,高质量数据资源成为关键
靶向蛋白降解(Targeted Protein Degradation,TPD)是近年来创新药物研发的重要方向之一。与传统小分子抑制剂通过持续占据靶蛋白活性位点发挥作用不同,PROTAC技术通过招募E3泛素连接酶,诱导目标蛋白泛素化并由蛋白酶体降解,为传统难成药靶点提供了新的干预策略。与此同时,分子胶以及多种基于诱导邻近机制的新型技术不断涌现,靶向蛋白降解领域正在从单一技术路线向多元化分子调控体系发展。
然而,这些新型分子的作用机制、结构特征及实验评价指标存在显著差异,相关研究数据分散于大量学术文献和专利之中,给分子设计、构效关系分析及人工智能模型开发带来了挑战。特别是在AI驱动的药物设计中,模型不仅需要分子结构,还需要靶蛋白、E3连接酶、细胞背景、实验条件及定量活性等信息。如何建立规模更大、质量更高、实验信息更完整的数据资源,已成为推动该领域发展的重要基础。针对这一挑战,研究团队在持续建设六年的PROTAC-DB基础上,推出了全面升级的4.0版本。
从PROTAC到分子胶与XTAC:数据库实现跨模态扩展
PROTAC-DB 4.0最显著的变化,是突破了传统PROTAC分子的收录范围,将多种具有诱导邻近机制的分子类型纳入统一的数据体系。新版数据库共收录:
15,502条PROTAC数据记录,对应10,725个独立PROTAC分子;
24,798条分子胶数据记录,对应15,237个独立分子胶;
272条XTAC数据记录,涵盖多种新型功能性靶向嵌合体。
其中,PROTAC独立分子数量由上一版本的6,111个增长至10,725个,收录靶蛋白数量由442个增加至573个,E3连接酶种类扩展至22种。在实验数据方面,具有DC50降解活性数据的PROTAC记录由1,762条增加至3,595条,具有细胞活性数据的记录增加至4,997条。同时,数据库还进一步扩充了Western blot实验、药代动力学及晶体结构等信息。
此次新增的分子胶数据不仅包括分子胶降解剂(Molecular Glue Degraders),还涵盖能够稳定蛋白质相互作用的分子胶稳定剂(Molecular Glue Stabilizers),为研究不同类型的蛋白质相互作用调控机制提供了数据基础。
此外,XTAC数据集覆盖了DUBTAC、PHOTAC、RIBOTAC、HaloPROTAC、PhosTAC等多种技术路线,涉及蛋白质稳定、光控降解、RNA降解及蛋白质磷酸化调控等不同生物学功能。
这些技术虽然具有不同的作用机制,但都利用分子诱导邻近或模块化招募效应蛋白的原理,实现对生物分子功能的精准调控。通过整合不同技术类型,PROTAC-DB 4.0实现了从单一PROTAC数据库向多模态靶向降解与诱导邻近知识库的拓展。
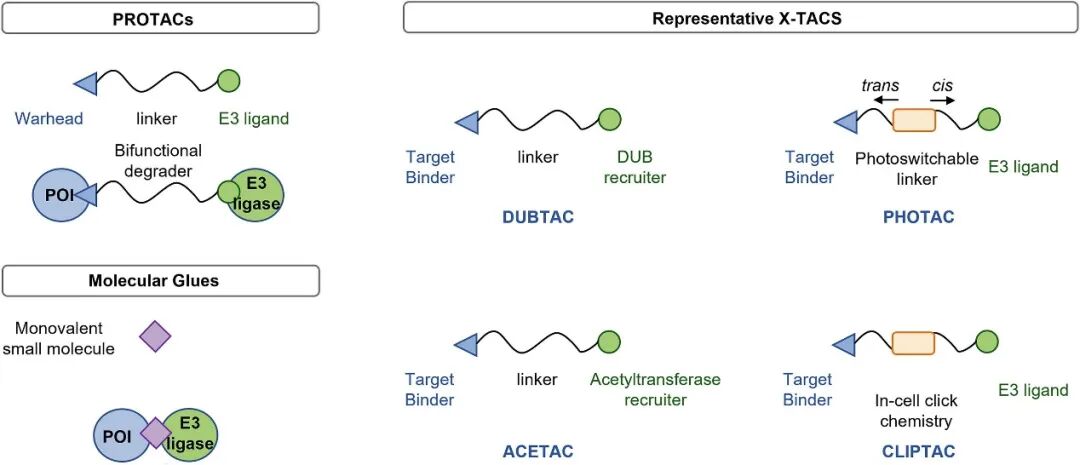
图1:PROTAC-DB 4.0收录的PROTAC、分子胶及代表性XTAC技术类型。
引入LLM与RAG:从传统数据检索走向智能知识发现
除了数据规模与覆盖范围的扩展,PROTAC-DB 4.0的另一项重要创新,是引入基于大语言模型和检索增强生成技术的自然语言查询系统。
传统分子数据库通常需要用户掌握检索字段、筛选条件及数据库结构。当研究问题涉及多个化合物、靶点、实验指标或文献来源时,往往需要进行多轮检索和人工整理。针对这一问题,研究团队设计了融合结构化数据库检索与科学文献检索的多智能体系统。当用户提出研究问题时,系统首先通过智能路由模块(Router Agent)识别问题涉及的分子类型、靶蛋白、活性指标及检索需求,随后调用两类核心检索模块:(1)数据库检索智能体(Database Retrieval Agent) 从PROTAC-DB的结构化记录中检索化合物结构、靶点、E3连接酶及活性数据;(2)文献检索智能体(Paper RAG Agent) 则从科研论文中提取与问题相关的实验结果、作用机制及研究证据。该系统构建了包含1,271篇相关文献的知识检索语料库。最终,大语言模型整合数据库记录与文献证据,生成带有来源依据的综合性回答。
例如,研究人员可以直接询问:“寻找针对BTK、DC50低于10 nM的PROTAC分子,并解释其使用了哪些E3连接酶。”系统能够结合定量活性信息与相关文献,完成多条件筛选及结果解释。对于更加复杂的问题,例如“CRBN与VHL介导的PROTAC在药物开发方面各有哪些优势与局限”,系统也可以整合数据库统计结果和相关研究证据,提供结构化比较。此外,平台还支持分子胶作用机制解释、新型XTAC技术分类及相关体内实验研究的知识汇总。这种将结构化科研数据与非结构化科学文献结合的技术路线,使数据库不再局限于静态数据展示,而能够支持更加灵活的科研知识探索。
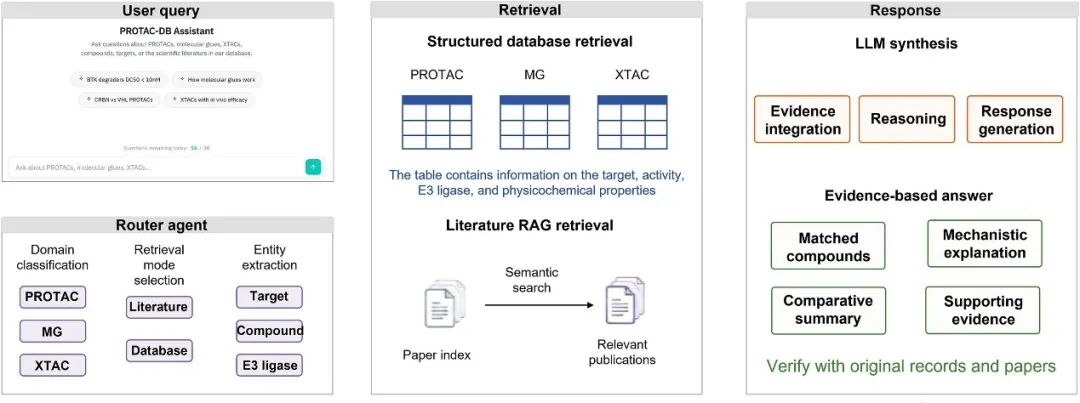
图2:PROTAC-DB 4.0中基于LLM和RAG的智能知识检索系统架构。
统一检索与多维度分析,为AI药物设计提供数据基础
在用户使用体验方面,PROTAC-DB 4.0进一步完善了不同分子类型的统一浏览、查询和下载功能。研究人员可以在同一平台中检索PROTAC、Warhead、E3 Ligand、Linker、Molecular Glue及XTAC等不同类型的数据,并根据靶蛋白、分子性质和生物活性等条件进行筛选。针对不同分子类型,平台提供定制化的数据展示页面,使用户能够查看分子结构、靶点信息、作用机制及可获得的实验活性数据。与此同时,数据库持续开展文献与专利信息收集,并对化学结构及实验数据进行标准化整理,增强数据的可追溯性与可复用性。这些功能不仅能够支持传统的药物化学研究、结构优化与构效关系分析,也为基于机器学习和深度学习的降解活性预测、分子性质建模及生成式分子设计提供了更加丰富的数据来源。对于正在快速发展的AI驱动靶向蛋白降解研究而言,高质量的实验数据是模型训练与验证的重要基础。PROTAC-DB 4.0所建立的跨模态数据体系,有望为未来构建更加通用的靶向降解预测与设计模型提供支持。
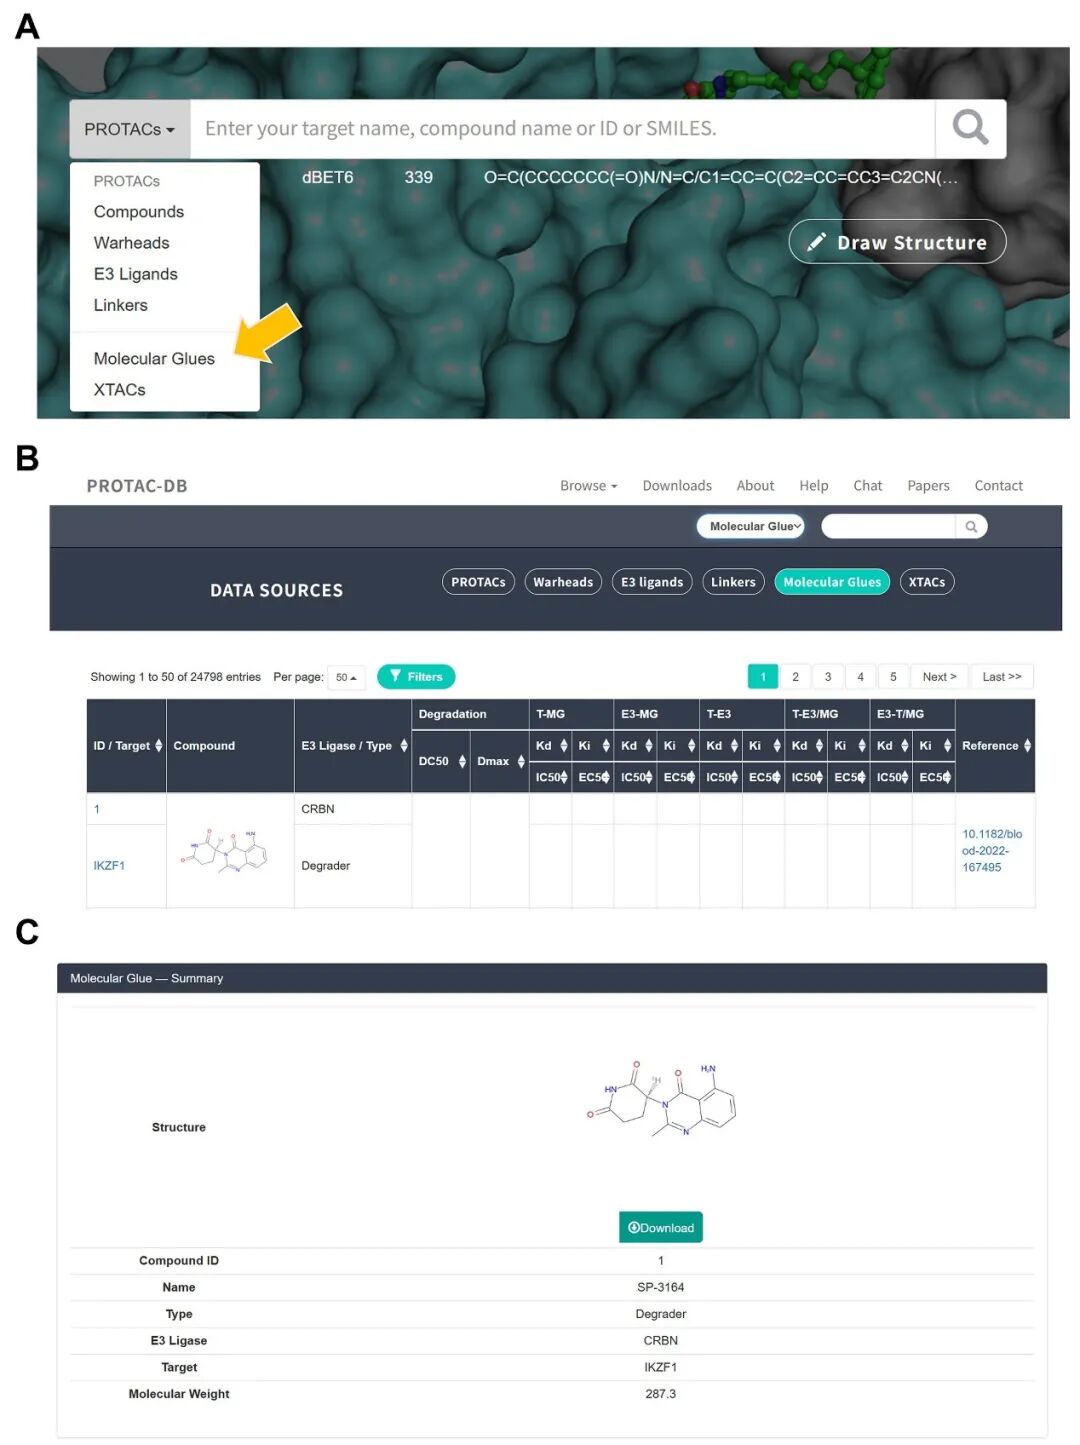
图3:PROTAC-DB 4.0数据库检索界面及分子胶详细信息页面。
从数据积累到AI赋能,推动下一代靶向降解药物研究
随着靶向蛋白降解技术不断发展,相关科研平台的价值已不仅体现在收录多少化合物,更在于能否将复杂的分子结构、实验活性和生物学知识有效连接起来。PROTAC-DB 4.0通过数据资源扩展、跨模态信息整合和智能知识检索,进一步提升了靶向蛋白降解研究的信息可获取性与数据复用价值。尤其是大语言模型与专业数据库的结合,为人工智能辅助药物研发提供了一种值得关注的技术路径:以高质量结构化数据为基础,以原始科研文献为知识补充,通过智能检索与信息整合支持科研人员开展分析和决策。未来,随着数据库持续更新和人工智能技术进一步发展,PROTAC-DB有望在靶向降解机制研究、候选分子发现以及数据驱动的理性药物设计中发挥更加重要的作用。目前,PROTAC-DB 4.0已向全球科研人员免费开放。
参考资料
Jingxuan Ge, Chen Yin, Yurong Li, Shi Li, Kexin Xu, Rongfan Tang, Gaoqi Weng, Hao Luo, Lin Tang, Youqiao Qian, Shukai Gu, Chang-Yu Hsieh, Jian Wu, Dan Li, Huiyong Sun, Tingjun Hou, PROTAC-DB 4.0: an expanded knowledgebase of targeted protein degradation modalities with AI-powered knowledge discovery, Nucleic Acids Research, 2026;, gkag1098, https://doi.org/10.1093/nar/gkag1098
数据库地址: http://cadd.zju.edu.cn/protacdb/
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢