

海量RNA序列为基础模型提供了学习材料,但分子的组织方式还藏在字母之间:哪些位置配对,哪些片段形成茎与环,折叠后又如何呈现功能部位。要让AI更好地服务生物研究,一个关键问题是把这些关系转化为有效的训练信号。
近日,发表于《Nature》正刊的structRFM给出了一项具体探索。中国科学技术大学MIRACLE实验室博士毕业生朱河勤为独立第一作者,周少华教授、熊鹏研究员为共同通讯作者。研究从数据构建、掩码设计到跨任务验证,将RNA二级结构用于基础模型学习。
生物基础模型的一个目标,是把不同研究中反复需要的分子规律沉淀为可复用特征。面对一个新任务,研究者可以利用这些特征,再学习所需的输出。对RNA来说,碱基配对是一种明确、常见且可计算的关系,因此适合作为切入口,检验生物知识究竟怎样参与模型训练才有效。
数据对应关系怎样真正进入学习
RNA二级结构回答哪些碱基彼此配对、如何组成茎与环,三级结构则回答整条分子在空间中如何折叠。这些关系影响核糖体RNA、转运RNA和多种调控RNA的活动。测序积累的序列远多于实验解析的结构,怎样获得规模化结构线索,是图1首先处理的问题。
团队提出MUSES,整合ViennaRNA、CONTRAfold与BPfold的预测,为约2100万条RNA构建序列—二级结构配对数据。三种方法分别利用热力学、概率建模和深度学习信息,通过集成缓解单个预测器的偏差。数据中的结构来自计算注释,其价值在于让大量序列具备可参与训练的配对信息。
图1中的SgMLM进一步规定如何使用这种信息。模型仍通过补全被遮蔽的核苷酸学习序列,但部分遮蔽位置由二级配对关系决定:相关位置被联合遮住,使恢复任务要求模型综合其余上下文。训练保留随机掩码,并动态平衡两类策略;结构知识因此参与学习过程,而无需把预训练绑定到某一种任务标签。
训练后的编码器只输入序列,输出序列级、核苷酸级和成对特征,分别支持分子类别、具体位置和位置关系的判断。图1把这三类特征与下游任务连在一起,说明基础模型的复用来自共同表示与不同任务模块的配合。此前BPfold的结构预测积累,也在MUSES数据注释环节形成具体衔接。
这里有两步需要同时成立:数据中要保存序列与配对的对应,训练时也要真正用到这种对应。仅仅拥有结构文件,并不自动改变序列模型的学习;SgMLM把配对关系转化为训练任务的选择规则,使这种关系持续影响核苷酸恢复。MUSES与SgMLM因此分别解决注释规模和学习方式两个相连的问题。
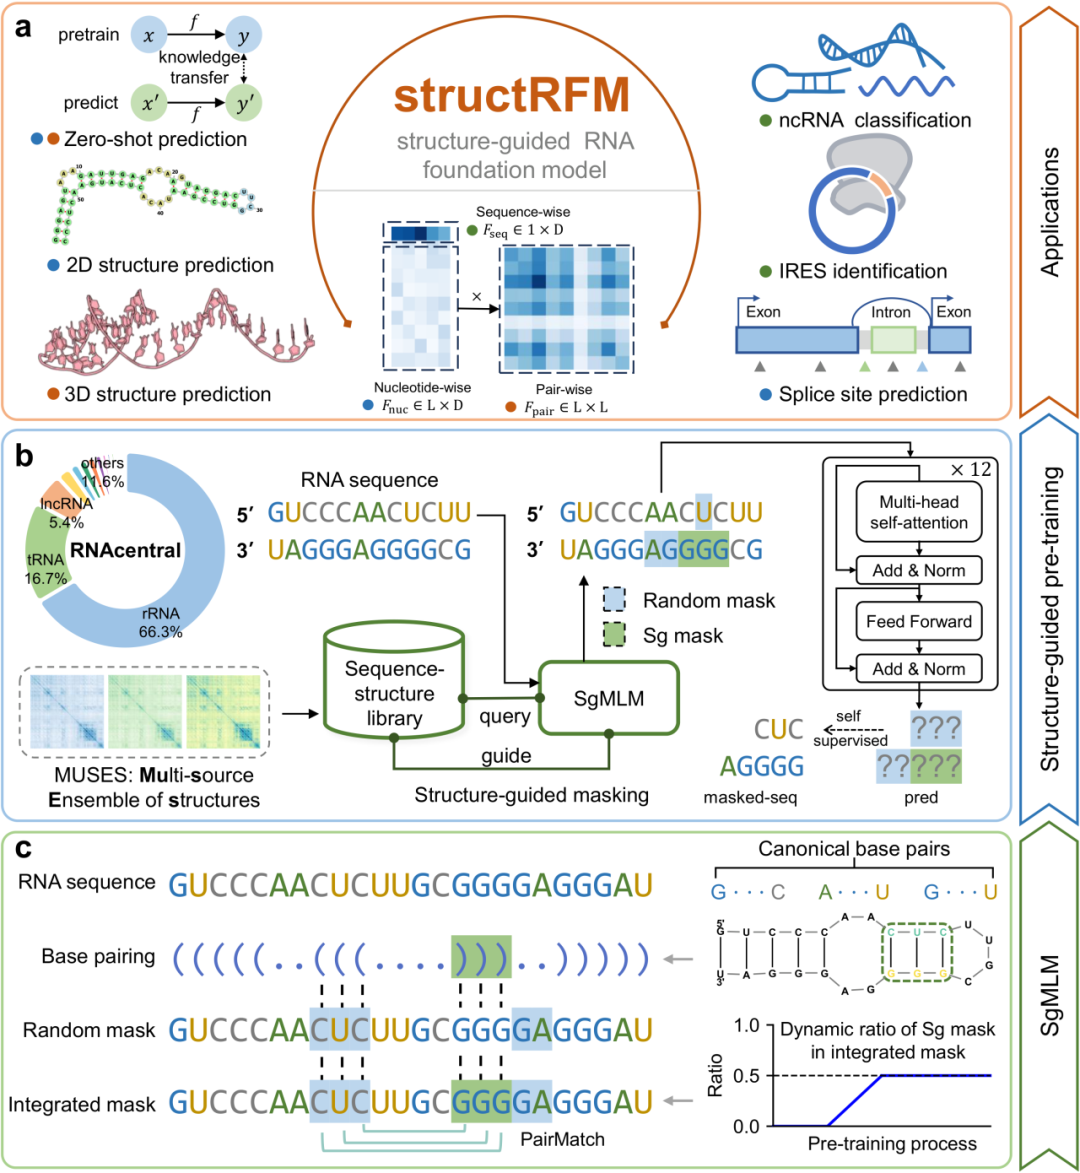
图1|structRFM的训练与任务适配框架:MUSES构建计算注释数据,SgMLM让碱基配对参与掩码,三类特征连接结构与功能任务。
模型内部留下了哪些可观察的证据
图2从整条RNA和核苷酸对两个尺度观察表示。团队抽取覆盖19个家族的23994条RNA,将序列特征用t-SNE投影;预训练模型对家族的区分比随机模型清晰。在成对热图中,部分高响应位置与真实接触图中的配对相对应。这些可视化帮助定位模型学到的生物联系,也为定量评估提供出发点。
同源性测试进一步比较特征能否把相关与无关的RNA分开。研究在Rfam和ArchiveII600中分别抽取同源、非同源序列对,计算特征相似度分布的重叠比例。structRFM的OR约为0.10和0.45,两个基准均进入17个生物语言模型的前四。这个结果来自预训练表示本身,未为同源性任务训练分类器。
在116条PDB RNA的零样本配对测试中,团队检查不同层和注意力头,并扫描阈值。最佳注意力头的INF为0.462,其他头和阈值的表现存在明显差异。图2因此给出两层信息:模型内部确实出现结构信号,而如何读取这些信号同样影响效果;任务微调则在此基础上进一步学习具体的输出规则。
对生物模型的分析也需要跨越不同尺度。序列级特征是否保留家族信息,与成对特征是否反映接触,并不是同一件事。图2分别检查这两类信息,再引入同源性和零样本配对的定量评估,使“结构感知”获得可以观察和比较的依据,而后续任务负责检验这些内部线索能否带来实际收益。
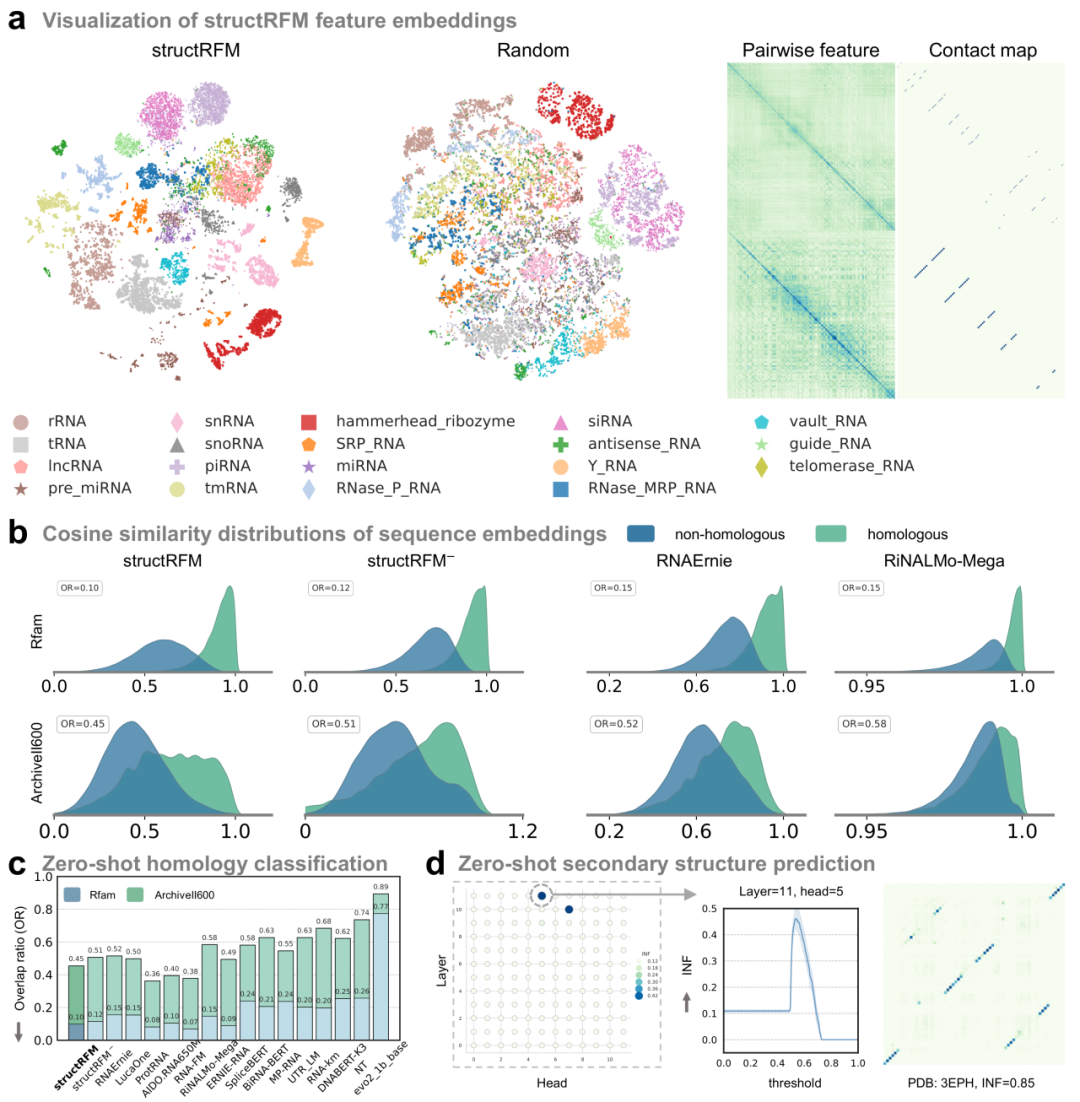
图2|预训练表示与零样本评估:RNA家族分布、成对特征、同源性分布和注意力图,从不同尺度检验模型学习到的关系。
结构引导有没有带来可测量的收益
图3通过结构任务与消融对照检验训练设计。二级预测将核苷酸特征与序列编码连接,经结构模块及动态规划获得配对。在ArchiveII600与bpRNA-TS0上,INF分别为0.890和0.669,比未采用结构引导预训练的对照相对提高4.46%和6.19%。INF关注配对是否与参考一致,将模型收益落实到RNA结构的具体关系上。
图3还按家族拆分结果,并为测试RNA计算与训练数据的最大相似性。结构引导版本在样本数较多的八个家族上取得更高INF,23S rRNA等较长序列仍具挑战;两个基准中的相似性与精度呈弱线性联系。这些分析区分了总体提升、类别差异与数据相近程度,使结果有更清晰的适用范围。
对于三级结构,研究将成对特征接入trRosettaRNA框架,替代原有预测接触图,并保留多序列比对输入。Zfold据此预测几何约束、生成三维构象。基础模型学习到的位置联系,因而可以进入更复杂的空间建模流程,而不仅服务于一个二级结构输出。
图3在CASP15天然RNA、CASP16和RNA-Puzzles上以多种指标检验构象,平均TM-score为0.45、0.33和0.58。模型相对原trRosettaRNA配置和未结构引导对照的改进,与图中代表性三维构象、参考结构及配对图形成对应证据。对于RNA建模,整体形状与碱基配对共同得到检查,比单独报告一种距离指标更有解释力。
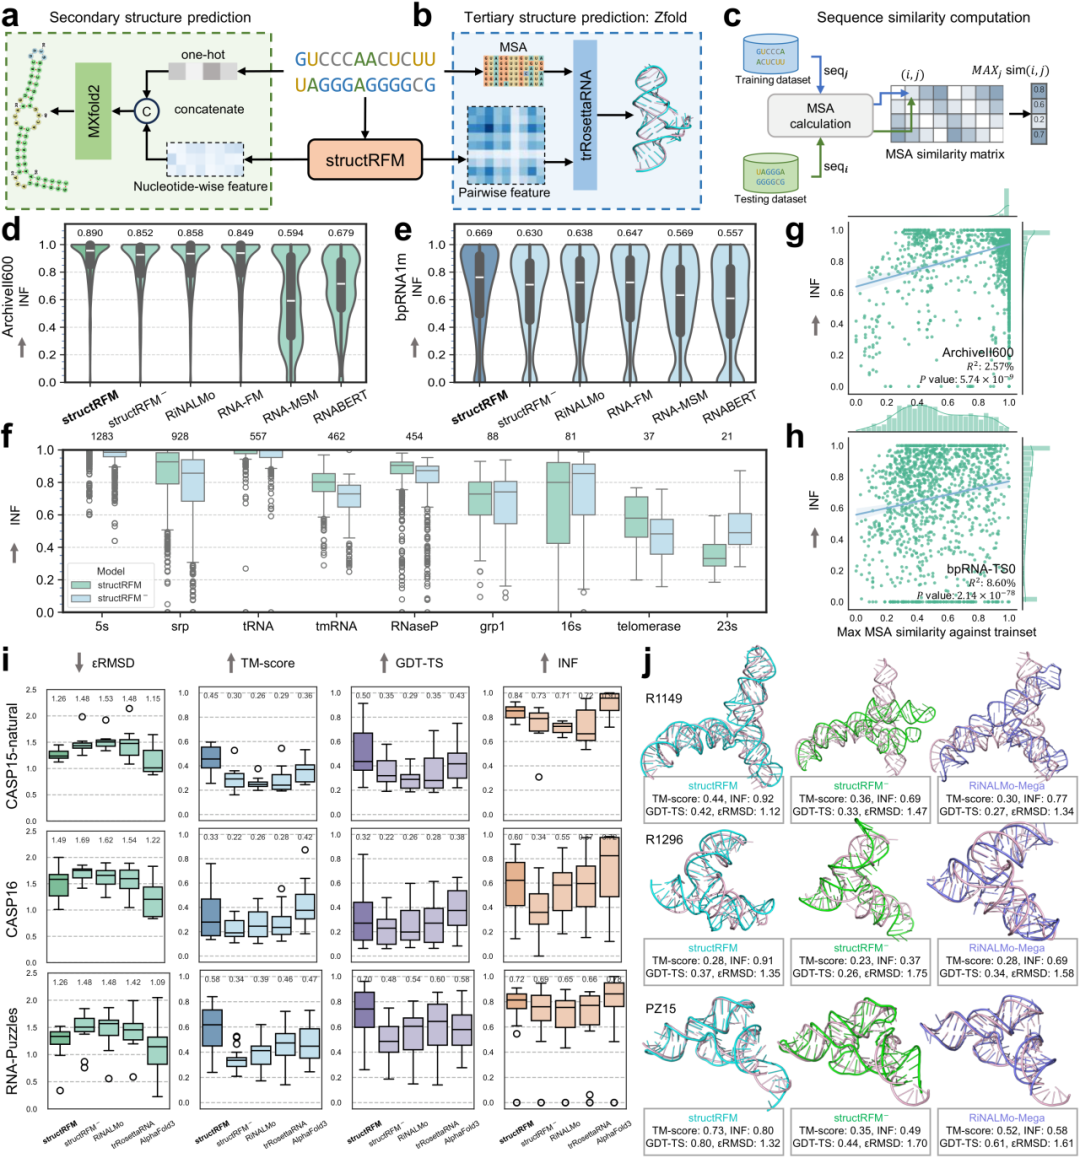
图3|二级与三级结构预测:展示任务架构、总体与分家族结果、训练相似性分析,以及预测构象与参考结构的比较。
评估要继续深入结构质量和新对象
图4先把三维预测的TM-score、配对精度与训练相似性放在一起观察,部分低相似性目标仍有较好的预测。研究还比较直接预测的二级配对,以及从三维构象恢复的配对,检查不同建模途径保留结构信息的情况。这既帮助理解预测结果,也检验基础表示能否在两种结构任务之间复用。
三维模型还需要满足几何与化学约束。图4的缠绕分析显示,多数目标在多数类别上没有缠绕,未检测到打结伪影;立体化学检查同时发现键角和平面性误差较常见。这样的结果指出,学习到整体折叠规律之后,局部构象质量仍有进一步优化空间,物理约束可在后续研究中继续发挥作用。
新对象测试则从预训练后发布的Rfam家族整理436条RNA,两种微调版本的二级结构INF分别为0.648和0.698。图4还比较人和小鼠长非编码RNA分类,重叠窗口策略的F1均超过0.94。类别更新与长度变化分别提出不同的迁移要求,使“基础模型”这一定位有具体任务支撑。
结构质量检查对后续研究尤其有用。一个构象可以用于提出相互作用假设、比较不同区域的组织方式,也可能成为更精细计算的起点;不同用途要求不同的可靠程度。将配对、整体折叠、缠绕和局部化学分别检查,可以帮助研究者选择合适的使用方式,也为继续改进模型提供更具体的目标。
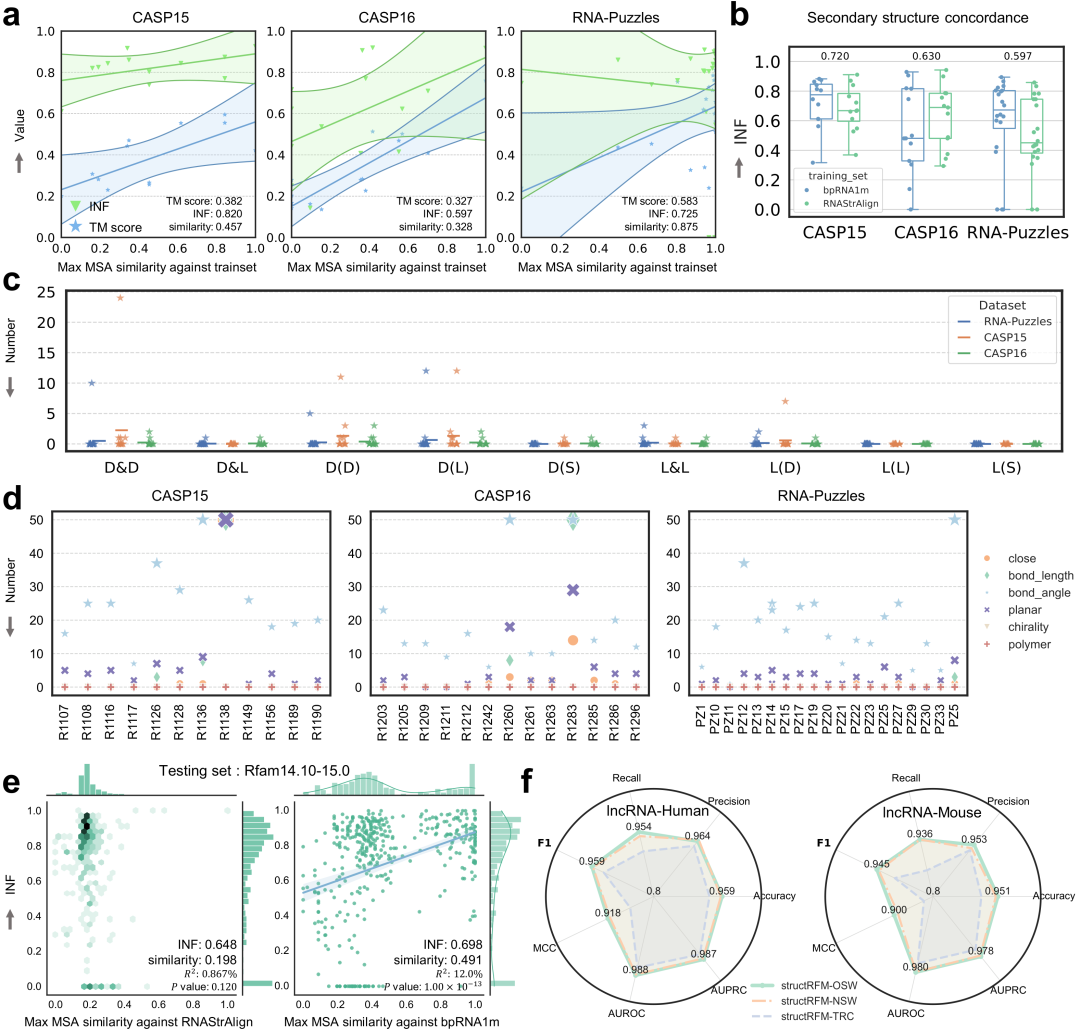
图4|结构质量与适用范围:分析训练相似性、二级与三级结构的配对表现、缠绕及立体化学,并测试新家族和长非编码RNA。
让共同表示连接不同生物过程
图5检验结构引导学习能否支持功能相关推断。剪接位点任务逐位置识别供体与受体,关联前体RNA加工;IRES任务判断是否含有介导非帽依赖翻译起始的元件;非编码RNA任务区分分子类别。模型根据问题使用核苷酸特征或序列特征,通过任务微调得到相应输出。
structRFM的剪接位点平均top-k accuracy为0.416,IRES识别F1为0.701,13类非编码RNA分类F1为0.979。图5还给出逐位置预测响应、IRES的PR与ROC曲线及各非编码RNA类别的F1:既检查总体性能,也观察不同位置、判断阈值和类别上的表现。结构线索因此在标签形式与生物对象都不同的任务中得到检验。
对IRES和非编码RNA测试,预测置信度与训练相似性的线性联系都较弱,补充了跨任务复用的证据。图5同时比较超过512个核苷酸时的处理方式:截断只保留开头,窗口覆盖整条序列,50%重叠窗口额外保留边界上下文。这解释了图4中长RNA分类的提升,也展示了根据任务特点扩展基础编码器用途的方法。
窗口适配也体现了基础表示与任务设计之间的分工。RNA较长时,截断会遗漏后半段;无重叠分段覆盖全序列,却可能割开有意义的局部片段。重叠窗口让边界附近的信息在相邻输入中再次出现,再汇总各段表示完成分类。这样的实验说明,输入处理方式会影响已有模型的可用范围,需要和网络本身一起检验。
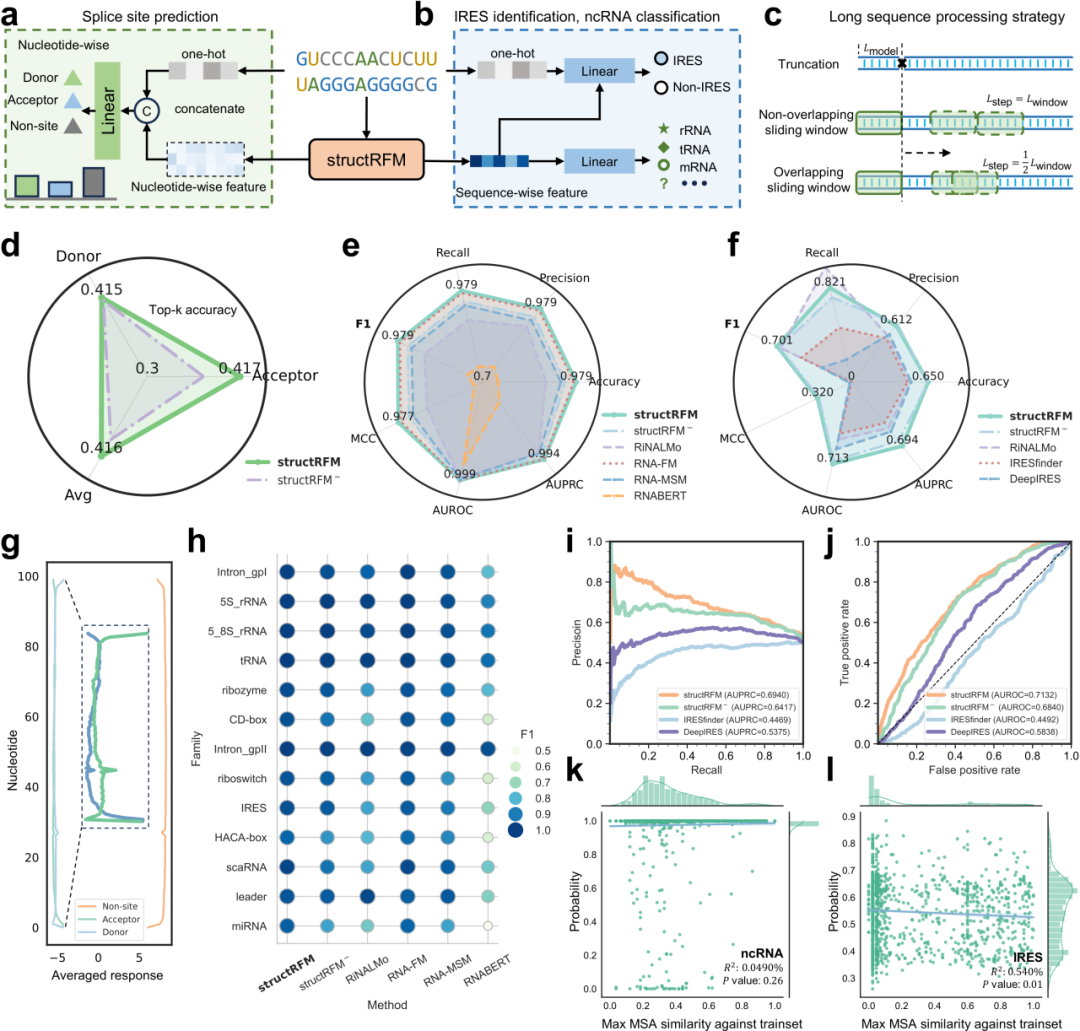
图5|功能任务与长序列处理:展示剪接位点、IRES、非编码RNA分类、预测相似性分析,以及三种序列分段策略。
从RNA关系出发,走向多模态生物学习
从BPfold到structRFM,持续的研究线索是如何让分子结构成为模型学习的有效信息。未来可以进一步连接三维构象、相互作用、功能注释和自然语言,并通过任务反馈检验新增信息。更广泛的多模态生物基础模型,需要在这种数据、训练与生物问题的对应中逐步建立。
参考资料
Zhu, H., Li, R., Chang, A. et al. An open structure-guided RNA foundation model for generalizable prediction. Nature (2026).
https://doi.org/10.1038/s41586-026-11210-2
代码与模型:https://github.com/heqin-zhu/structRFM
关于作者
朱河勤,2026年获中国科学技术大学生物医学工程博士学位,structRFM独立第一作者。研究聚焦生物基础模型、分子结构与功能预测及核酸设计,相关工作包括结构预测BPfold(Nature Communications)、NC-Bench/NCfold(ICLR 2026)和核酸设计NACraft。目前关注连接序列、结构、功能与相互作用,发展面向分子理解和设计的多模态生物基础模型。个人主页:https://heqin-zhu.github.io/
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢