

---------------------
课程 | 2026年斯坦福CS 329Z《Agent工程》| 第3讲:检索增强生成(RAG)
课程 | 2026年斯坦福CS 329Z《Agent工程》| 第2讲:给开发者的LLM原理
课程 | 2026年斯坦福CS 329Z《Agent工程课》| 第1讲:智能体系统入门
---------------------
这是「斯坦福 Agent 工程课」系列的第 4 篇。课程是 Stanford 2026 年秋季的 CS 329Z《Engineering AI Agents》,讲师是 Diyi Yang、Michael Ryan 和 John Yang。课件在课程官网公开,我每讲写一篇,按课件逐页讲,一页不跳。
第 4 讲在官网课表上是 10 月 5 日,课表标题是「Tool Use & Function Calling」,课件封面写的是 Tool Use,主讲是 Diyi Yang,一共 68 页。课件右下角印的页码从第 14 页起和 PDF 对不上,本文的页码一律按 PDF 算。
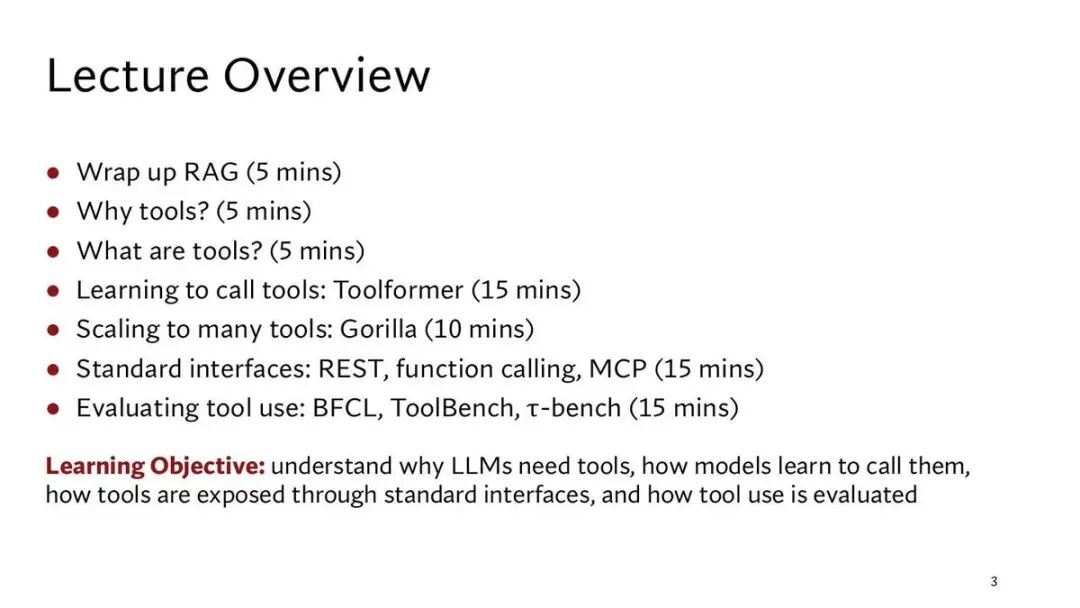
这一讲要回答的问题,写在第 3 页的学习目标里:语言模型为什么需要工具,模型怎样学会调用工具,工具怎样通过标准接口暴露给模型,工具使用又该怎样评估。
下面是这一讲的大纲,一共七块:收尾上一讲的 RAG,为什么要工具,什么是工具,学会调用工具(Toolformer),扩展到大量工具(Gorilla),标准接口(REST,函数调用,MCP),评估工具使用(BFCL,ToolBench,τ-bench)。每块后面的括号是课上分给它的分钟数。后文按这个顺序走。
开场
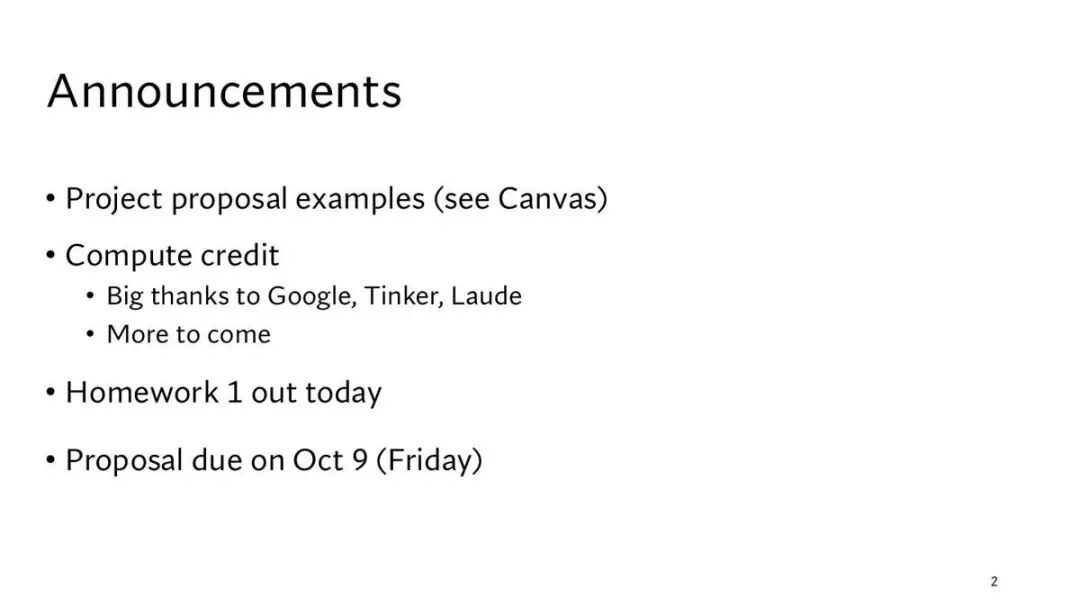
开场是封面和课程通知:作业 1 在这一讲当天发布,项目开题报告 10 月 9 日截止。
第 1 页是封面,课程名下面是这一讲的标题 Tool Use,讲师一栏只有 Diyi Yang。封面页没有别的信息,并进这里一起讲。
第 2 页是通知,四条。项目开题报告的范例放在 Canvas 上。算力额度方面,感谢 Google,Tinker 和 Laude 提供,后面还会有更多。作业 1 当天发布。开题报告 10 月 9 日(周五)截止。
补充Canvas 是斯坦福用的课程管理平台,作业和资料在上面发布。据课程官网课表,作业 1 的仓库是 https://github.com/cs329z/assignment1-harness
第 3 页是大纲,已经放在本文开头。
一、收尾 RAG
上一讲最后列了 RAG 的九种问题,这一讲开头接着讲其中两种:模型用不好放在长上下文中间的文档,模型给出的引用也可能是编的。
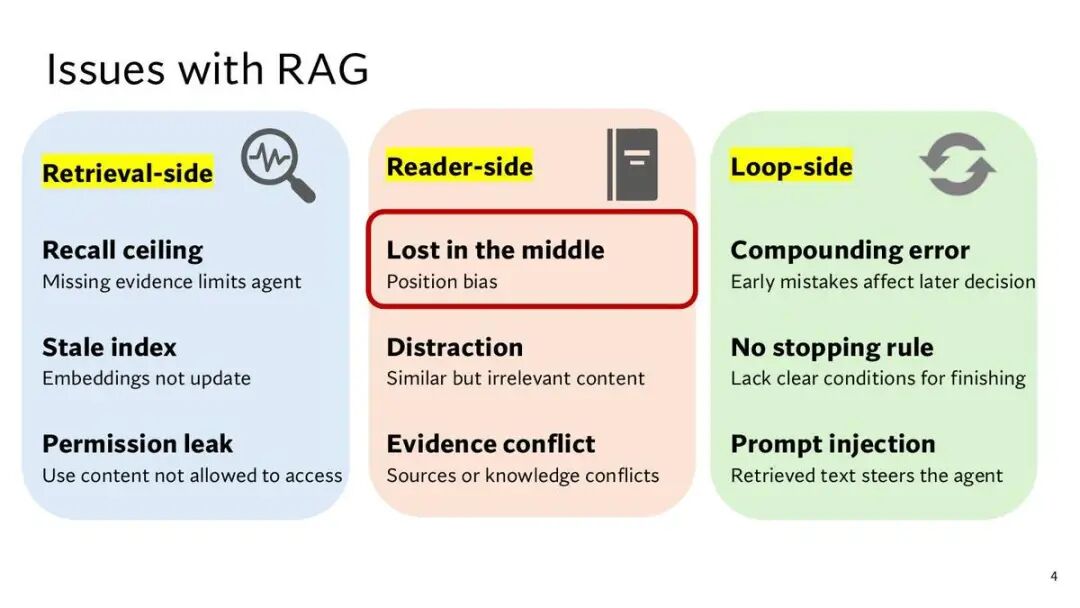
第 4 页就是上一讲结尾那张三栏图,把 RAG 的问题按出在哪里分成三侧,每侧三条。
检索侧:召回有上限,缺的证据会限制 agent;索引过期,向量没有跟着内容更新;权限泄漏,用到了不该访问的内容。
阅读侧,也就是读检索结果的模型那一侧:迷失在中间,模型对位置有偏好;干扰,内容相似但其实无关;证据冲突,来源之间或来源和模型自己的知识之间对不上。
循环侧,也就是 agent 反复检索,推理的那个循环:错误累积,前面的错会影响后面的决定;没有停止规则,缺少明确的结束条件;提示注入,检索回来的文字反过来操纵 agent。
这一页用红框圈出了「迷失在中间」,接下来几页讲的就是它。
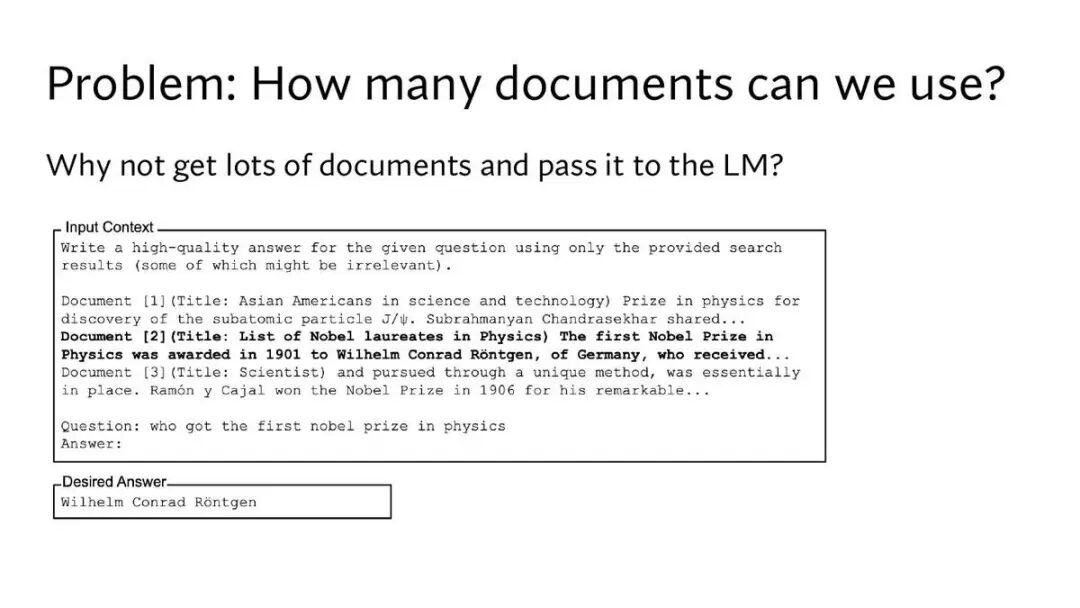
第 5 页提的问题是:一次能用多少篇文档?为什么不多检索一些,一股脑交给模型?
页面上是一个输入的例子。指令要求只根据给出的搜索结果回答,并提醒其中有些结果可能无关。下面是三篇文档,只有加粗的第 2 篇「诺贝尔物理学奖得主列表」里有答案:第一届诺贝尔物理学奖在 1901 年颁给了德国的伦琴。问题是「谁获得了第一届诺贝尔物理学奖」,期望的答案是 Wilhelm Conrad Röntgen。
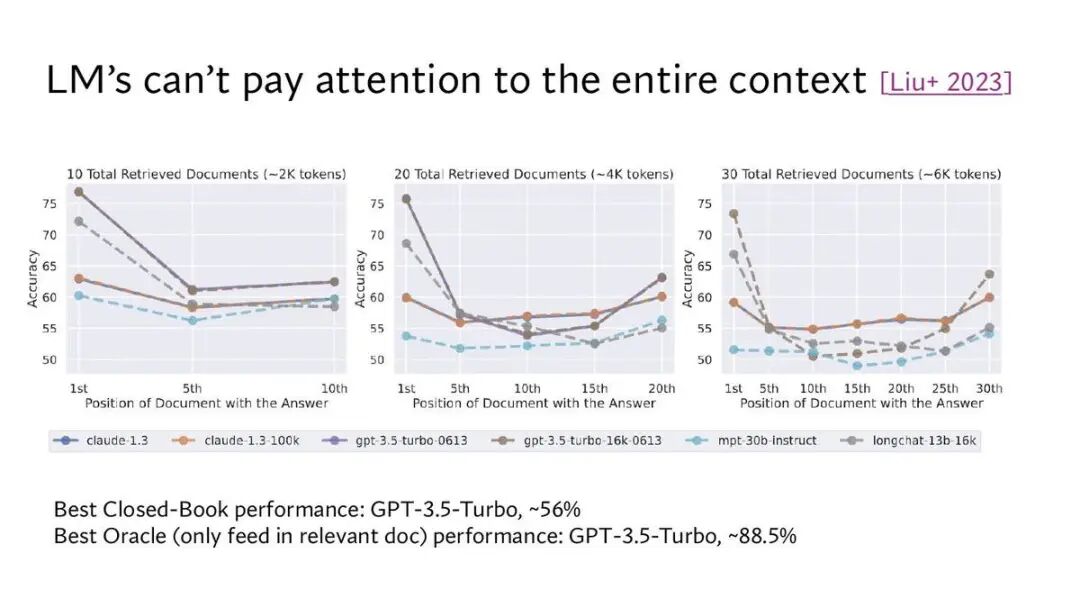
第 6 页的标题是:语言模型没法关注到整个上下文,出处标的是 Liu 等人 2023 年的论文。
三张图分别给模型 10 篇,20 篇,30 篇检索文档,大约对应 2K,4K,6K 个 token。横轴是含答案的那篇文档放在第几位,纵轴是准确率。测了六个模型:claude-1.3,claude-1.3-100k,gpt-3.5-turbo-0613,gpt-3.5-turbo-16k-0613,mpt-30b-instruct,longchat-13b-16k。
多数曲线两头高,中间低:答案放在最前或最后时准确率高,放在中间时掉下去。
图下写了两个参照数字。闭卷,也就是不给任何文档时,最好的是 GPT-3.5-Turbo,约 56%。只给那一篇相关文档时,最好的也是 GPT-3.5-Turbo,约 88.5%。
补充Liu 等人这篇论文的题目是《Lost in the Middle: How Language Models Use Long Contexts》,「迷失在中间」这个说法就出自这里。
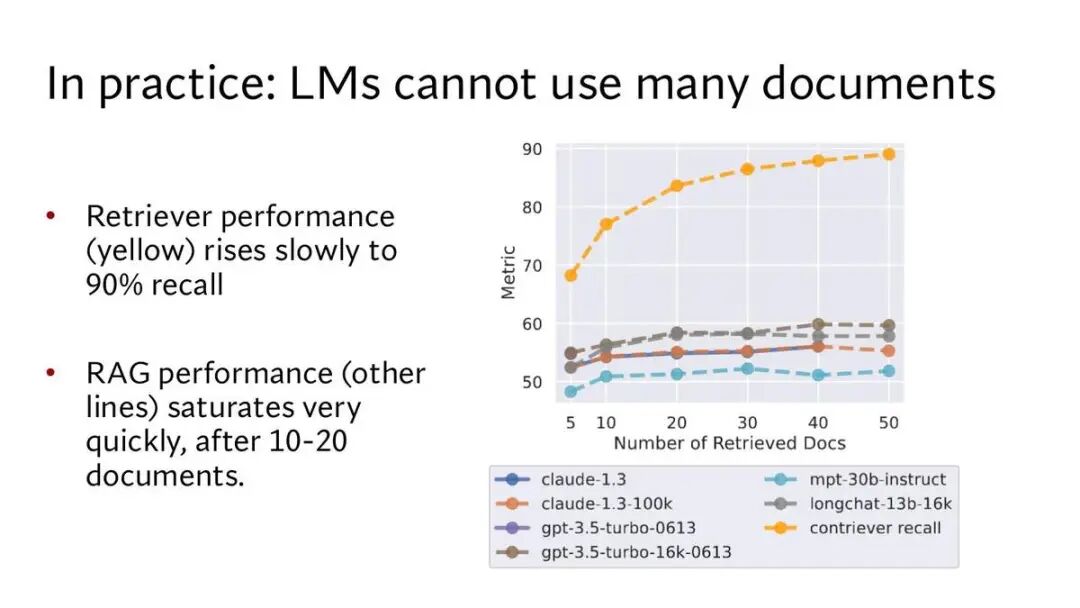
第 7 页的标题是:实际中,模型用不了很多文档。
横轴是检索的文档数,从 5 篇到 50 篇。黄色虚线是检索器 Contriever 的召回率,文档越多,召回越高,课件的说法是「慢慢升到 90%」。其余几条线是各模型拿这些文档做 RAG 的效果,课件的说法是在 10 到 20 篇之后很快就饱和了。
也就是说,多给文档能让答案更可能出现在上下文里,但模型的表现没有跟着涨。
补充Contriever 是 Meta 在 2021 年提出的一种向量检索器,训练时不需要人工标注的问答对。
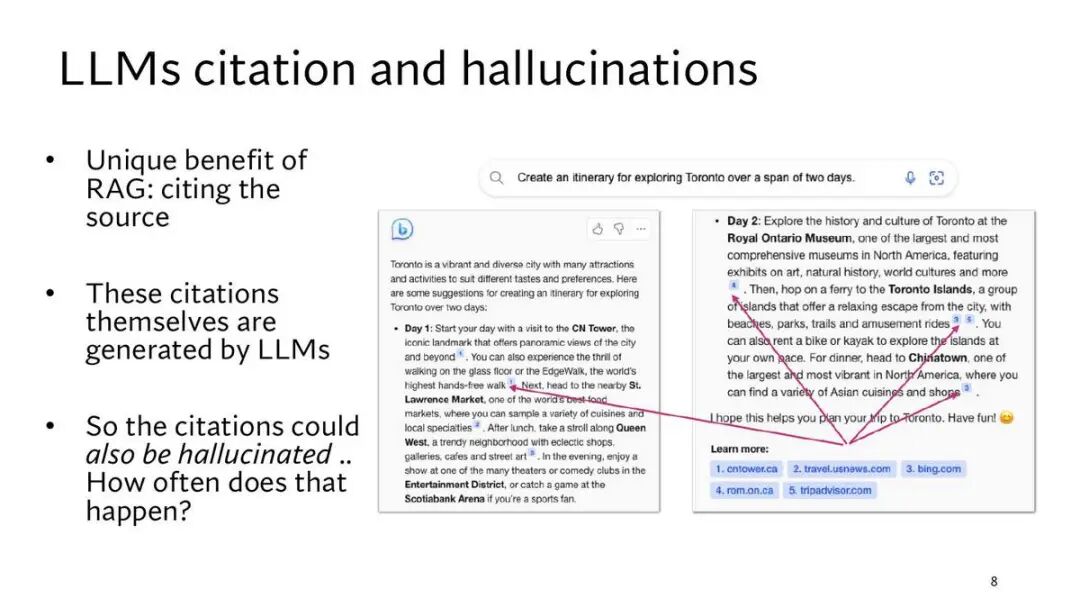
第 8 页转到第二个问题:引用和幻觉。
左边三句话。RAG 独有的好处是能标出处。但这些引用本身也是模型生成的。所以引用也可能是编的,这种情况有多常见?
右边是一个生成式搜索引擎的截图:用户让它排一个两天的多伦多行程,回答里带着角标,底下列出 cntower.ca,travel.usnews.com,bing.com,rom.on.ca,tripadvisor.com 五个来源,红色箭头把正文里的角标连到这些来源上。
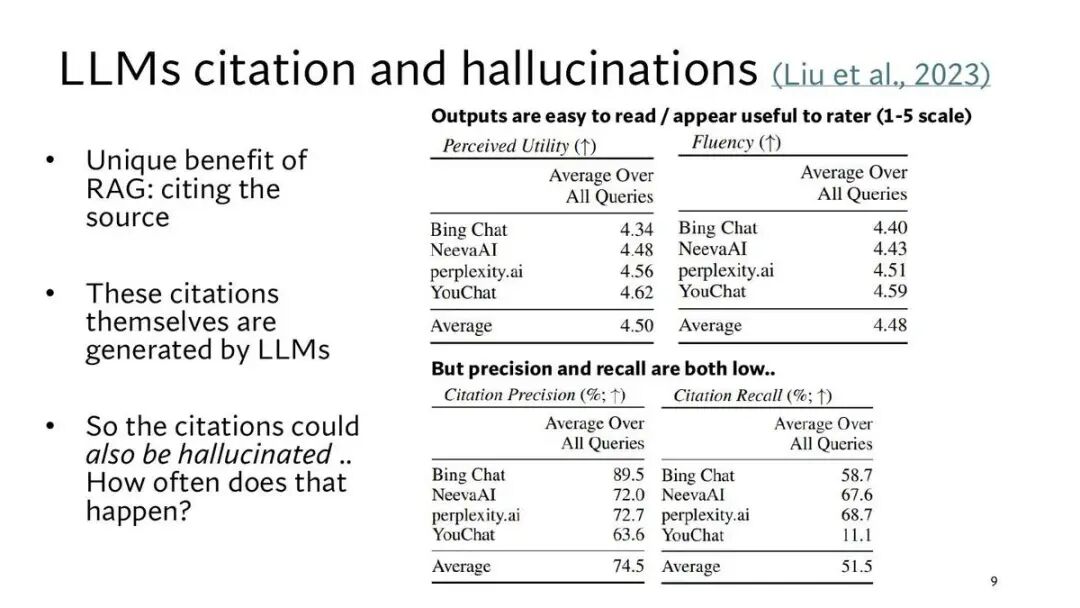
第 9 页给了数字,出处是 Liu 等人 2023 年的另一篇论文。评测对象是四个生成式搜索引擎:Bing Chat,NeevaAI,perplexity.ai,YouChat。
上面两张表是人评分,1 到 5 分。「看起来有用」平均 4.50,「流畅」平均 4.48,四家都在 4.3 以上。课件的概括是:输出好读,评分人觉得有用。
下面两张表是引用的质量,课件的概括是:精确率和召回率都低。引用精确率指的是给出的引用里,真能支撑那句话的占多少,平均 74.5%,Bing Chat 最高,89.5%,YouChat 最低,63.6%。引用召回率指的是需要引用的句子里,真有引用支撑的占多少,平均 51.5%,YouChat 只有 11.1%。
补充这篇论文是《Evaluating Verifiability in Generative Search Engines》,第一作者 Nelson F. Liu 和第 6 页《Lost in the Middle》的第一作者是同一人。
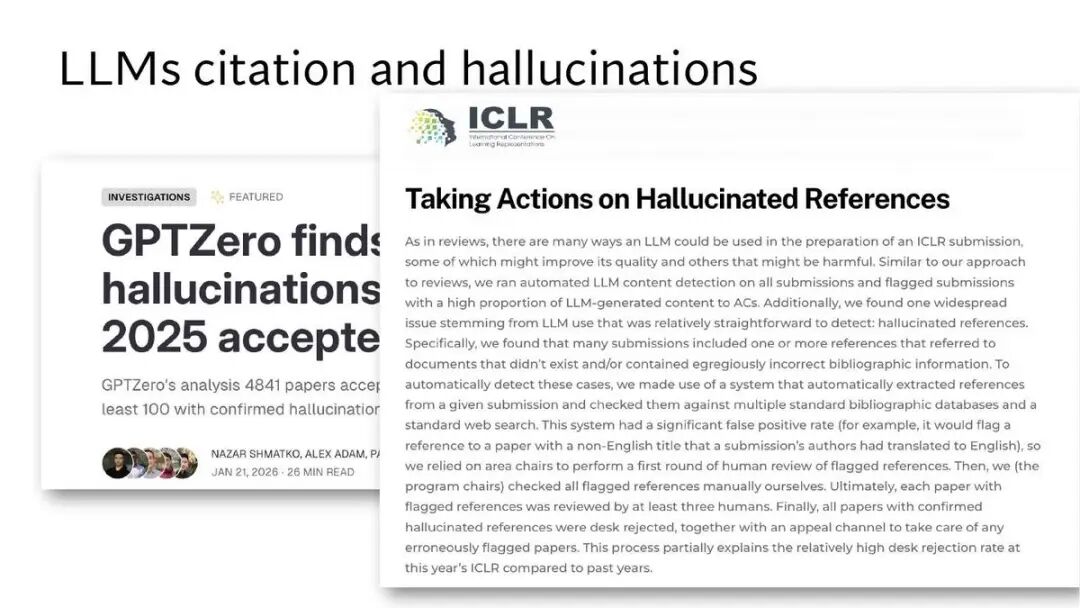
第 10 页是两张截图,讲引用幻觉在学术圈已经成了真问题。
左边被遮住一半的是 GPTZero 2026 年 1 月 21 日的一篇调查文章,能看到的部分写着它分析了 4841 篇被接收的论文,其中至少 100 篇有确认的幻觉引用。
右边是 ICLR 的说明「Taking Actions on Hallucinated References」。大意是:ICLR 对所有投稿做了 LLM 生成内容的自动检测;同时发现一个普遍问题,很多投稿引用了不存在的文献,或者文献信息错得离谱。他们用一个系统自动抽出参考文献,拿去和多个文献数据库以及网页搜索比对。这个系统误报率很高,所以先由领域主席人工过一轮,再由程序主席把所有被标记的引用亲自核一遍,每篇论文至少经过三个人看。确认有幻觉引用的论文被直接拒稿,同时开了申诉渠道。说明里还写,这在一定程度上解释了今年 ICLR 直接拒稿率比往年高。
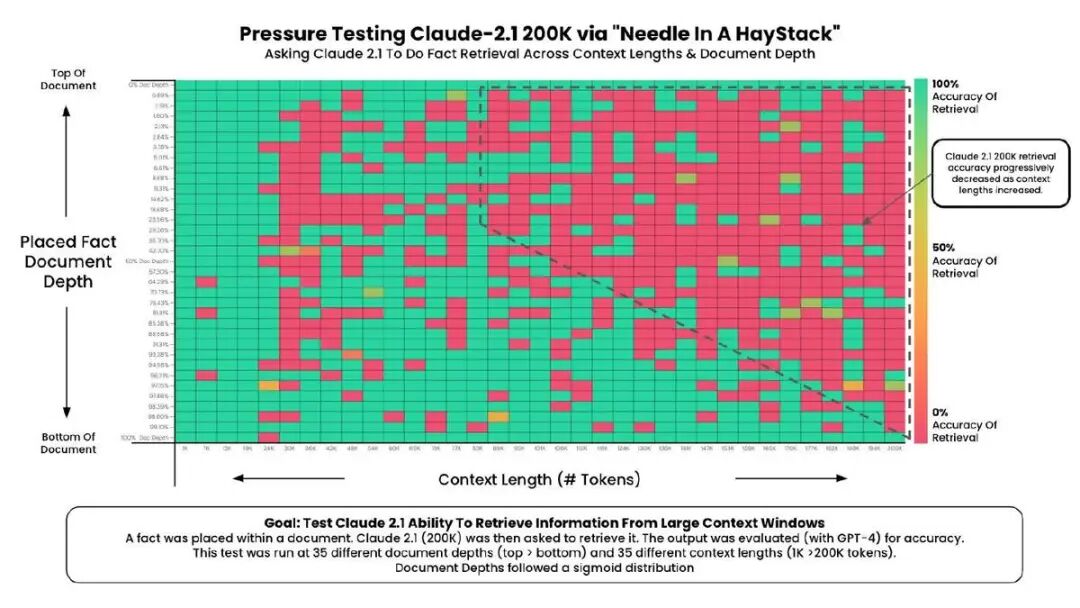
第 11 页回到长上下文,是「大海捞针」测试在 Claude 2.1 上的结果。
做法是在一篇文档里藏一句事实,再让 Claude 2.1 把它找出来,用 GPT-4 判对错。横轴是上下文长度,从 1K 到 200K token,测了 35 档;纵轴是这句事实藏在文档里的深度,从顶部到底部,也是 35 档。绿色是找对,红色是找错。
图里的标注写着:随着上下文变长,Claude 2.1 200K 的检索准确率逐渐下降。
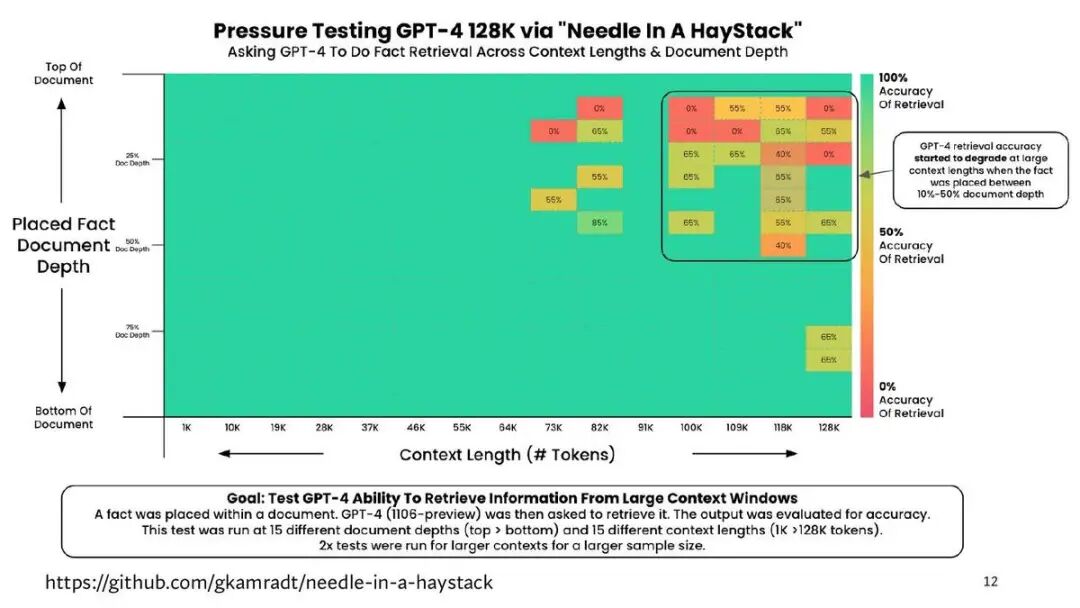
第 12 页是同一个测试在 GPT-4 128K 上的结果,上下文长度从 1K 到 128K,测了 15 档,深度也是 15 档,更长的上下文多跑了一倍次数。
这张图大部分是绿色。标注写着:上下文很长,而事实放在文档 10% 到 50% 深度之间时,GPT-4 的检索准确率开始下降。页底给了测试代码的仓库:https://github.com/gkamradt/needle-in-a-haystack
补充「大海捞针」(Needle In A Haystack)是 Greg Kamradt 在 2023 年做的一个公开测试,用来看长上下文模型能不能在很长的文本里找到一句特定的话。
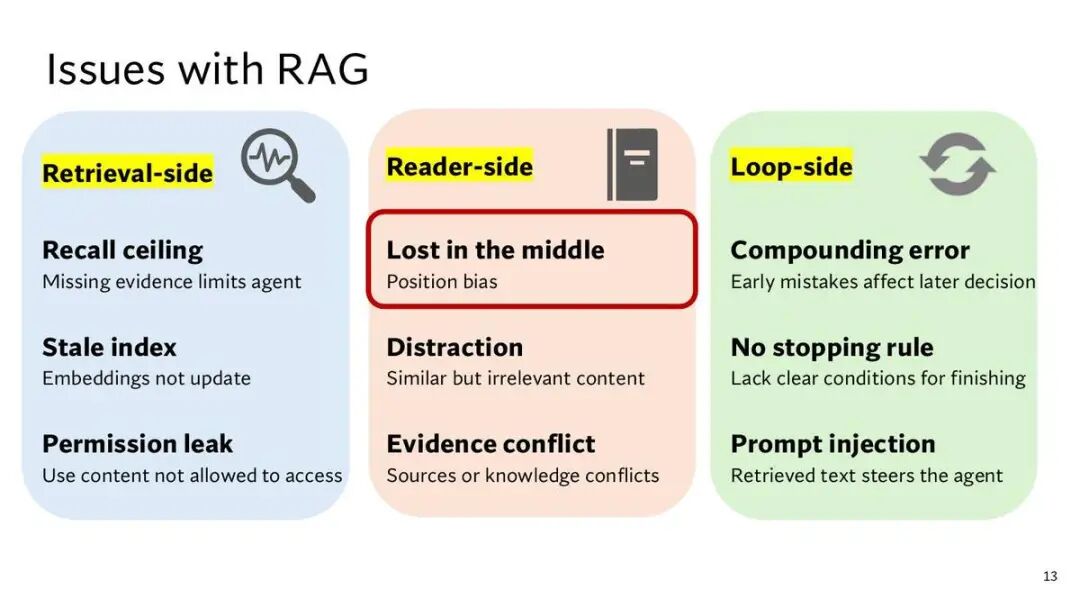
第 13 页把第 4 页那张三栏图又放了一次,红框还是在「迷失在中间」上,RAG 的部分到这里结束。
二、为什么要工具
有些事模型自己算不了,有些东西训练时没见过,有些地方它够不着,工具补的就是这三块。
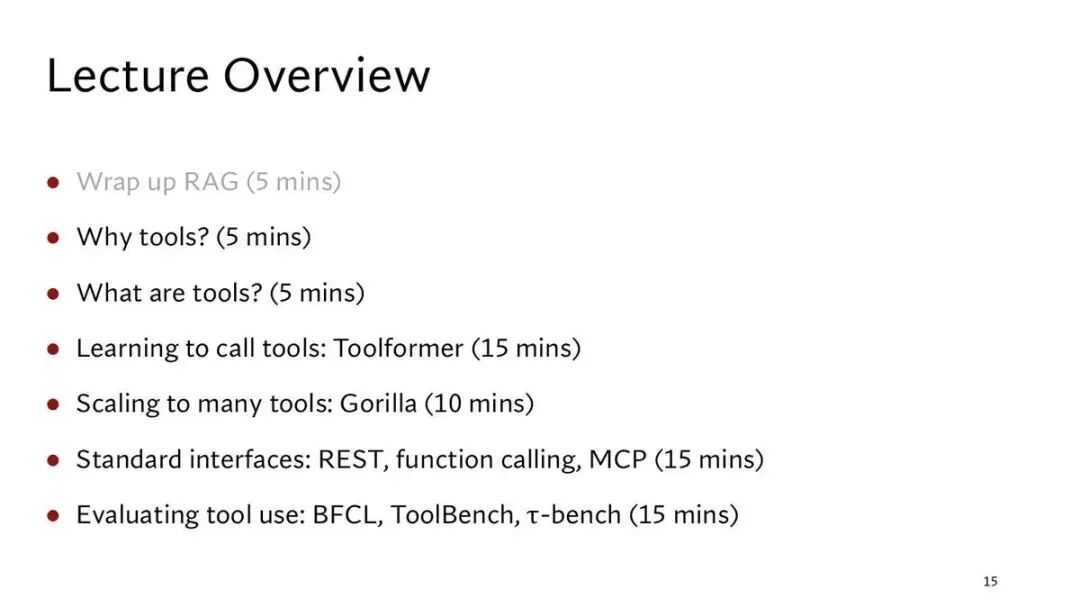
第 14 页是大纲,「收尾 RAG」变灰,进入「为什么要工具」。
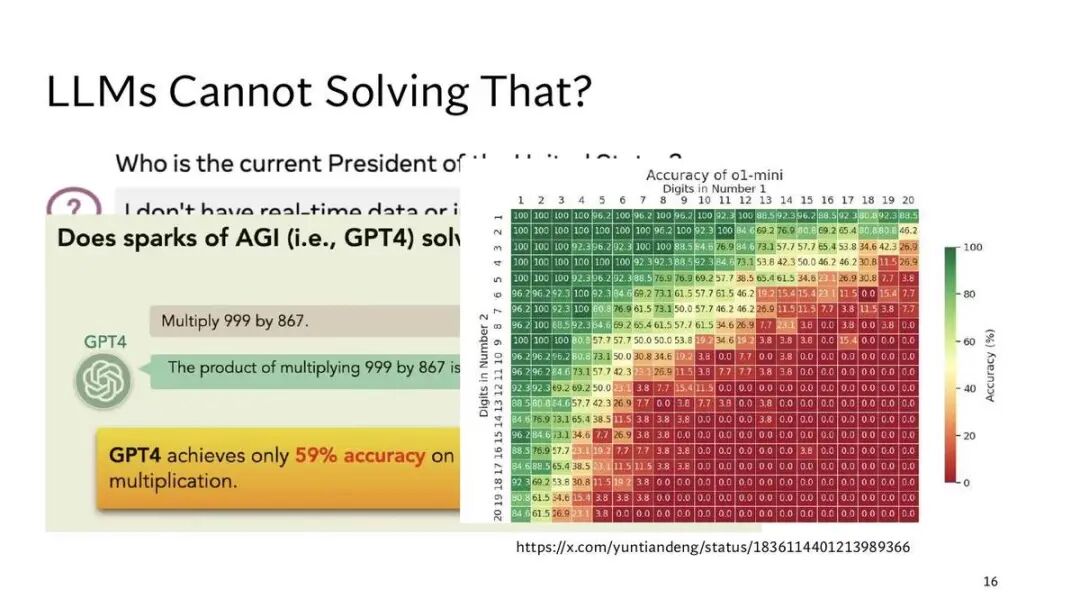
第 15 页的标题是「LLMs Cannot Solving That?」,几张截图叠在一起。
最底下一张能看到的部分是有人问「现在的美国总统是谁」,模型回答自己没有实时数据。中间一张问「火花般的 AGI(也就是 GPT-4)能解决吗」,例子是「999 乘以 867」,下面黄框写着:GPT-4 的乘法准确率只有 59%。
最上面是一张热力图,标题是「o1-mini 的准确率」,两个坐标轴分别是两个乘数的位数,从 1 位到 20 位。左上角位数少的地方全是 100%,往右下走越来越红,两个数都在十几位以上时基本是 0%。来源是页底的 X 帖子:https://x.com/yuntiandeng/status/1836114401213989366
补充「Sparks of AGI」指微软研究院 2023 年的论文《Sparks of Artificial General Intelligence: Early experiments with GPT-4》。o1-mini 是 OpenAI 2024 年 9 月发布的推理模型。
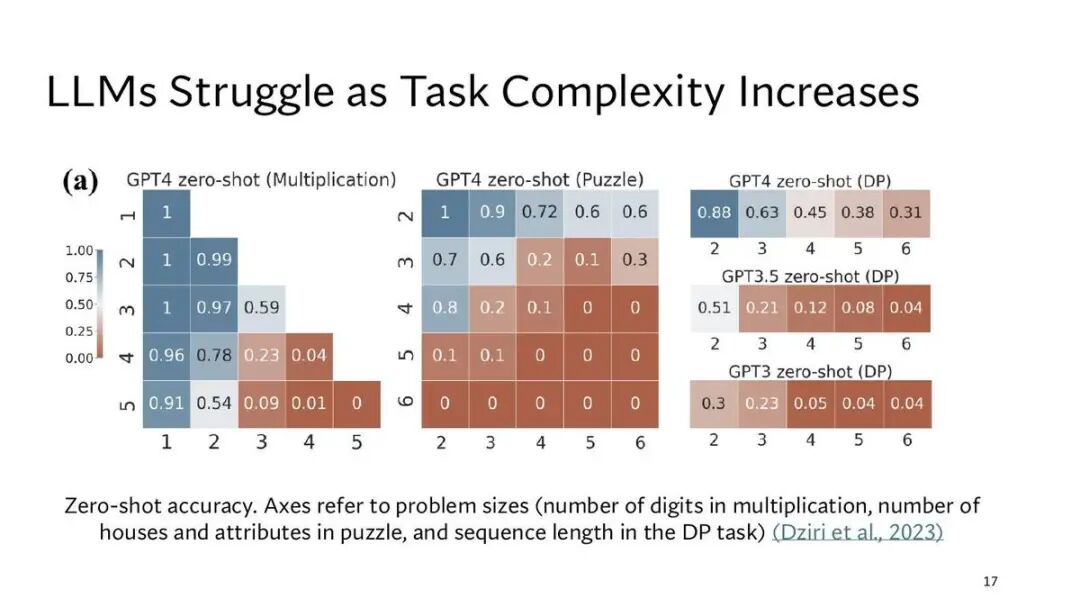
第 16 页的标题是:任务越复杂,模型越吃力。出处是 Dziri 等人 2023 年的论文,三张热力图都是零样本准确率。
第一张是 GPT-4 做乘法,两个坐标轴是两个乘数的位数。1 位乘 1 位是 1,也就是全对;4 位乘 4 位是 0.04;5 位乘 5 位是 0。
第二张是 GPT-4 解逻辑谜题,坐标轴是房子数和属性数。2 座房子,2 种属性时是 1;到 6 座房子时,各种属性数下都是 0。
第三张是动态规划题,横轴是序列长度,从 2 到 6。GPT-4 从 0.88 降到 0.31,GPT-3.5 从 0.51 降到 0.04,GPT-3 从 0.3 降到 0.04。
补充这篇论文是《Faith and Fate: Limits of Transformers on Compositionality》,NeurIPS 2023。逻辑谜题指爱因斯坦谜题那一类:几座房子,每座有几种属性,根据一组线索推出谁住哪座。
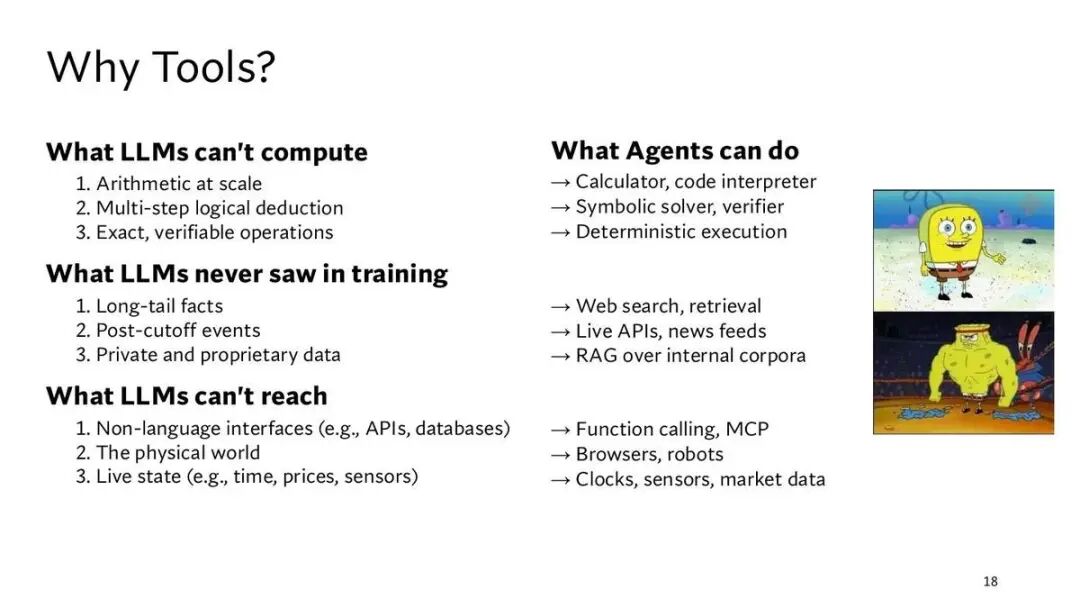
第 17 页回答「为什么要工具」,左边是模型做不到的三类事,每类三条,右边是 agent 能用来补上的东西。
模型算不了的:大规模的算术,配计算器和代码解释器;多步逻辑推导,配符号求解器和验证器;精确,可验证的操作,配确定性的执行。
模型训练时没见过的:长尾事实,配网页搜索和检索;训练截止之后的事,配实时 API 和新闻源;私有和专有数据,配在内部语料上做 RAG。
模型够不着的:非语言的接口,比如 API 和数据库,配函数调用和 MCP;物理世界,配浏览器和机器人;实时状态,比如时间,价格,传感器读数,配时钟,传感器和行情数据。
页面右侧配了一张海绵宝宝的梗图,上面瘦弱,下面肌肉发达。
三、什么是工具
工具是一段在模型之外运行的程序,模型负责写出调用哪个函数,传什么参数。
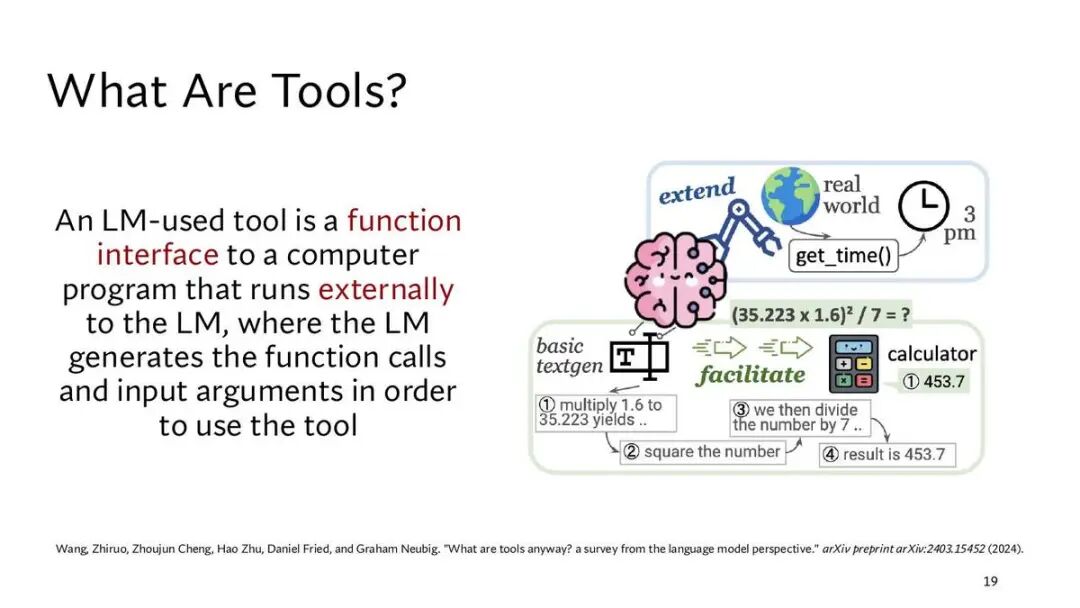
第 18 页给了定义,出自 Wang 等人 2024 年的综述《What are tools anyway? A survey from the language model perspective》:语言模型使用的工具,是一个通往计算机程序的函数接口,这个程序在模型外部运行,由模型生成函数调用和输入参数来使用它。
右边的图把工具的作用分成两种。上面是「延伸」:模型通过 get_time() 拿到现实世界的时间,下午 3 点。下面是「辅助」:要算 (35.223 × 1.6)² / 7,模型只生成文字时要一步步写「1.6 乘 35.223 得……,再平方,再除以 7」;调用计算器则直接得到 453.7。
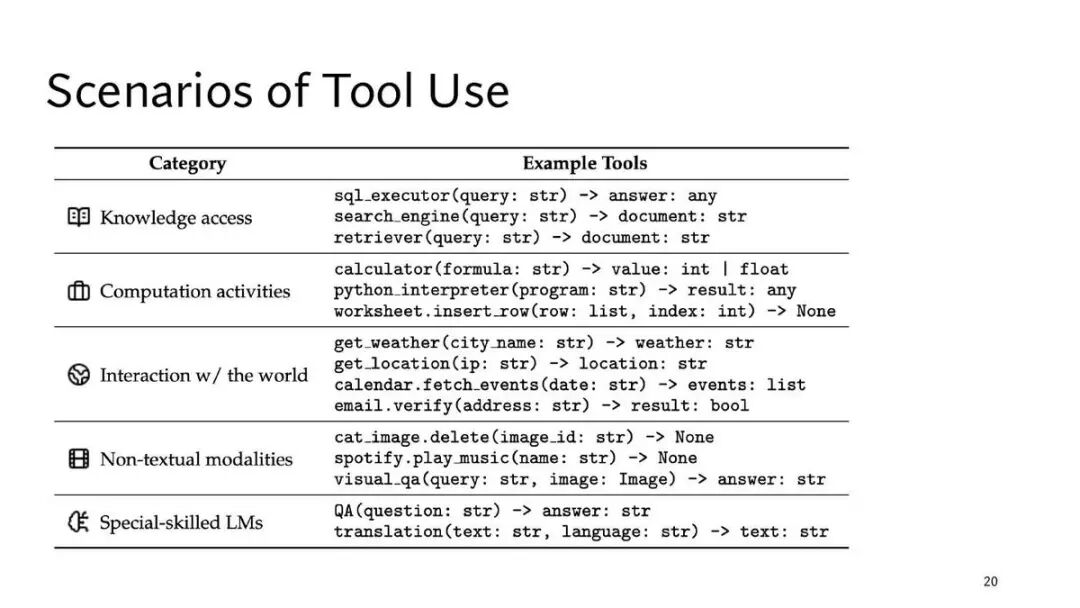
第 19 页是一张表,把工具按场景分成五类,每类给了几个函数签名的例子。
知识获取:sql_executor(执行 SQL 查询),search_engine(搜索),retriever(检索)。
计算:calculator(计算器),python_interpreter(Python 解释器),worksheet.insert_row(往表格里插一行)。
和外部世界交互:get_weather(查天气),get_location(按 IP 查位置),calendar.fetch_events(查日历事件),email.verify(验证邮箱地址)。
非文本模态:cat_image.delete(删一张图),spotify.play_music(放音乐),visual_qa(看图回答问题)。
有专门技能的模型:QA(问答),translation(翻译)。
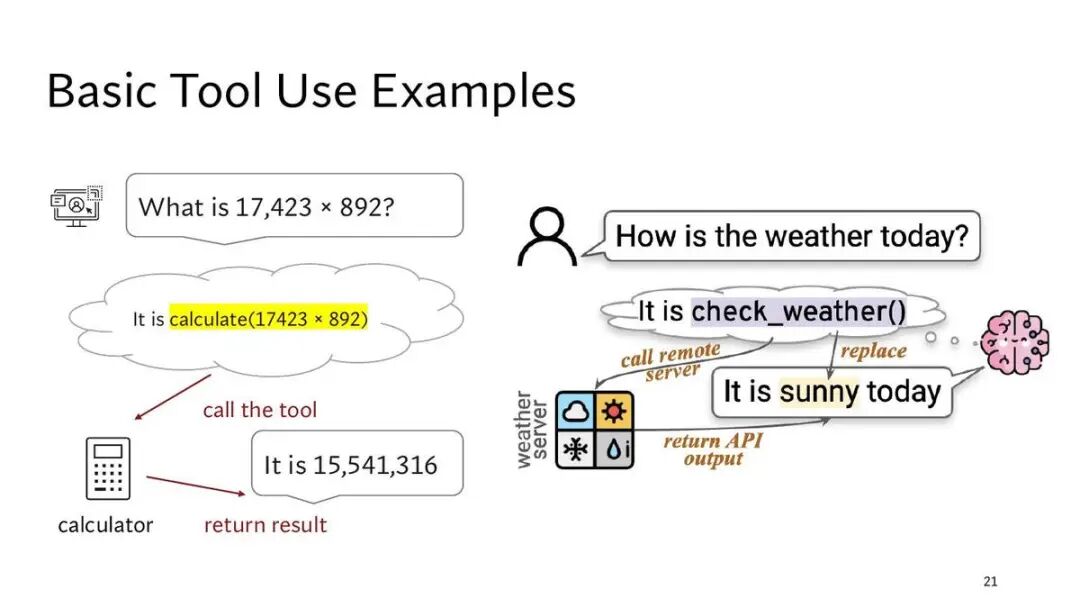
第 20 页是两个基本例子。
左边:用户问 17,423 × 892 等于多少。模型不自己算,生成「It is calculate(17423 × 892)」,调用计算器,计算器返回结果,模型回答 15,541,316。
右边:用户问今天天气怎样。模型生成「It is check_weather()」,去调用远程的天气服务器,服务器返回结果,模型用结果替换掉调用,回答「今天是晴天」。
四、学会调用工具:Toolformer
Toolformer 让模型自己给训练文本加上工具调用,只留下真能帮它预测后文的那些,再拿这份数据微调;ToolkenGPT 换了个思路,把每个工具当成一个新词。
第 21 页是大纲,前三项变灰,进入「学会调用工具:Toolformer」。
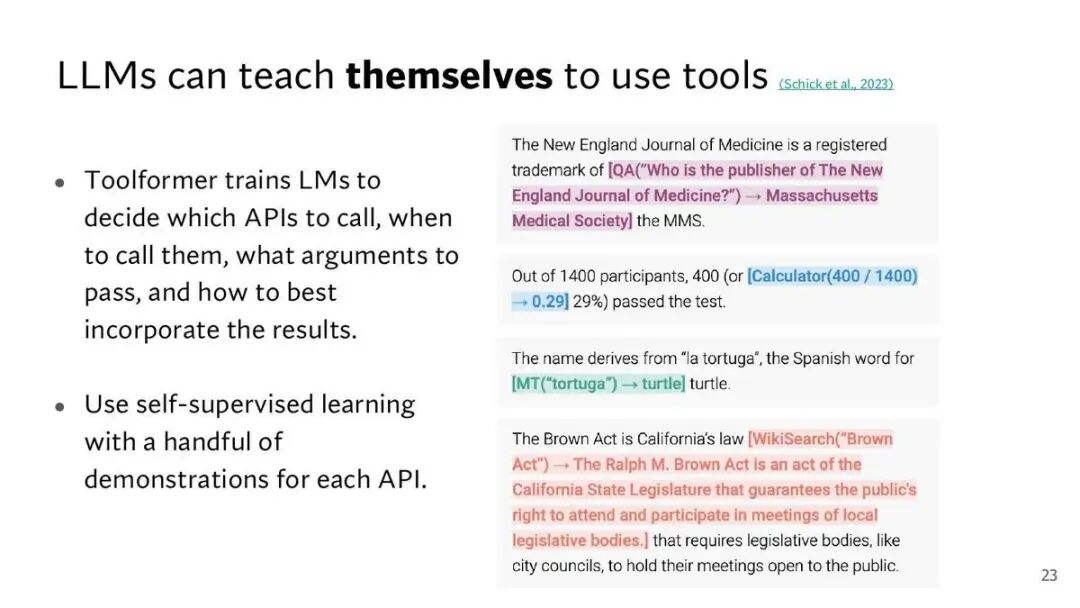
第 22 页的标题是「语言模型能自己教会自己用工具」,出处是 Schick 等人 2023 年的论文。
左边两句话。Toolformer 训练模型自己决定调用哪个 API,什么时候调用,传什么参数,怎样把结果用好。方法是自监督学习,每个 API 只需要少量示范。
右边是四段带工具调用的文本,方括号里是调用和返回值。问答工具:问《新英格兰医学杂志》的出版方是谁,返回马萨诸塞州医学会。计算器:1400 名参与者里 400 人通过,算 400 / 1400,返回 0.29,文中写 29%。翻译:把西班牙语「tortuga」译成 turtle(乌龟)。维基百科搜索:搜「Brown Act」,返回它是加州立法机构的一项法案,保障公众参加地方立法机构会议的权利。
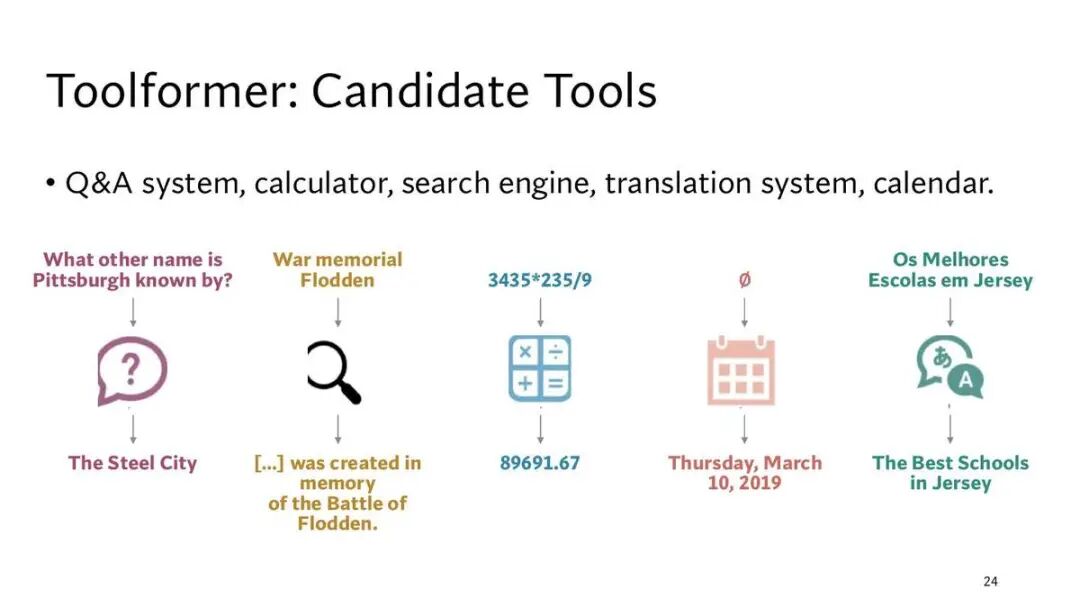
第 23 页列了 Toolformer 用的五种工具:问答系统,计算器,搜索引擎,翻译系统,日历。
每种下面给了一个输入和输出。问答:「匹兹堡还有什么别名」,返回「钢铁之城」。搜索:「War memorial Flodden」,返回一段讲弗洛登战役纪念物的文字。计算器:3435*235/9,返回 89691.67。日历:输入为空,返回当天日期「2019 年 3 月 10 日,星期四」。翻译:葡萄牙语「Os Melhores Escolas em Jersey」,返回英文「The Best Schools in Jersey」。
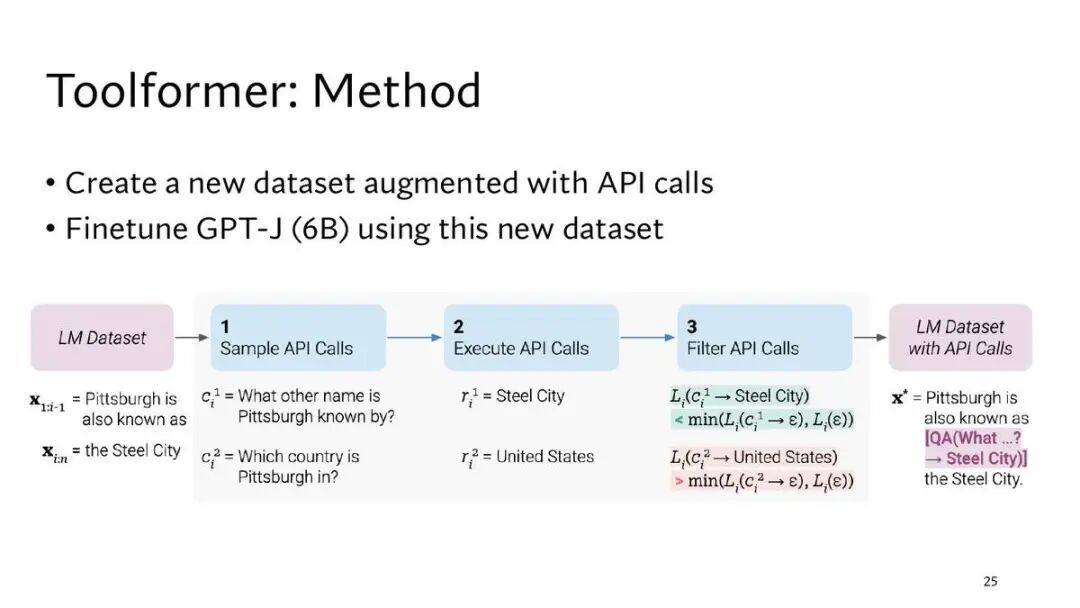
第 24 页是方法总览,两步:先造一份插入了 API 调用的新数据集,再用它微调 GPT-J(60 亿参数)。
下面的流程图有三步。从普通的语言模型数据集出发:第 1 步采样候选的 API 调用,第 2 步执行这些调用,第 3 步过滤掉没用的调用,最后得到一份带 API 调用的数据集。
图里用的例子贯穿后面几页。原句是「Pittsburgh is also known as the Steel City」。候选调用有两个:c¹ 问「匹兹堡还有什么别名」,c² 问「匹兹堡在哪个国家」。执行后分别返回「Steel City」和「United States」。过滤时,c¹ 让后文的损失变低,留下;c² 没有,丢掉。最终句子变成「Pittsburgh is also known as [QA(What …?) → Steel City] the Steel City.」
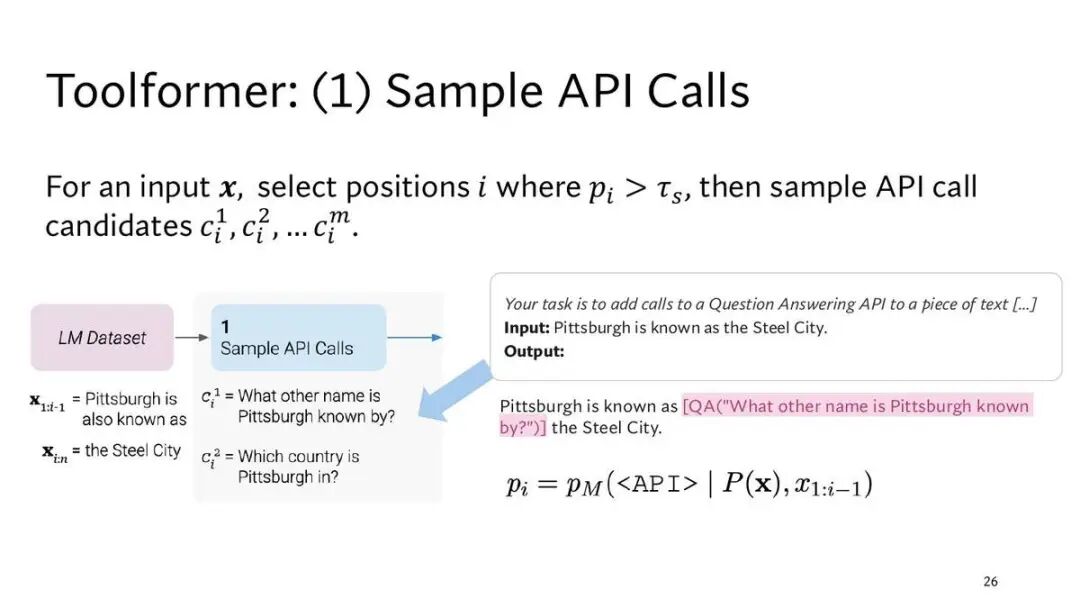
第 25 页讲第 1 步,采样。对一段输入 x,先算模型在每个位置 i 想插入 API 调用的概率 pᵢ,也就是在给定提示 P(x) 和前文的条件下,下一个 token 是 <API> 的概率。只在 pᵢ 超过阈值 τs 的位置采样,每个位置采出若干个候选调用。
右边是提示的样子:先告诉模型「你的任务是在一段文字里加入对问答 API 的调用」,给几个示范,再给输入「Pittsburgh is known as the Steel City.」,模型输出「Pittsburgh is known as [QA("What other name is Pittsburgh known by?")] the Steel City.」。
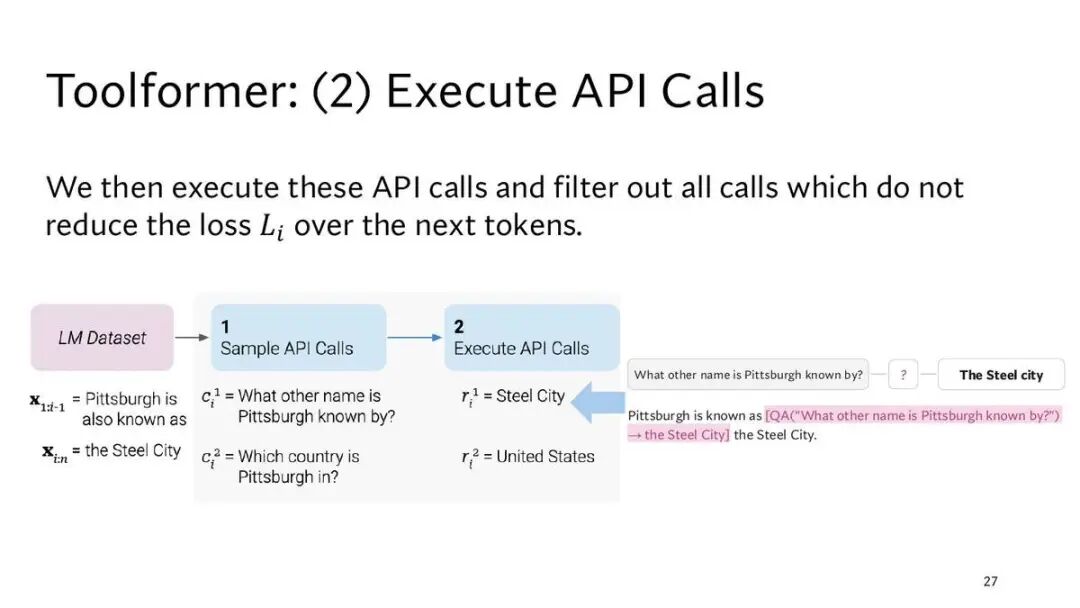
第 26 页讲第 2 步,执行。把采到的调用真的执行一遍,拿到返回值。例子里,问答 API 对「匹兹堡还有什么别名」返回「the Steel City」,返回值被写回到方括号里。
这一页的说明文字已经预告了第 3 步:不能让后面 token 的损失 Lᵢ 降下来的调用,都要过滤掉。
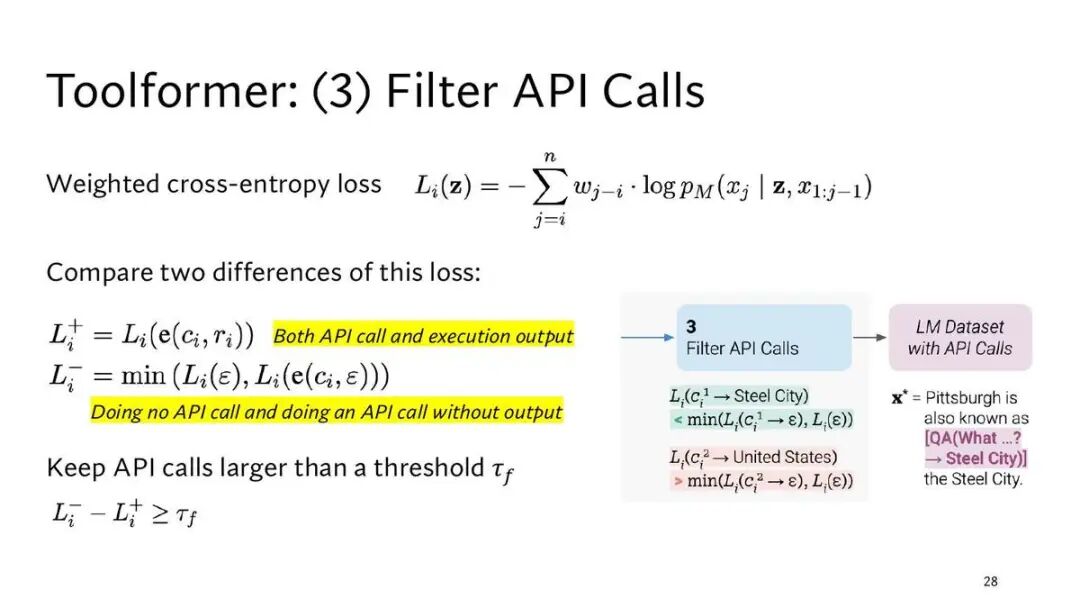
第 27 页讲第 3 步,过滤,给了公式。
Lᵢ(z) 是加权交叉熵:在前面加上 z 的条件下,模型预测位置 i 之后各个 token 的损失之和,离 i 越远的 token 权重越小。
然后比较两个量。L⁺ 是插入了调用和返回值时的损失。L⁻ 取两种情况里较小的那个:完全不调用,以及只写调用,不给返回值。
只有当 L⁻ 减 L⁺ 大于等于阈值 τf 时,才保留这个调用。意思是:带上返回值以后,模型预测后文要比不调用,或者只调用不看结果,都好出一截。
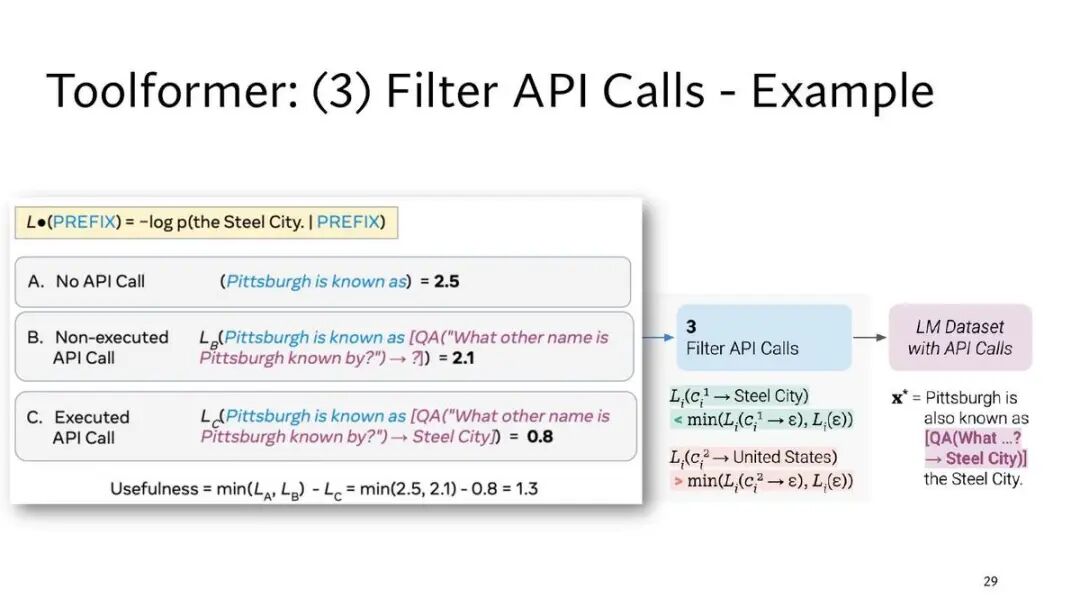
第 28 页用一个例子把公式算了一遍。目标是预测后文「the Steel City.」,看它前面放什么前缀时损失最低。
A,不调用,前缀只有「Pittsburgh is known as」,损失 2.5。B,只写调用不给结果,损失 2.1。C,调用并给出结果「Steel City」,损失 0.8。
有用程度 = min(2.5, 2.1) − 0.8 = 1.3。
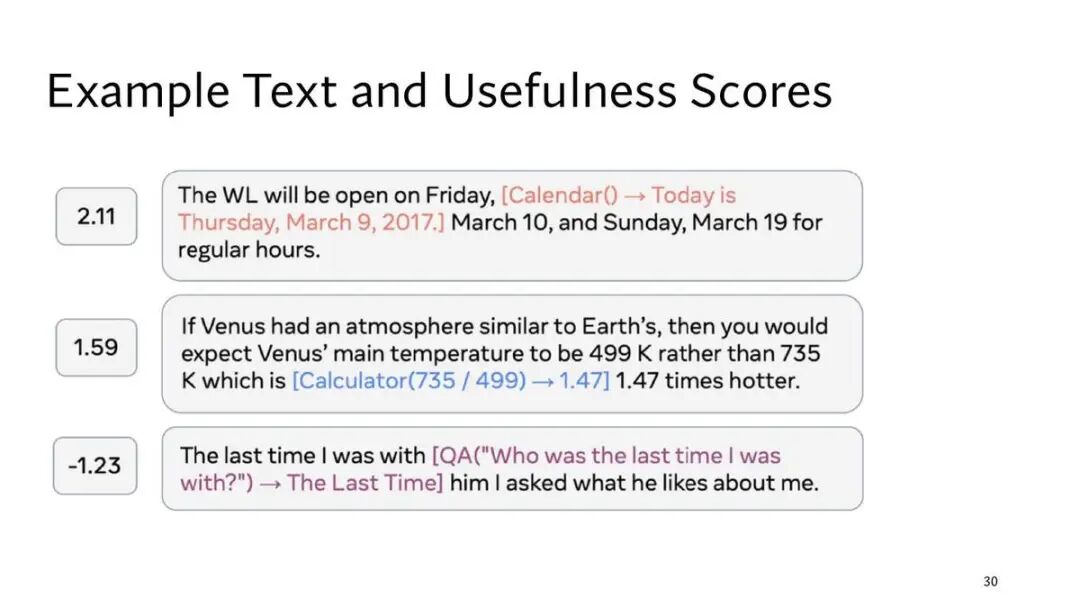
第 29 页是三段文本和它们的有用程度得分。
2.11 分:「WL 周五开放,[Calendar() → 今天是 2017 年 3 月 9 日,星期四] 3 月 10 日……」,日历调用帮模型写出了后面的日期。
1.59 分:「如果金星的大气和地球类似,表面温度会是 499 K 而不是 735 K,也就是 [Calculator(735 / 499) → 1.47] 1.47 倍」,计算器帮模型写出了倍数。
−1.23 分:「The last time I was with [QA("Who was the last time I was with?") → The Last Time] him I asked what he likes about me.」,这个问答调用没有帮助,得分是负的。
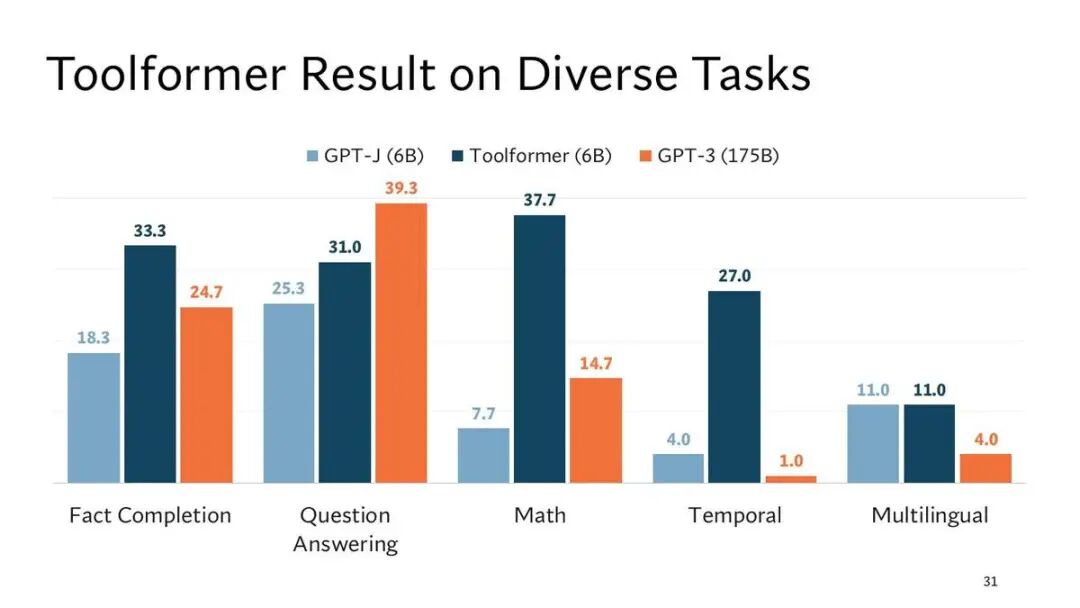
第 30 页是 Toolformer 在五类任务上的结果,三根柱子分别是 GPT-J(60 亿参数),Toolformer(60 亿参数)和 GPT-3(1750 亿参数)。
事实补全:18.3,33.3,24.7。问答:25.3,31.0,39.3。数学:7.7,37.7,14.7。时间相关的问题:4.0,27.0,1.0。多语言:11.0,11.0,4.0。
五类里,Toolformer 在事实补全,数学,时间三类上超过了大得多的 GPT-3;问答上 GPT-3 最高;多语言上 Toolformer 和 GPT-J 持平。
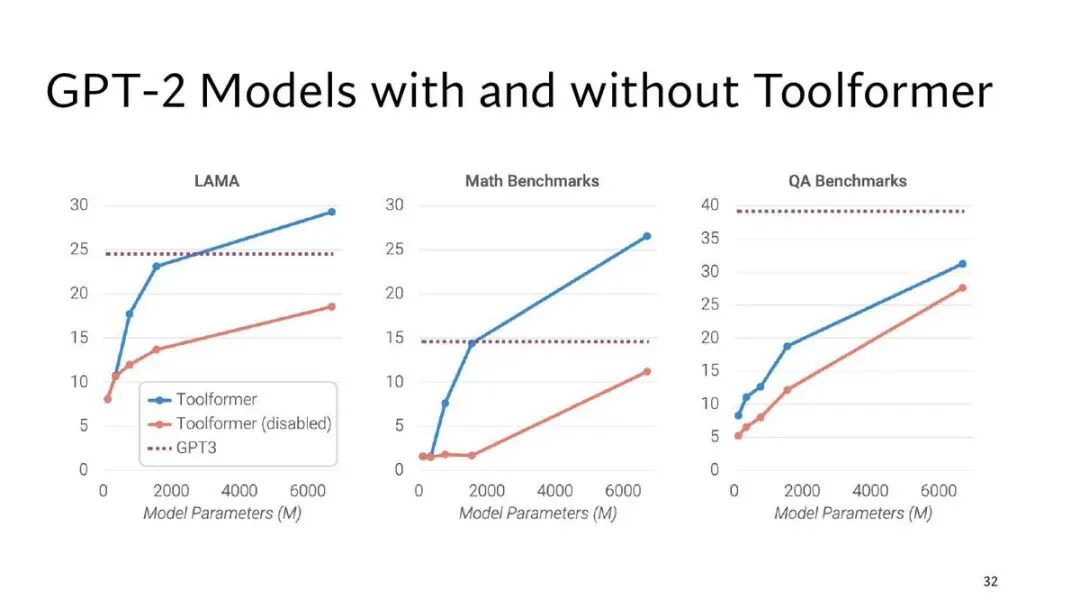
第 31 页看模型大小的影响:一组 GPT-2 规模的模型,分别训练成 Toolformer,然后在三类基准上比较。蓝线是 Toolformer,红线是同一个模型但关掉工具调用,紫色虚线是 GPT-3 作参照。横轴是模型参数量,单位是百万。
三张图是 LAMA(事实补全),数学基准和问答基准。最小的几个模型上,蓝线和红线几乎重合,开不开工具差不多;模型越大,两条线拉得越开。LAMA 和数学两张图上,蓝线在较大的模型上越过了 GPT-3 那条虚线;问答图上,两条线都还在虚线下面。
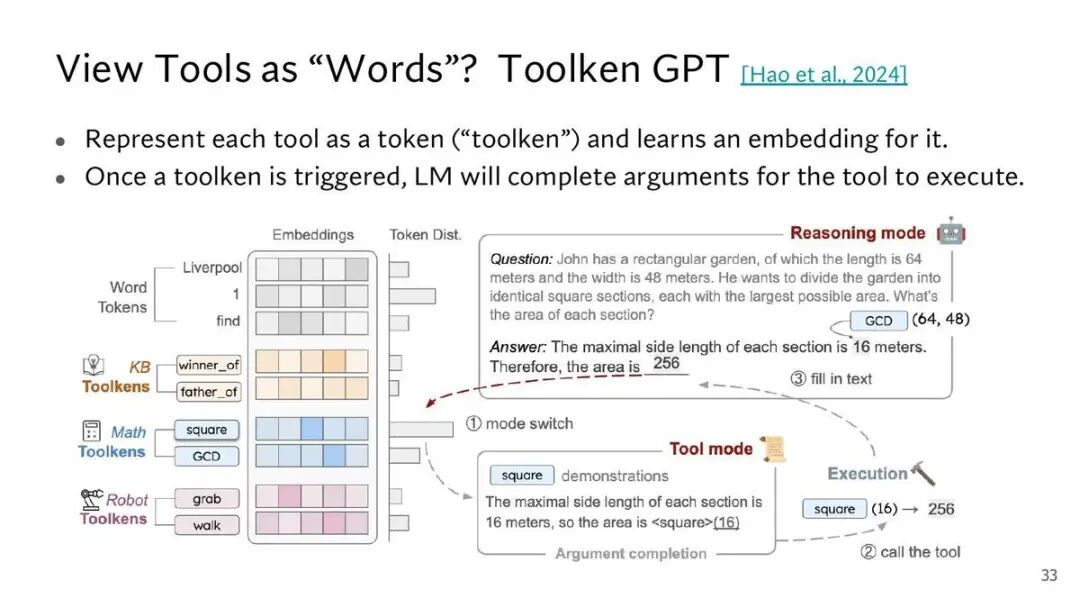
第 32 页换了一种思路:能不能把工具当成「词」?出处是 Hao 等人 2024 年的 ToolkenGPT。
两句话。每个工具表示成一个 token,叫 toolken(tool 和 token 拼起来),给它学一个嵌入向量。一旦模型生成了某个 toolken,就转去补全这个工具的参数,然后执行。
图的左边是词表:普通的词,比如 Liverpool,1,find;后面接着几组 toolken,知识库类的 winner_of,father_of,数学类的 square,GCD,机器人类的 grab,walk。
右边是一道题:一块 64 米乘 48 米的长方形花园,要分成尽量大的相同正方形,每块面积是多少。模型在推理模式下写到需要算最大公约数时,生成 GCD 这个 toolken,① 切换模式;在工具模式下,根据示范补全参数,得到 GCD(64, 48),② 调用工具,得到 16;③ 把结果填回正文,继续推理。后面算面积时用 square(16) 得到 256。
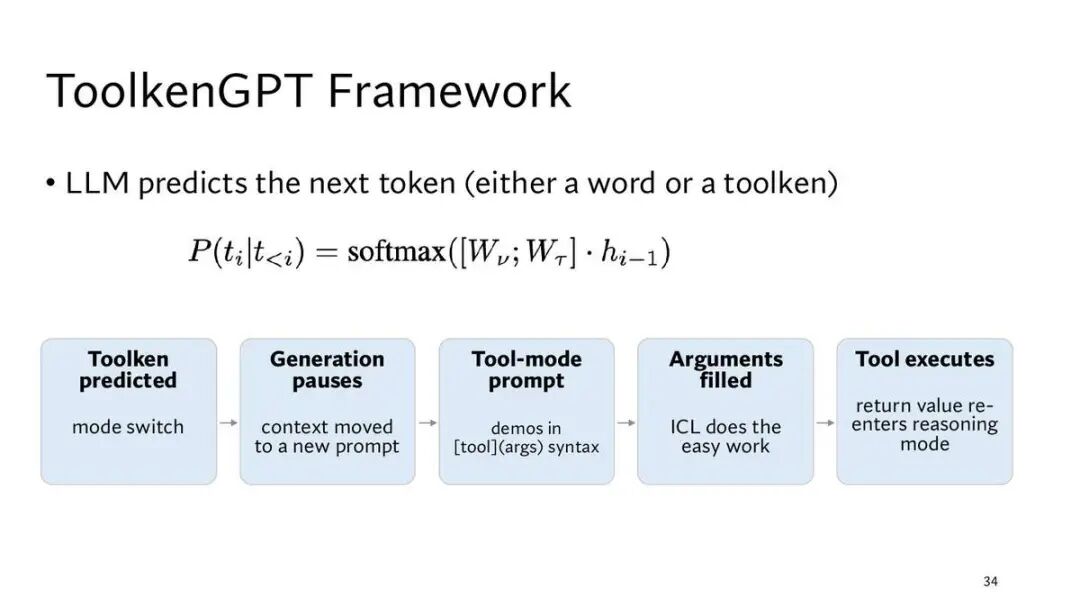
第 33 页把 ToolkenGPT 的框架写得更细。
模型预测下一个 token 时,这个 token 可以是词,也可以是 toolken。公式是 P(tᵢ | t<ᵢ) = softmax([W_ν; W_τ] · hᵢ₋₁):W_ν 是原来词表的输出矩阵,W_τ 是新加的 toolken 矩阵,两个拼在一起做 softmax。
下面五步。预测出 toolken,切换模式。生成暂停,把上下文挪到一个新的提示里。在工具模式的提示里放 [tool](args) 格式的示范。靠上下文学习填参数,课件的说法是「这部分简单的活交给上下文学习」。工具执行,返回值回到推理模式。
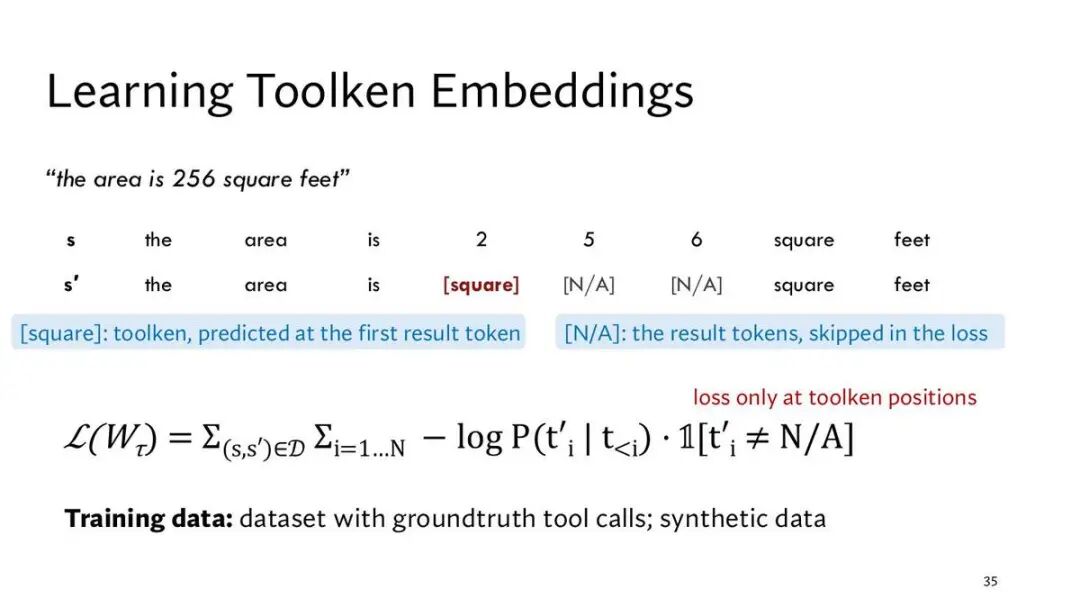
第 34 页讲 toolken 的嵌入怎么学。
例句是「the area is 256 square feet」。原句 s 逐个 token 是 the,area,is,2,5,6,square,feet。训练目标 s′ 把第一个结果 token「2」换成 toolken [square],后面两个结果 token「5」「6」换成 [N/A],在损失里跳过。
损失函数只在 toolken 的位置上算,[N/A] 的位置不计。训练数据可以是带标准答案工具调用的数据集,也可以是合成数据。
补充ToolkenGPT 训练时,语言模型本身的参数不动,只学 W_τ 这个 toolken 矩阵。所以加新工具只需要加新的一行嵌入,不用重新训练整个模型。
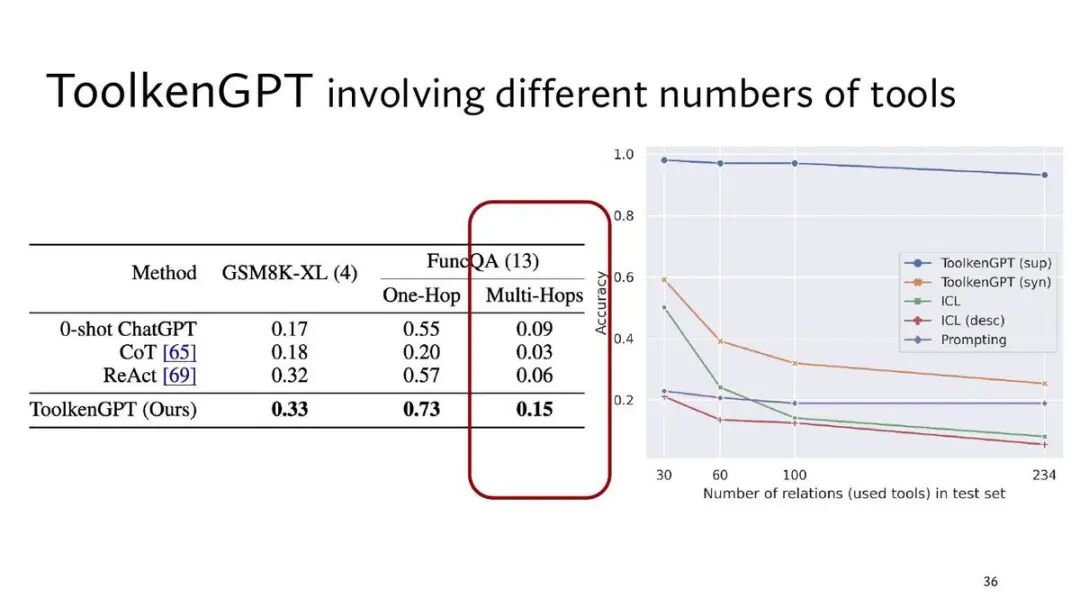
第 35 页是结果,标题是「ToolkenGPT 在不同工具数量下的表现」。
左边的表比较四种方法。GSM8K-XL 括号里的 4 是用到 4 个工具,FuncQA 括号里的 13 是 13 个工具。
GSM8K-XL:零样本 ChatGPT 0.17,思维链 0.18,ReAct 0.32,ToolkenGPT 0.33。FuncQA 单跳:0.55,0.20,0.57,0.73。FuncQA 多跳:0.09,0.03,0.06,0.15。课件用红框圈出了多跳那一列。
右边的图横轴是测试集里用到的关系,也就是工具的数量,从 30 到 234,纵轴是准确率。用标注数据训练的 ToolkenGPT(sup)一直在 0.9 以上,工具多了也只是略降。用合成数据训练的 ToolkenGPT(syn)从约 0.6 降到约 0.25。上下文学习(ICL)从约 0.5 降到 0.1 以下。
补充GSM8K 是小学数学应用题数据集,GSM8K-XL 是 ToolkenGPT 论文把其中的数字放大后的版本,让心算更难。FuncQA 是论文自己造的数学题集,需要调用 13 种算术函数。单跳指一道题调一次工具,多跳指要连着调好几次。
五、扩展到大量工具:Gorilla
工具一多,模型就会编出不存在的 API。ToolLLM 和 Gorilla 都配了一个检索器,先把相关的 API 文档找出来再调用;Gorilla 还用语法树匹配来量化这种幻觉。
第 36 页是大纲,前四项变灰,进入「扩展到大量工具:Gorilla」。
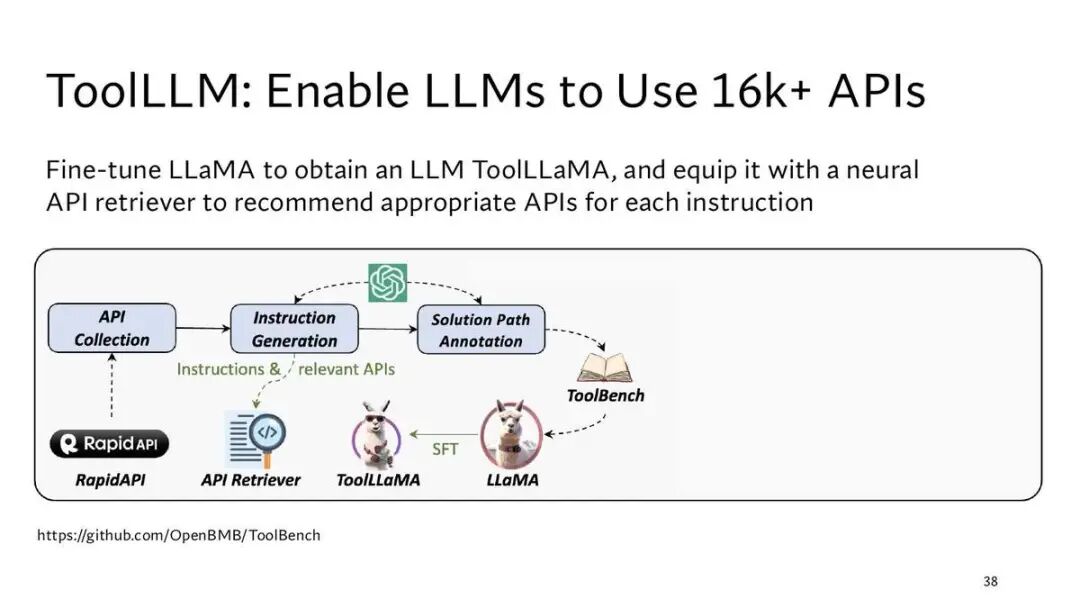
第 37 页是 ToolLLM,标题是「让模型能用 16000 多个 API」。做法是微调 LLaMA 得到 ToolLLaMA,再给它配一个神经网络的 API 检索器,针对每条指令推荐合适的 API。
流程图从左往右:从 RapidAPI 收集 API。用 ChatGPT 生成指令。再用 ChatGPT 标注解题路径,也就是一步步调哪些 API。这些数据合起来叫 ToolBench。用它对 LLaMA 做监督微调(SFT),得到 ToolLLaMA。生成指令时同时记下每条指令相关的 API,用来训练 API 检索器。
补充RapidAPI 是一个 API 市场,开发者把自己的 API 挂上去,别人按需订阅调用。
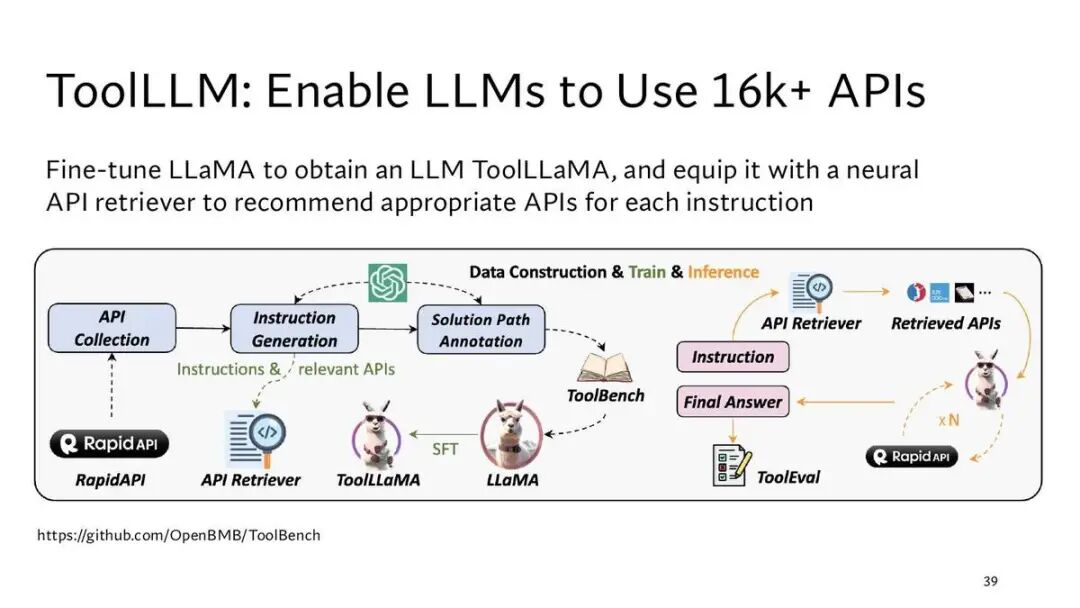
第 38 页在同一张图上补了推理的部分。来了一条指令,API 检索器先找出相关的 API,ToolLLaMA 拿着这些 API 去调 RapidAPI,可以来回调用 N 次,最后给出答案,再交给 ToolEval 评估。图顶的标题标明了三段:数据构建,训练,推理。
第 39 页讲工具使用里出现的问题:幻觉。
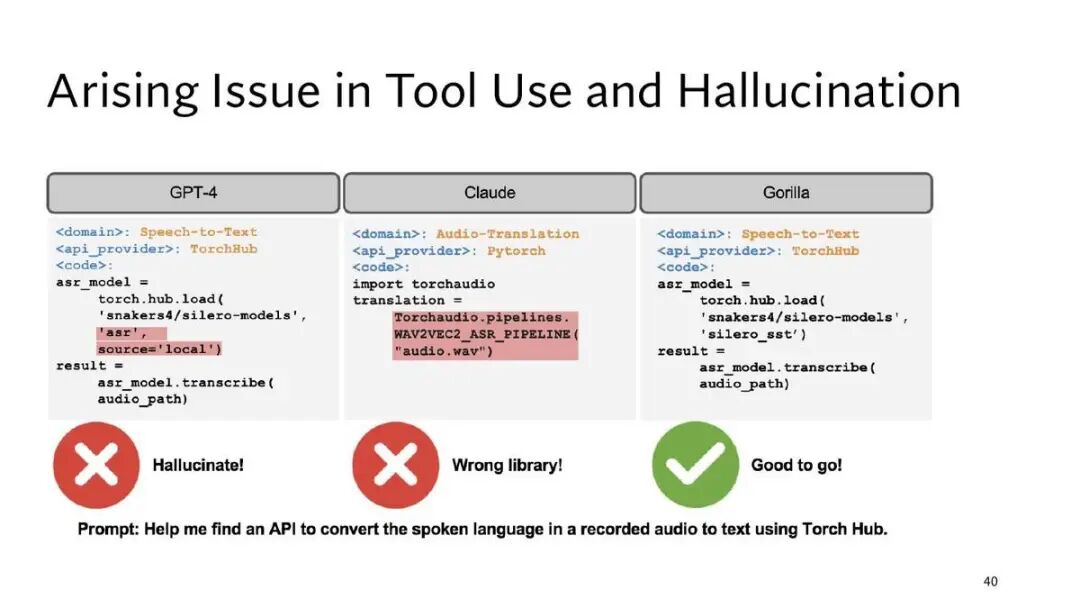
提示是:「帮我在 Torch Hub 上找一个 API,把录音里的口语转成文字。」三个模型各写了一段代码。
GPT-4 用了 torch.hub.load,仓库 snakers4/silero-models 是对的,但模型名写成了「asr」,还加了 source='local',红色标出,判为「幻觉」。
Claude 改用 torchaudio 的 WAV2VEC2_ASR_PIPELINE,判为「用错了库」,因为题目要求的是 Torch Hub。
Gorilla 写的是 torch.hub.load('snakers4/silero-models', 'silero_stt'),判为「可以用」。
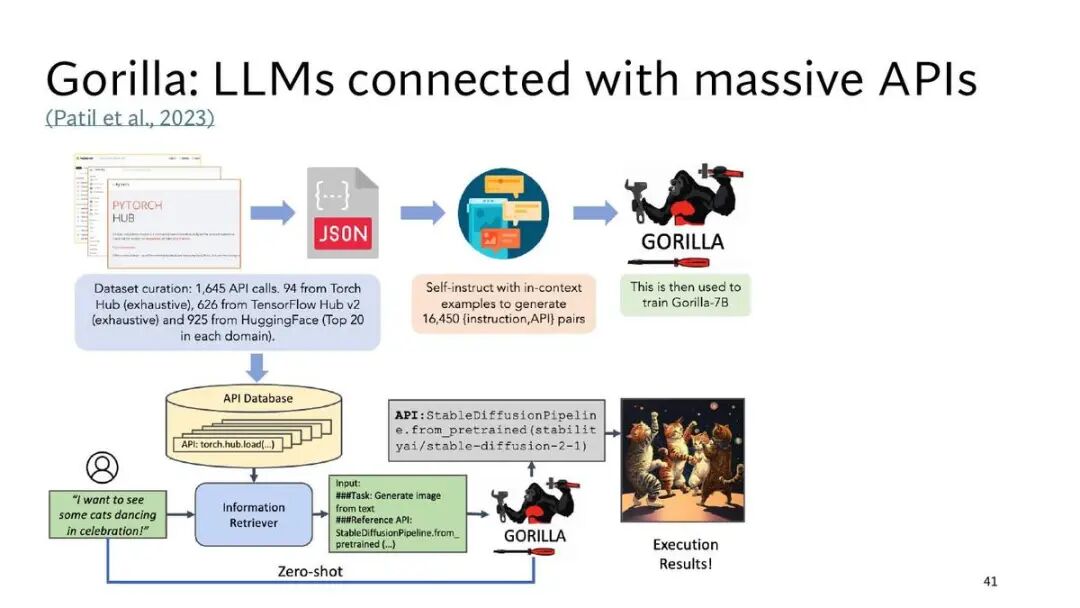
第 40 页介绍 Gorilla,出处是 Patil 等人 2023 年的论文,标题是「连上海量 API 的语言模型」。
上半部分是训练。先整理数据:1,645 个 API 调用,其中 Torch Hub 94 个,TensorFlow Hub v2 626 个,这两个是全收;HuggingFace 925 个,是每个领域取前 20 个。然后用自我指令(self-instruct)加上下文示例,生成 16,450 对「指令,API」。最后用这些数据训练 Gorilla-7B。
下半部分是推理。用户说「我想看一些猫跳舞庆祝的画面」。可以零样本,直接交给 Gorilla;也可以先让信息检索器从 API 数据库里找出参考 API,连同任务一起交给 Gorilla。Gorilla 输出 StableDiffusionPipeline.from_pretrained(stabilityai/stable-diffusion-2-1),执行后得到一张猫在庆祝的图。
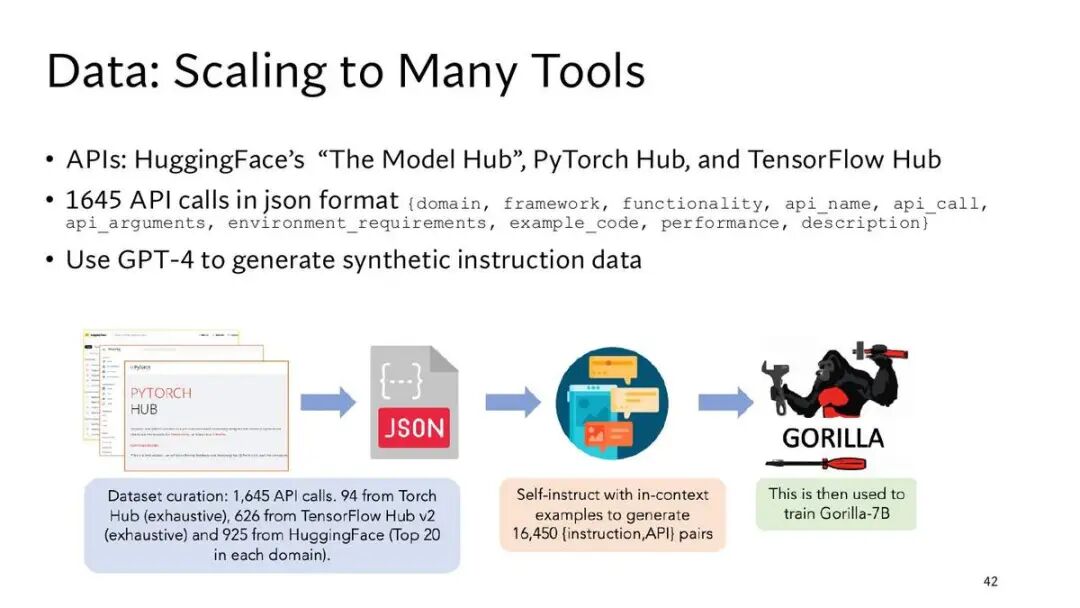
第 41 页细说数据。API 来自三个模型库:HuggingFace 的 Model Hub,PyTorch Hub,TensorFlow Hub。
1,645 个 API 调用都存成 JSON,字段有:领域,框架,功能,API 名称,API 调用,API 参数,环境依赖,示例代码,性能,描述。然后用 GPT-4 生成合成的指令数据。下面的流程图和上一页的上半部分相同。
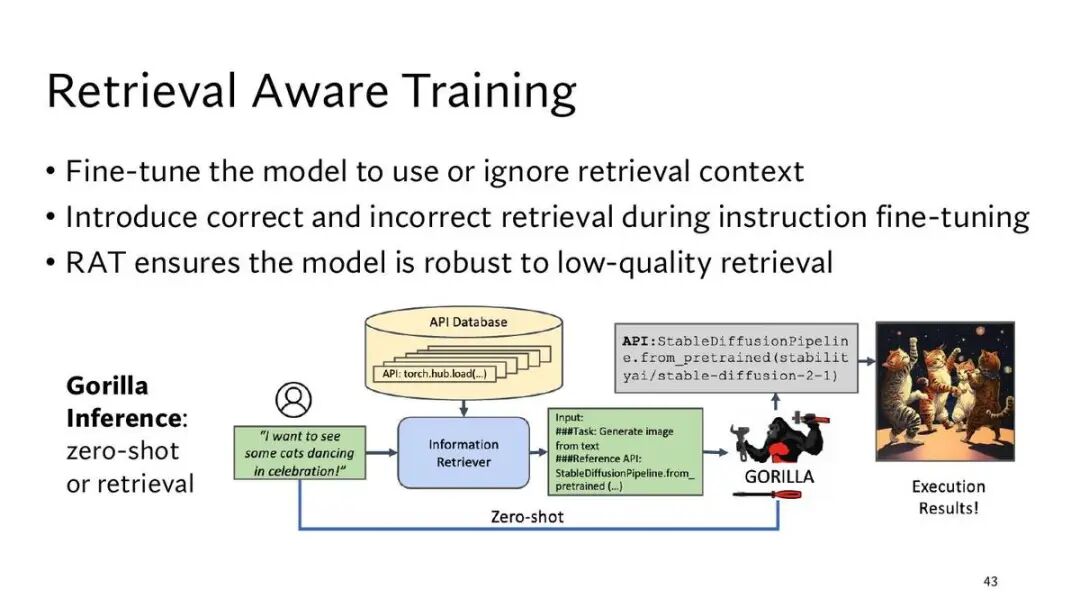
第 42 页讲检索感知训练(Retrieval Aware Training,RAT),三句话。微调模型,让它学会用检索到的上下文,也学会忽略它。指令微调时,既放正确的检索结果,也放错误的。这样模型在检索质量差的时候也不容易被带偏。
图上写着 Gorilla 推理时有两种方式:零样本,或者带检索。
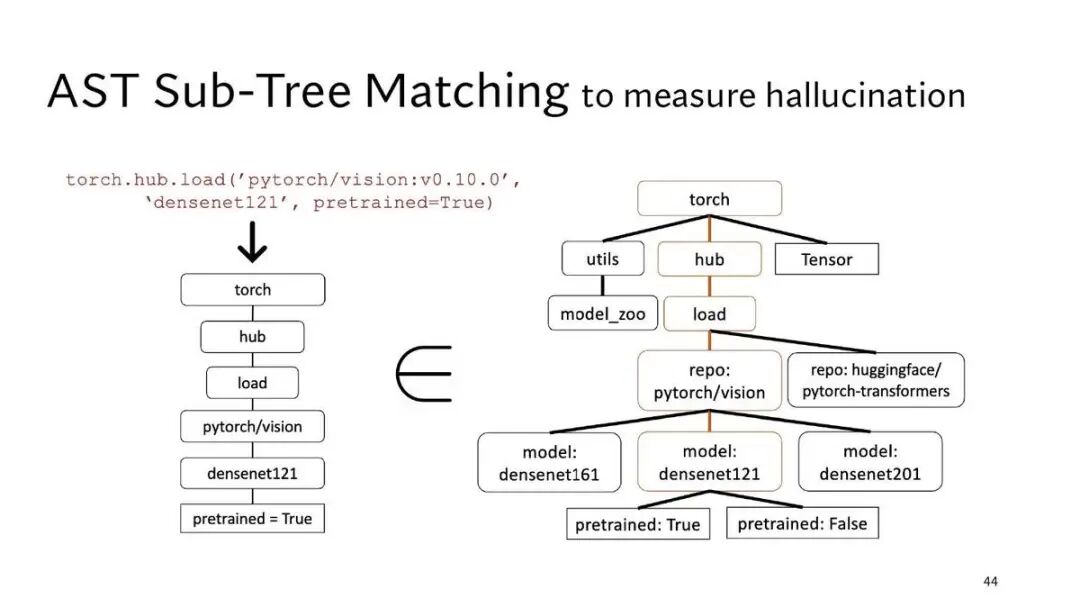
第 43 页讲怎样量化幻觉:抽象语法树(AST)子树匹配。
把模型生成的调用 torch.hub.load('pytorch/vision:v0.10.0', 'densenet121', pretrained=True) 解析成一条链:torch,hub,load,pytorch/vision,densenet121,pretrained = True。右边是 API 数据库对应的树,torch 下面有 utils,hub,Tensor 等分支,hub 下面一路分到各个仓库和模型,比如 densenet161,densenet121,densenet201,再分到 pretrained 是 True 还是 False。
左边这条链是右边这棵树的一棵子树,中间用属于符号 ∈ 连起来,表示这个调用在数据库里找得到。
补充按 Gorilla 论文的定义,生成的调用如果不是数据库里任何一个 API 的子树,就算幻觉;如果对上了数据库里的某个 API,但不是题目要的那个,就算错误。这样能把「编出不存在的 API」和「选错了 API」分开统计。
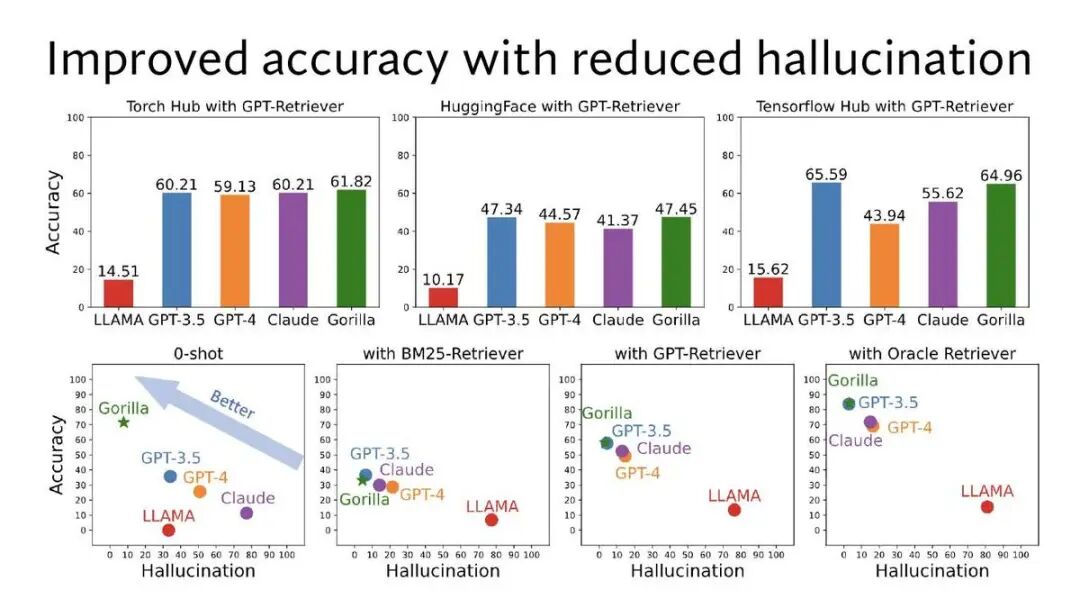
第 44 页是结果,标题是「准确率提高,幻觉减少」。
上面三张柱状图是在三个模型库上,都配 GPT 检索器时的准确率,五个模型从左到右是 LLAMA,GPT-3.5,GPT-4,Claude,Gorilla。
Torch Hub:14.51,60.21,59.13,60.21,61.82。HuggingFace:10.17,47.34,44.57,41.37,47.45。TensorFlow Hub:15.62,65.59,43.94,55.62,64.96。前两个库上 Gorilla 最高;TensorFlow Hub 上 GPT-3.5 的 65.59 比 Gorilla 的 64.96 略高。
下面四张散点图的横轴是幻觉率,纵轴是准确率,左上角最好,图里画了一个指向左上的「Better」箭头。四种设置是零样本,配 BM25 检索器,配 GPT 检索器,配理想检索器(直接给正确的 API 文档)。零样本时,Gorilla 在最左上,准确率最高,幻觉最低;LLAMA 在下方。配理想检索器时,Gorilla,GPT-3.5,GPT-4,Claude 都挤到了左上,LLAMA 仍然在右下。
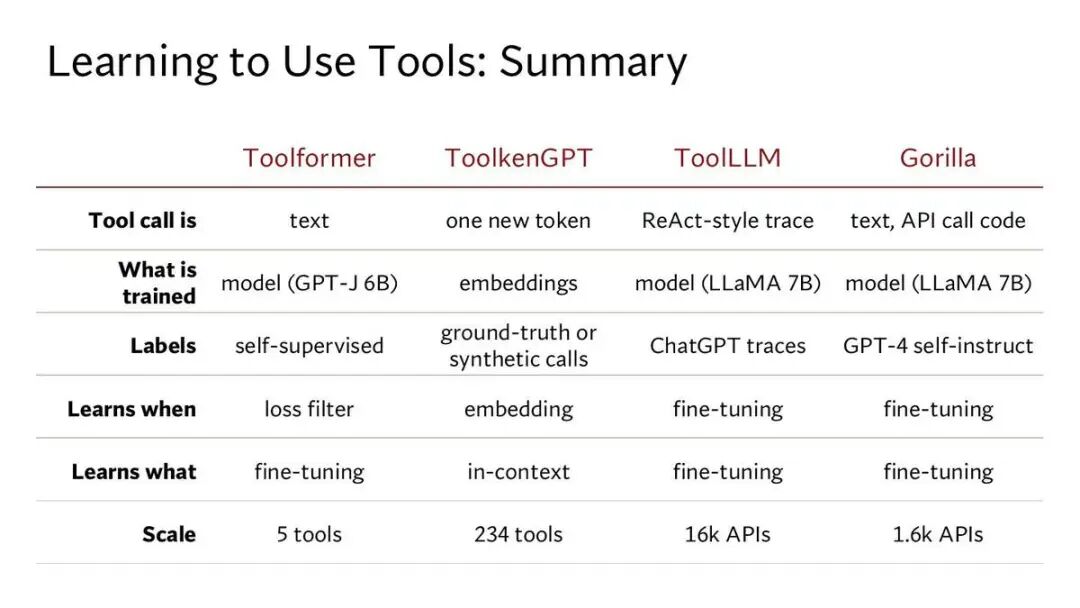
第 45 页是一张表,把这一节讲的四个方法放在一起比。
工具调用的形式:Toolformer 是文本,ToolkenGPT 是一个新 token,ToolLLM 是 ReAct 风格的轨迹,Gorilla 是文本加 API 调用代码。
训练的是什么:Toolformer 训练整个模型(GPT-J 6B),ToolkenGPT 只训练嵌入,ToolLLM 和 Gorilla 训练整个模型(LLaMA 7B)。
标注从哪来:Toolformer 是自监督,ToolkenGPT 是标准答案或合成的调用,ToolLLM 是 ChatGPT 生成的轨迹,Gorilla 是 GPT-4 自我指令生成的数据。
怎么学会「什么时候调用」:Toolformer 靠损失过滤,ToolkenGPT 靠嵌入,ToolLLM 和 Gorilla 靠微调。
怎么学会「调用什么」:ToolkenGPT 靠上下文学习,其余三个靠微调。
规模:Toolformer 5 个工具,ToolkenGPT 234 个工具,ToolLLM 1.6 万个 API,Gorilla 1,600 个 API。
补充ReAct 是 Yao 等人 2022 年提出的提示方法,让模型交替写「思考」和「行动」,行动就是调用工具,再根据工具返回的观察继续思考。
六、标准接口:REST,函数调用,MCP
前面几种方法每加一个新 API 就要再训练一次;标准接口反过来,改的是工具的描述方式,在运行时把一份 schema 交给模型,任何模型都能用。
第 46 页是大纲,前五项变灰,进入「标准接口:REST,函数调用,MCP」。
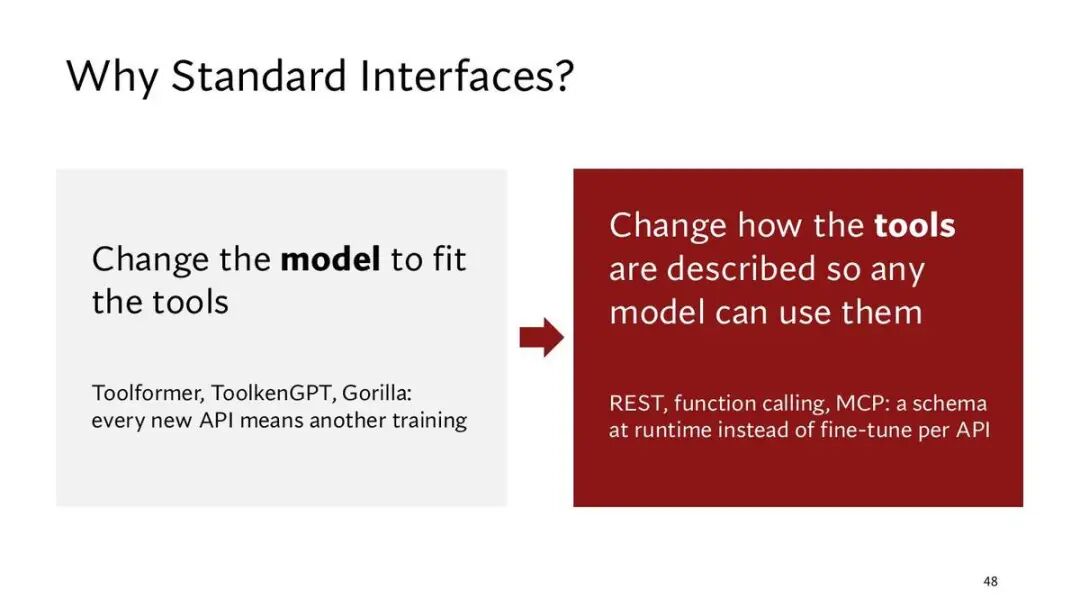
第 47 页回答「为什么要标准接口」。
左边灰框:改模型去适应工具。Toolformer,ToolkenGPT,Gorilla 都是这样,每来一个新 API,就意味着再训练一次。
右边红框:改工具的描述方式,让任何模型都能用。REST,函数调用,MCP 都是这样,在运行时提供一份 schema,不用为每个 API 微调。
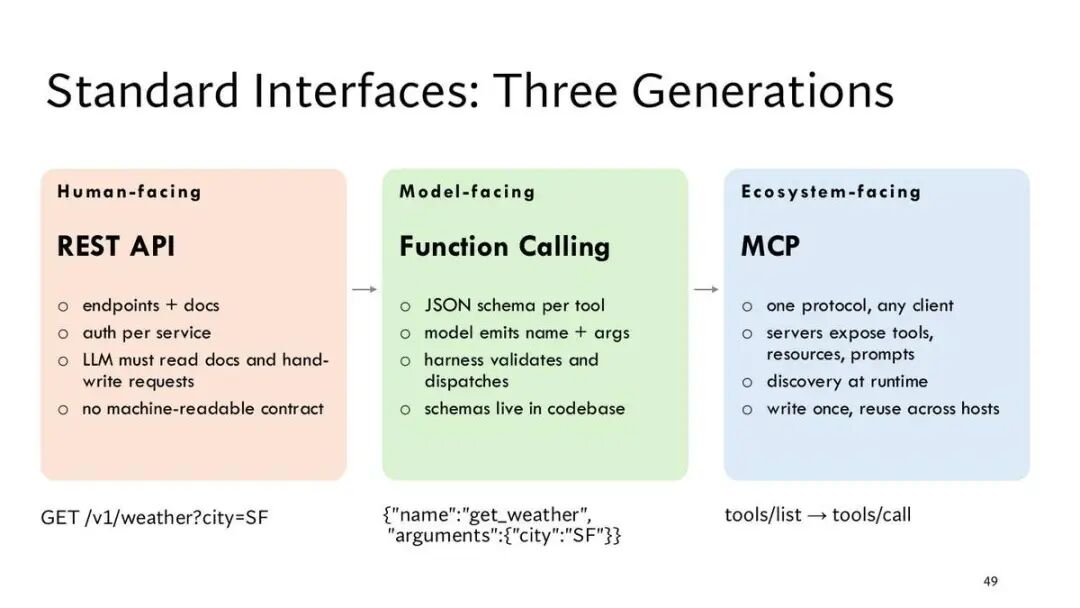
第 48 页把标准接口分成三代,按面向谁来分。
第一代是面向人的 REST API:有端点和文档;每个服务各自鉴权;模型得自己读文档,手写请求;没有机器可读的约定。例子是 GET /v1/weather?city=SF。
第二代是面向模型的函数调用:每个工具一份 JSON schema;模型输出工具名和参数;由 harness 校验参数并分发调用;schema 写在代码库里。例子是 {"name":"get_weather","arguments":{"city":"SF"}}。
第三代是面向生态的 MCP:一套协议,任何客户端都能用;服务器暴露工具,资源和提示;在运行时发现有哪些工具;写一次,在不同的宿主应用里复用。例子是先 tools/list 再 tools/call。
补充harness 在这里指包在模型外面的那层程序,负责把工具列表交给模型,解析模型的输出,执行工具,再把结果交还给模型。
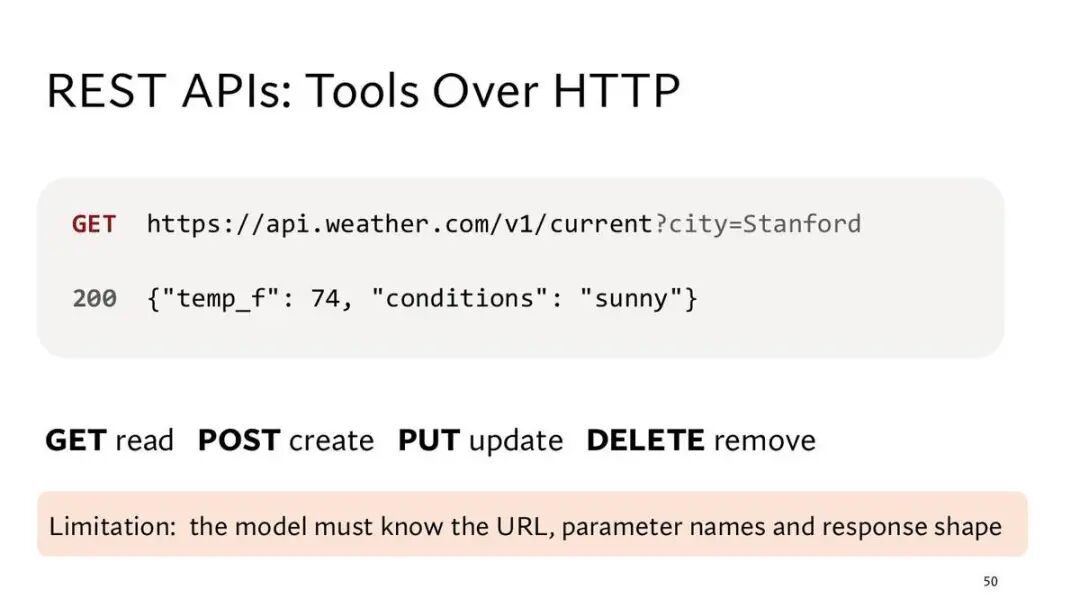
第 49 页是 REST API:工具走 HTTP。
例子是一条请求 GET https://api.weather.com/v1/current?city=Stanford,返回状态码 200 和 {"temp_f": 74, "conditions": "sunny"},华氏 74 度,晴。
下面列了四个 HTTP 方法:GET 读,POST 创建,PUT 更新,DELETE 删除。
局限:模型必须知道 URL,参数名,以及返回结果的结构。
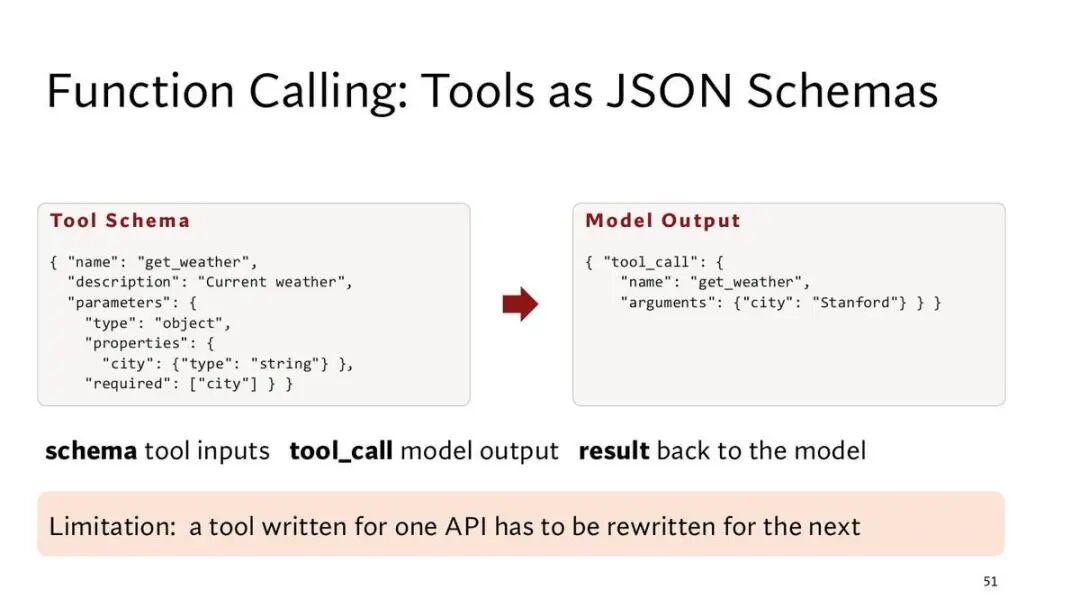
第 50 页是函数调用:把工具写成 JSON schema。
左边是工具的 schema:名字 get_weather,描述「当前天气」,参数是一个对象,有一个字符串类型的 city,而且必填。右边是模型的输出:一个 tool_call,名字 get_weather,参数 {"city": "Stanford"}。
三个概念:schema 描述工具的输入,tool_call 是模型的输出,执行结果再交回给模型。
局限:为一家的 API 写的工具,换到下一家的 API 就得重写。
补充这里的「一家的 API」指模型厂商的接口。OpenAI,Anthropic,Google 的函数调用格式各不相同,同一个工具的定义要按每家的格式各写一遍。
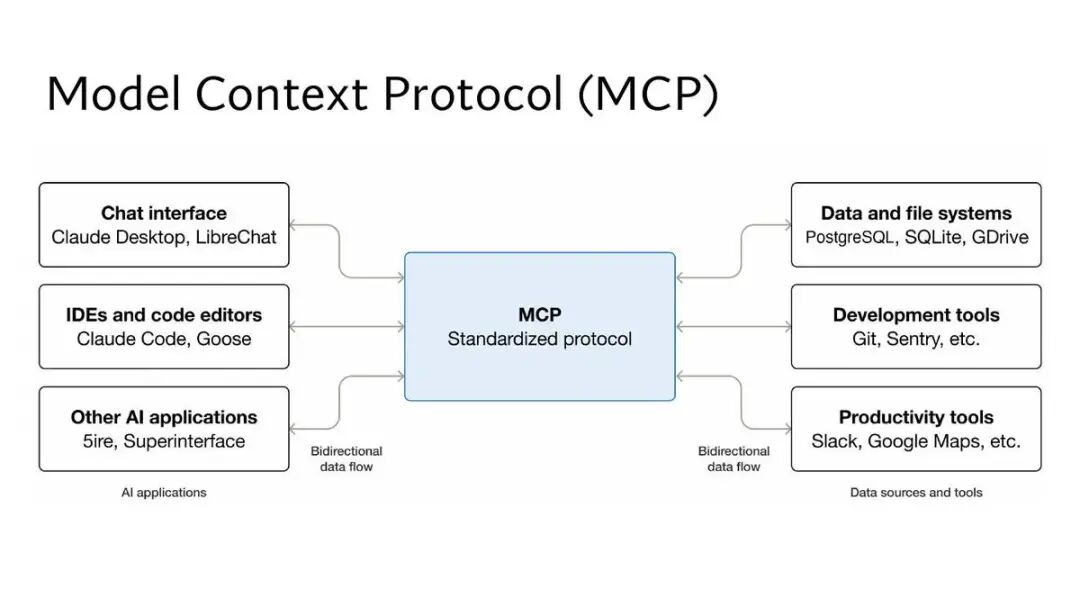
第 51 页是 MCP(Model Context Protocol,模型上下文协议)的总图。
中间是 MCP 这套标准协议。左边是 AI 应用:聊天界面,比如 Claude Desktop 和 LibreChat;IDE 和代码编辑器,比如 Claude Code 和 Goose;其他 AI 应用,比如 5ire 和 Superinterface。右边是数据源和工具:数据和文件系统,比如 PostgreSQL,SQLite,Google Drive;开发工具,比如 Git 和 Sentry;办公工具,比如 Slack 和 Google 地图。两边和协议之间的数据都是双向流动的。
补充MCP 是 Anthropic 在 2024 年 11 月发布的开放协议,2025 年 12 月捐给了 Linux 基金会下新成立的 Agentic AI Foundation。课程官网列的必读,署名就是「The Linux Foundation (2025)」。
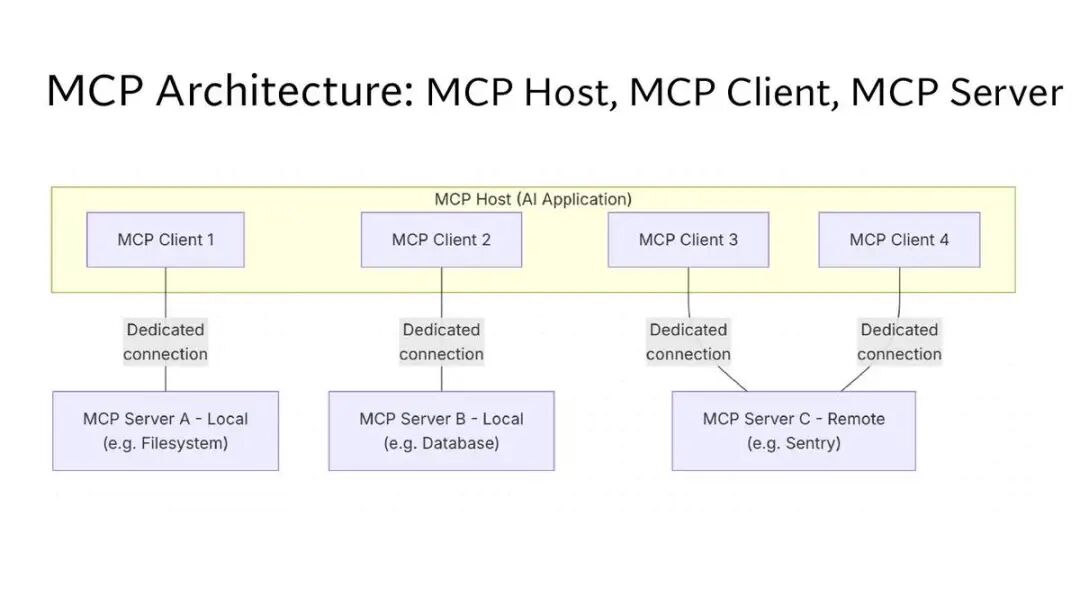
第 52 页是 MCP 的架构,三个角色:宿主,客户端,服务器。
最上面的黄框是 MCP 宿主,也就是 AI 应用本身,里面有 4 个 MCP 客户端。每个客户端和一个服务器之间是一条专用连接。客户端 1 连本地的服务器 A,比如文件系统;客户端 2 连本地的服务器 B,比如数据库;客户端 3 和 4 都连远程的服务器 C,比如 Sentry。
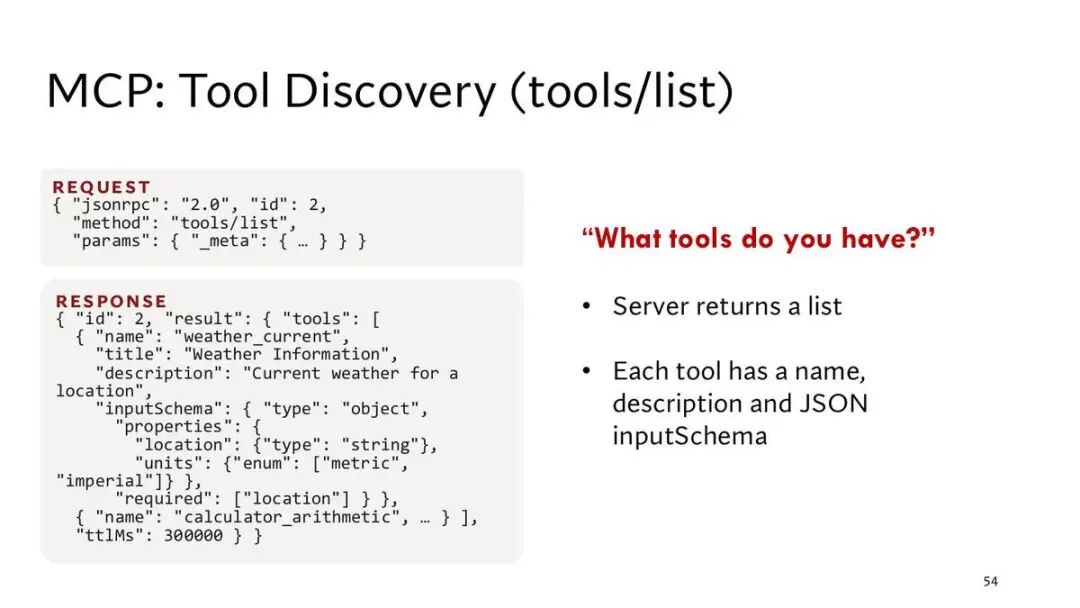
第 53 页是 MCP 的工具发现,方法名 tools/list,意思是「你有哪些工具」。
请求是一条 JSON-RPC 2.0 消息,id 为 2,方法 tools/list。
返回是一个工具列表。第一个工具名叫 weather_current,标题「天气信息」,描述「某个地点的当前天气」,还有一份 inputSchema:location 是字符串,必填;units 只能取 metric 或 imperial,也就是公制或英制。第二个工具是 calculator_arithmetic,细节省略了。列表末尾有一个 ttlMs: 300000。
右边的说明:服务器返回一个列表,每个工具有名字,描述和 JSON 格式的 inputSchema。
补充JSON-RPC 是一种用 JSON 写的远程调用格式,每条请求带 method(调哪个方法),params(参数)和 id(用来把返回和请求对上)。
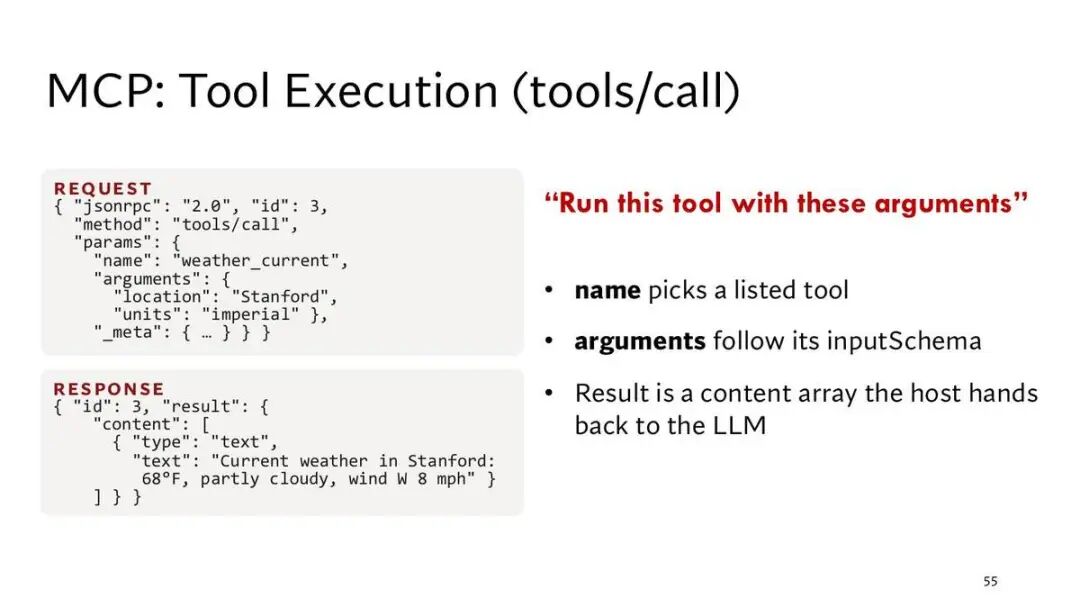
第 54 页是工具执行,方法名 tools/call,意思是「用这些参数运行这个工具」。
请求 id 为 3,参数里 name 是 weather_current,arguments 是 location 为 Stanford,units 为 imperial。
返回的 result 里是一个 content 数组,其中一项类型为 text,内容是「斯坦福当前天气:68°F,局部多云,西风 8 英里每小时」。
右边三点:name 从列出的工具里选一个;arguments 要符合那个工具的 inputSchema;结果是一个内容数组,由宿主交回给模型。
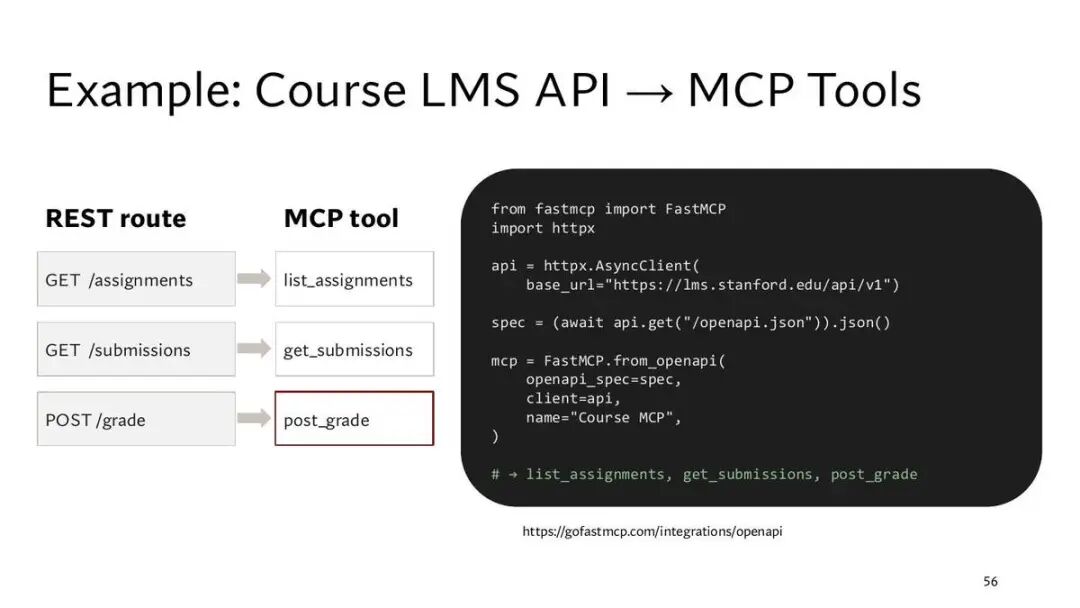
第 55 页是一个例子:把课程管理系统(LMS)的 REST API 变成 MCP 工具。
左边是对应关系:GET /assignments 变成 list_assignments,GET /submissions 变成 get_submissions,POST /grade 变成 post_grade。post_grade 用红框标了出来。
右边是代码,用的是 FastMCP 这个库。先建一个指向 https://lms.stanford.edu/api/v1 的 HTTP 客户端,从 /openapi.json 拿到 API 的 OpenAPI 描述,再调 FastMCP.from_openapi,传入这份描述和客户端,起名「Course MCP」。注释写着,生成的工具就是 list_assignments,get_submissions,post_grade 三个。参考链接是 https://gofastmcp.com/integrations/openapi
补充OpenAPI 是描述 REST API 的标准格式,用一份 JSON 或 YAML 列出所有端点,参数和返回结构。FastMCP 是一个用 Python 写 MCP 服务器的库。
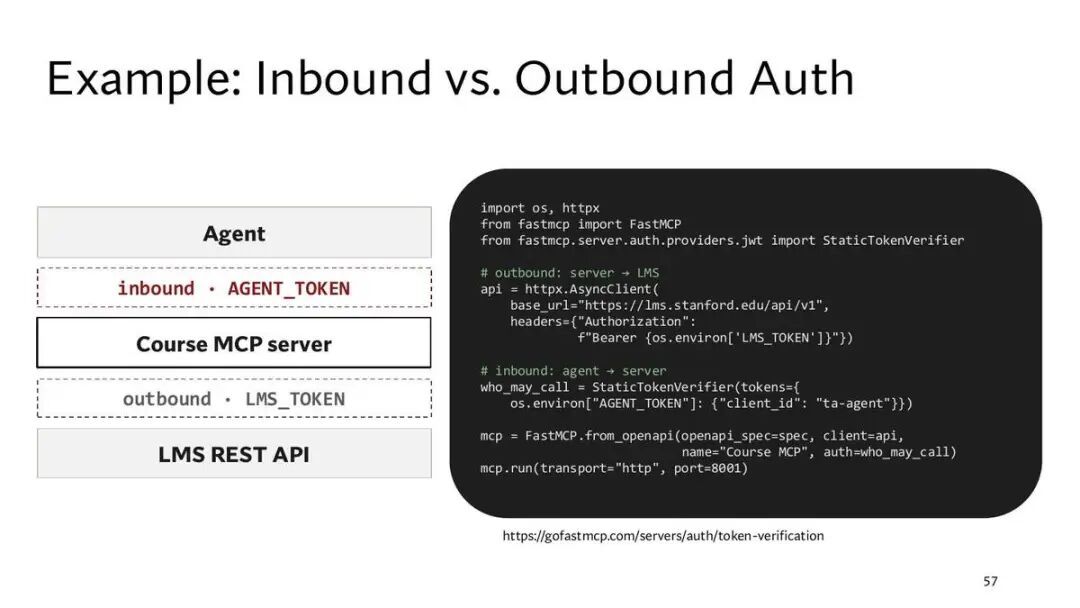
第 56 页接着这个例子讲鉴权,分进和出两个方向。
左边是三层:最上面是 agent,中间是课程的 MCP 服务器,最下面是 LMS 的 REST API。agent 到 MCP 服务器是「入站」,用 AGENT_TOKEN;MCP 服务器到 LMS 是「出站」,用 LMS_TOKEN。
右边是代码。出站:HTTP 客户端的请求头里带上 Authorization: Bearer 加 LMS_TOKEN,从环境变量里读。入站:用 StaticTokenVerifier 规定谁能调用,持有 AGENT_TOKEN 的调用方被识别为 client_id「ta-agent」。最后把这个校验器作为 auth 传给 FastMCP.from_openapi,用 HTTP 方式在 8001 端口运行。参考链接是 https://gofastmcp.com/servers/auth/token-verification
七、评估工具使用:BFCL,ToolBench,τ-bench
三个评测分别测三层:BFCL 测单次调用写得对不对,ToolBench 测多步调用链,τ-bench 测 agent 在和用户的对话里守不守规则,并用 pass^k 看它能不能每次都做对。
第 57 页是大纲,前六项变灰,进入最后一项「评估工具使用」。
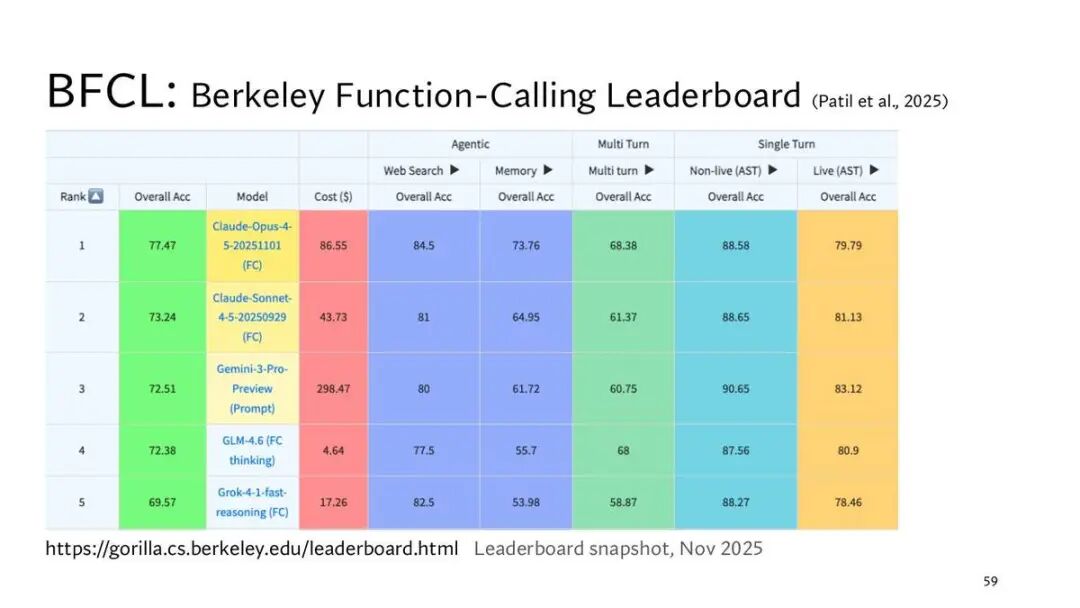
第 58 页是 BFCL(伯克利函数调用排行榜),出处是 Patil 等人 2025 年的论文,截图是 2025 年 11 月的排行榜快照。
表头分几组:总准确率,成本(美元),Agentic 一组下面是网页搜索和记忆,多轮一组,单轮一组下面是非实时(AST)和实时(AST)。
前五名:第 1 名 Claude-Opus-4-5-20251101(FC),总准确率 77.47,成本 86.55。第 2 名 Claude-Sonnet-4-5-20250929(FC),73.24,成本 43.73。第 3 名 Gemini-3-Pro-Preview(Prompt),72.51,成本 298.47。第 4 名 GLM-4.6(FC thinking),72.38,成本 4.64。第 5 名 Grok-4-1-fast-reasoning(FC),69.57,成本 17.26。
分项上,单轮的非实时 AST 五家都在 87 以上,第 3 名最高,90.65;多轮一项五家都在 58 到 69 之间;记忆一项从 73.76 到 53.98,差距最大。排行榜地址:https://gorilla.cs.berkeley.edu/leaderboard.html
补充模型名后面括号里的 FC 指用模型原生的函数调用接口来测,Prompt 指把工具写进提示词,让模型按格式输出调用。
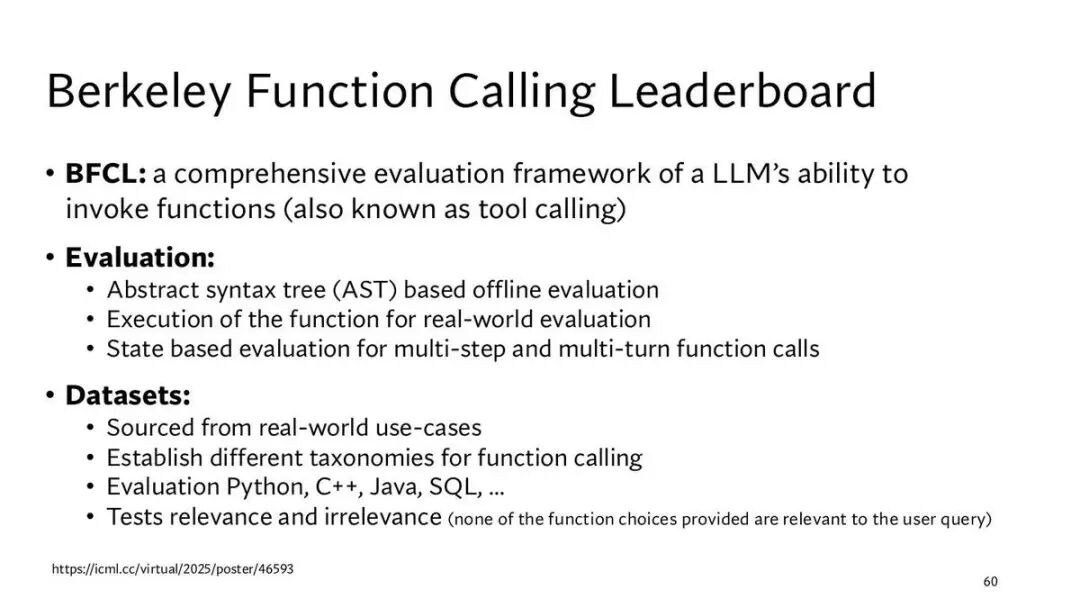
第 59 页介绍 BFCL:一个全面评估模型调用函数能力的框架,函数调用也叫工具调用。
评估方式有三种:基于抽象语法树(AST)的离线评估;真的执行函数,做贴近真实的评估;对多步,多轮的函数调用,按状态来评估。
数据集:取自真实用例;对函数调用建立了不同的分类;覆盖 Python,C++,Java,SQL 等语言;测相关和不相关,不相关指给出的函数里没有一个和用户的问题有关。论文链接:https://icml.cc/virtual/2025/poster/46593
补充「按状态评估」指不只看调用写得对不对,还看一串调用执行完以后,系统的状态(比如文件,数据库)是不是变成了应有的样子。
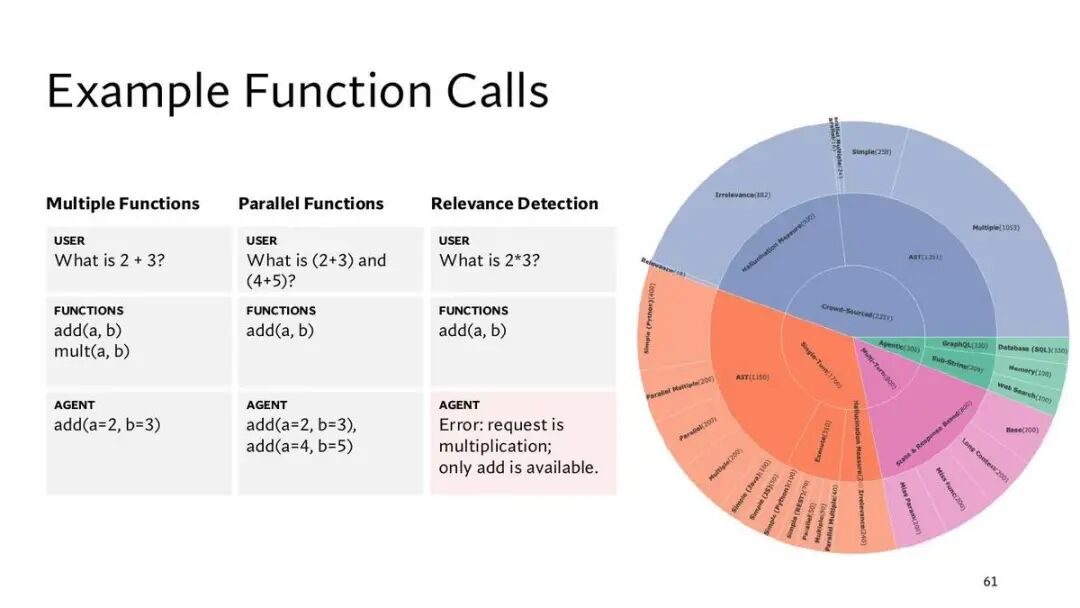
第 60 页是三类题的例子。
多个函数:用户问 2 + 3 等于多少,可用的函数有 add 和 mult,agent 应该选 add(a=2, b=3)。
并行函数:用户问 (2+3) 和 (4+5) 各是多少,只有 add,agent 应该一次发出两个调用:add(a=2, b=3) 和 add(a=4, b=5)。
相关性检测:用户问 2*3 等于多少,只有 add,agent 应该报错:请求的是乘法,而可用的只有加法。
右边的环形图是 BFCL 测试集的构成,从内到外一层层细分:按来源,按单轮,多轮,agentic 等类型,再到 Simple,Multiple,Parallel,Irrelevance 等具体类别,括号里是题数。
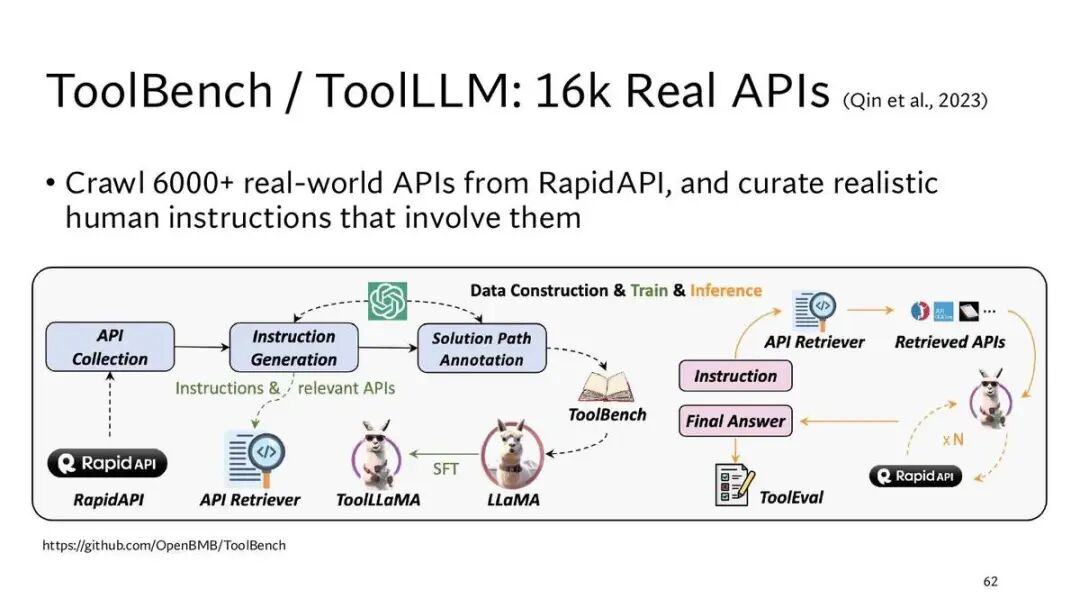
第 61 页是 ToolBench,也就是第 37 页的 ToolLLM 那篇论文,出处是 Qin 等人 2023 年。这一页把它当成评测来讲:从 RapidAPI 爬取 6000 多个真实 API,再整理出用到这些 API 的真实人类指令。下面是第 38 页那张流程图。
补充ToolLLM 论文里写的规模是 16,464 个 REST API,分属 RapidAPI 上的 3,451 个工具,49 个类别;标题里的「16k」指的是这个数。
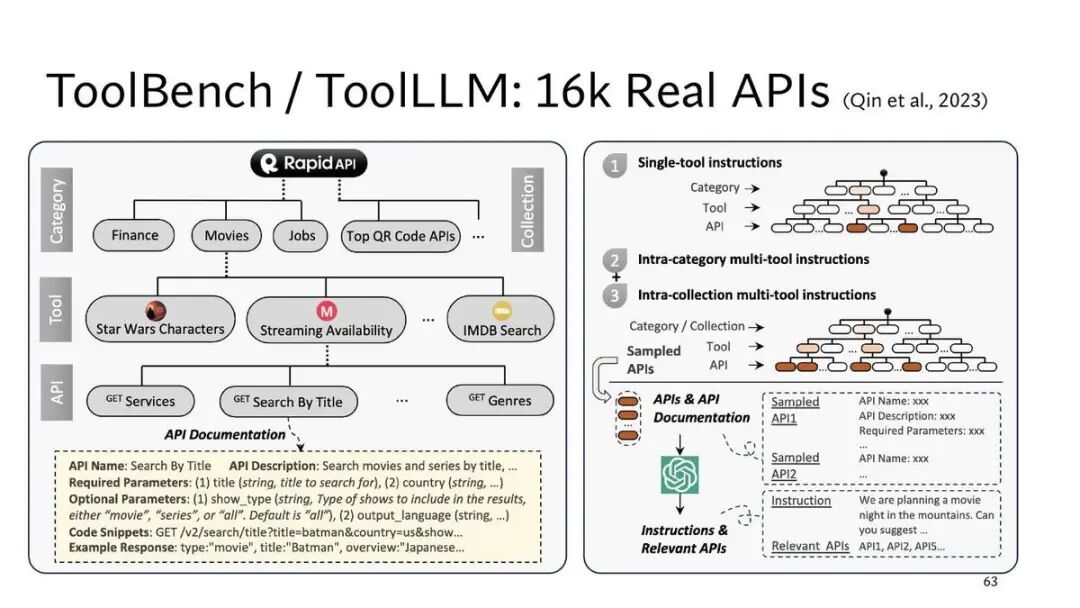
第 62 页是 ToolBench 怎么造指令。
左边是 RapidAPI 的层级:最上面是类别,比如金融,电影,招聘,二维码;类别下面是工具,比如星球大战角色,流媒体可看性,IMDB 搜索;工具下面是具体 API,比如 Services,Search By Title,Genres。每个 API 都有文档,例子是 Search By Title 的文档:必填参数是片名和国家,可选参数是节目类型和输出语言,还有代码片段和示例返回。
右边是三类指令:① 单工具指令;② 同一类别内的多工具指令;③ 同一合集内的多工具指令。做法是抽几个 API 和它们的文档交给 ChatGPT,让它写出指令,并标出相关的 API。例子是「我们打算在山里办一个电影之夜,能推荐……」,相关 API 是 API1,API2,API5。
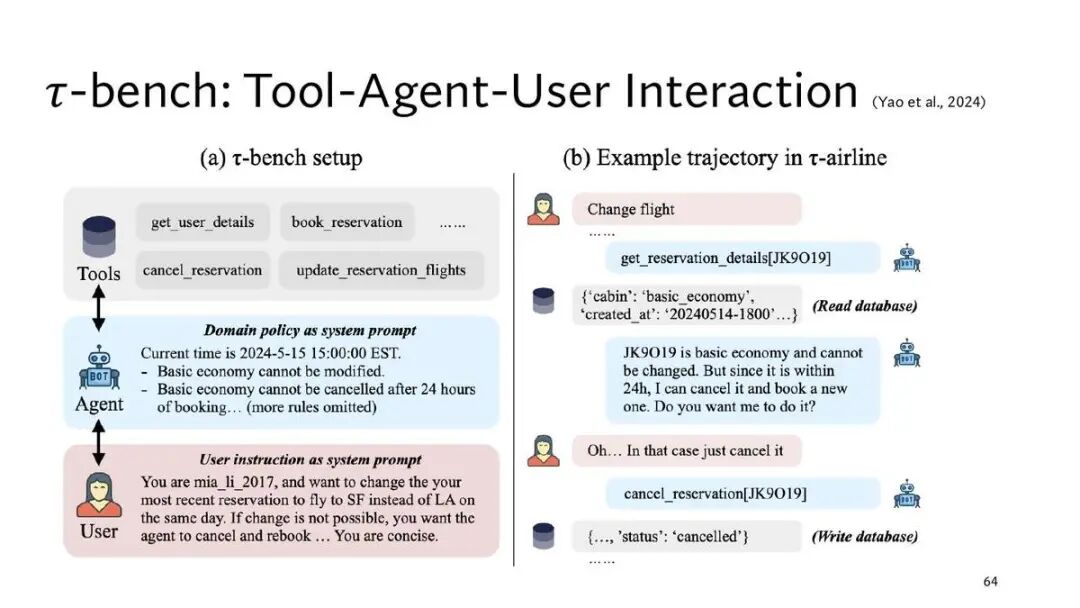
第 63 页是 τ-bench,测工具,agent 和用户三方的交互,出处是 Yao 等人 2024 年。
左边是设置。工具有 get_user_details,book_reservation,cancel_reservation,update_reservation_flights 等。agent 的系统提示是领域规则,例子是:当前时间 2024 年 5 月 15 日 15:00(美东);基础经济舱不能改签;基础经济舱订票超过 24 小时后不能取消。用户也是一个模型扮演的,它的系统提示是:你是 mia_li_2017,想把最近一次订票改成当天飞旧金山而不是洛杉矶,改不了的话就取消重订,说话简洁。
右边是航空领域的一条轨迹。用户说「改航班」。agent 调用 get_reservation_details 查订单 JK9O19,读数据库得到舱位是基础经济舱,订票时间是 2024 年 5 月 14 日 18:00。agent 回复:这张票是基础经济舱,不能改签,但还在 24 小时内,可以取消再订一张新的,要我这样做吗?用户说「那就直接取消吧」。agent 调用 cancel_reservation,数据库里这张票的状态被写成 cancelled。
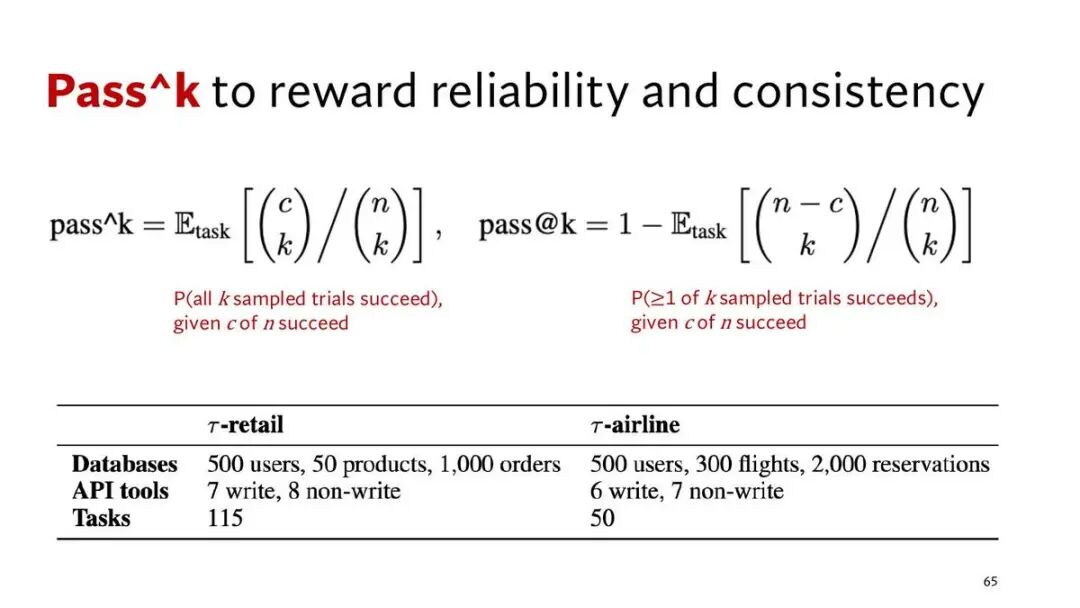
第 64 页讲 τ-bench 的指标 pass^k,标题是「用 pass^k 奖励可靠和一致」。
两个公式。pass^k 是:同一道题跑 n 次,成功 c 次,随机抽 k 次全部成功的概率,再对所有题取平均。pass@k 是:抽 k 次至少成功一次的概率。
下面的表是两个领域的规模。零售:数据库里有 500 个用户,50 种商品,1,000 个订单;API 工具 7 个写操作,8 个只读操作;115 道题。航空:500 个用户,300 个航班,2,000 个订单;6 个写操作,7 个只读操作;50 道题。
补充pass@k 常用在代码生成上,k 次里对一次就算过,k 越大分数越高。pass^k 反过来,要 k 次都对才算过,k 越大分数越低,量的是同一个任务每次都能做对的稳定性。
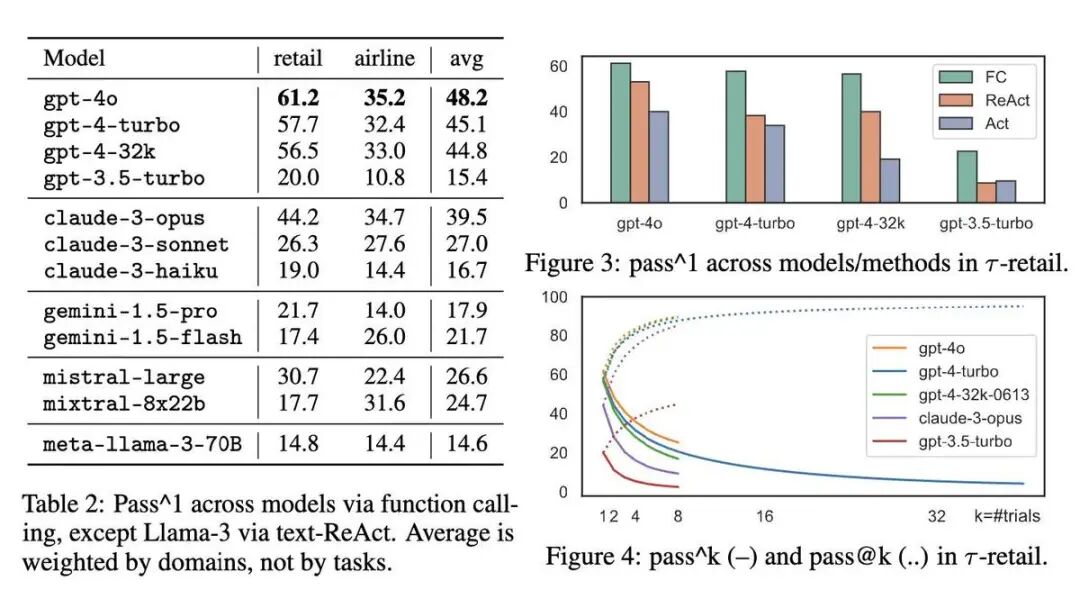
第 65 页是 τ-bench 论文里的结果。
左边的表是 pass^1,也就是每道题平均做对的比例,除 Llama-3 用文本 ReAct 外,其余都用函数调用。平均值按领域加权,不按题数。gpt-4o 最高:零售 61.2,航空 35.2,平均 48.2。claude-3-opus:44.2,34.7,平均 39.5。gpt-3.5-turbo:20.0,10.8,平均 15.4。meta-llama-3-70B:14.8,14.4,平均 14.6。所有模型在航空领域都没超过 36。
右上的图在零售领域比较三种方法:函数调用(FC),ReAct,只行动不思考(Act)。四个 GPT 模型上都是函数调用最高。
右下的图在零售领域画了 pass^k(实线)和 pass@k(虚线),横轴是试验次数 k,从 1 到 32 以上。虚线随 k 往上走,实线往下走。gpt-4o 的实线从 k=1 时的 60 左右降到 k=8 时的 25 左右。
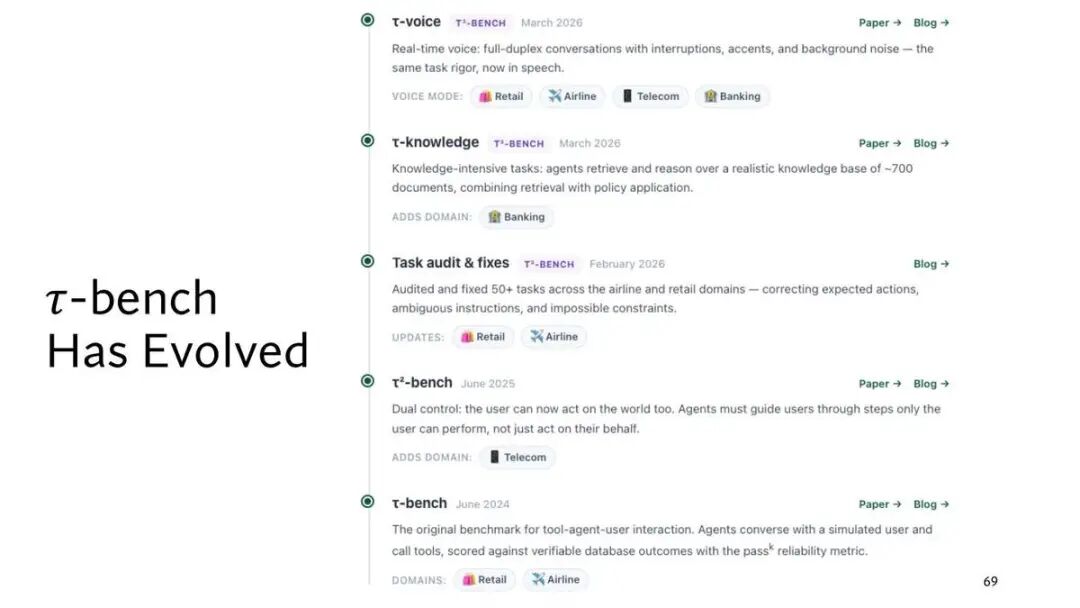
第 66 页的标题是「τ-bench 一直在演进」,是一条时间线,从下往上:
2024 年 6 月,τ-bench:最初的版本,测工具,agent 和用户的交互。agent 和模拟用户对话,调用工具,按可验证的数据库结果打分,用 pass^k 衡量可靠性。领域是零售和航空。
2025 年 6 月,τ²-bench:双重控制,用户现在也能对环境动手。agent 要引导用户完成那些只有用户自己能做的步骤,不能只替用户操作。新增电信领域。
2026 年 2 月,任务审计和修正:审计并修正了航空和零售领域 50 多道题,改正了期望动作,有歧义的指令和不可能满足的约束。
2026 年 3 月,τ-knowledge:知识密集的任务,agent 要在一个约 700 篇文档的真实知识库上检索和推理,把检索和执行规则结合起来。新增银行领域。
2026 年 3 月,τ-voice:实时语音,全双工对话,有打断,口音和背景噪声,任务要求不变,只是换成了语音。语音模式覆盖零售,航空,电信,银行四个领域。
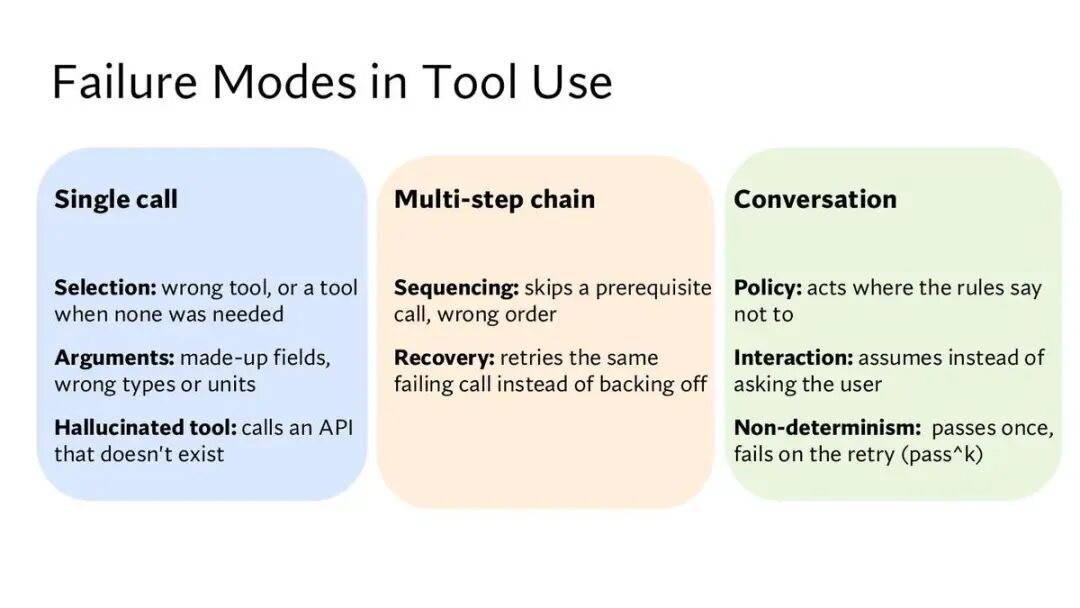
第 67 页把工具使用的失败模式分成三层,和第 4 页 RAG 的三栏图排法一样。
单次调用:选择错,选错了工具,或者不需要工具时也去调;参数错,编出不存在的字段,类型或单位写错;幻觉工具,调用一个根本不存在的 API。
多步调用链:顺序错,跳过了前置的调用,或者顺序颠倒;恢复错,一个调用失败了,还反复重试同一个调用,不知道退回来换办法。
对话:违反规则,在规则说不能做的地方做了;交互错,该问用户的时候自己做了假设;不确定性,这次过了,重试一次又失败,也就是 pass^k 要量的东西。
最后
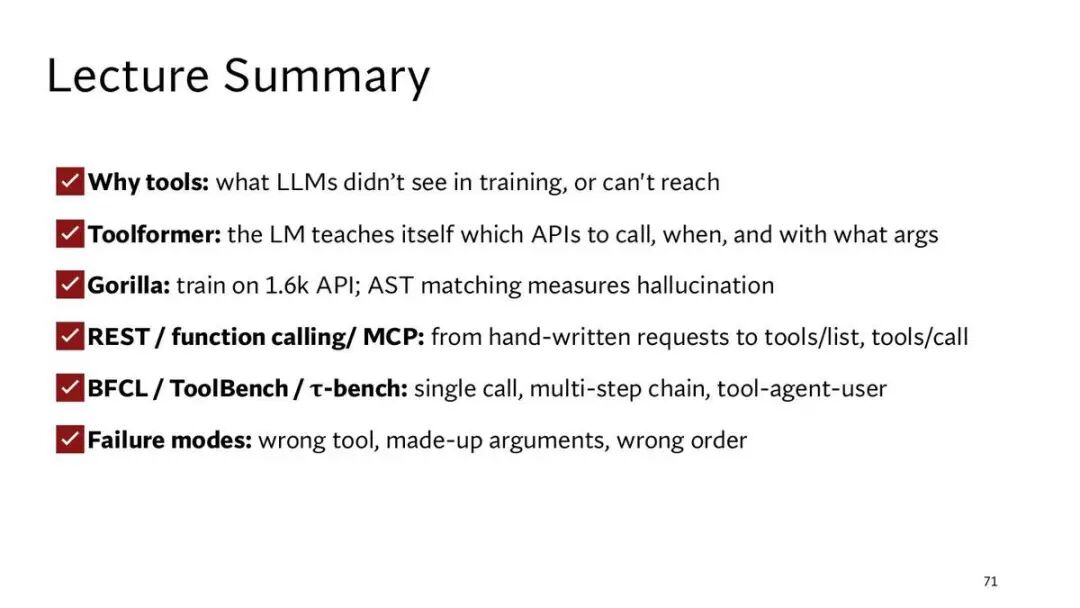
第 68 页是这一讲的总结,六条。按这六条,把这一讲压成几段话:
为什么要工具:有些东西模型训练时没见过,有些地方它够不着。第 15 到 17 页的例子是乘法:位数一多,GPT-4 和 o1-mini 的准确率都掉到接近 0。
模型怎么学会调用工具。Toolformer 让模型自己决定调哪个 API,什么时候调,传什么参数:先在文本里采样候选调用,执行,再用损失过滤,只留下能帮模型预测后文的那些,拿这份数据微调 GPT-J。ToolkenGPT 把每个工具变成一个新 token,只学这些 token 的嵌入。
工具多起来以后。Gorilla 在 1,600 多个 API 上训练,用检索感知训练让模型在检索结果不好时也不被带偏,用 AST 子树匹配来量化编出不存在 API 的幻觉。ToolLLM 把规模推到 1.6 万个 API,配一个 API 检索器。
标准接口:从 REST 时模型自己手写请求,到函数调用时模型按 JSON schema 输出工具名和参数,再到 MCP 用 tools/list 发现工具,用 tools/call 执行工具,一个服务器写一次,不同的宿主应用都能用。
评估:BFCL 测单次调用,ToolBench 测多步调用链,τ-bench 测工具,agent 和用户三方的交互,用 pass^k 看能不能每次都做对。
失败模式:选错工具,编造参数,顺序错。
据课程官网,这一讲的必读是 MCP 规范,Linux 基金会 2025 年版,第 51 到 54 页讲的 tools/list 和 tools/call 都出自这份协议:
https://modelcontextprotocol.io/specification/2025-06-18
按官网课表,下一讲是 10 月 7 日的「Frameworks & Orchestration」,内容包括 DSPy(签名,模块,优化器),LangChain/LangGraph,LlamaIndex;框架替你抽象掉了什么,和你从零搭的相比差在哪;以及怎样选合适的抽象层级。必读是 DSPy 的论文。
本文是斯坦福 CS 329Z《Engineering AI Agents》(Fall 2026)第 4 讲课件的逐页讲解,非官方笔记,内容以课件原件为准。课件版权归讲师 Diyi Yang、Michael Ryan、John Yang。课程主页 https://cs329z.stanford.edu/ ,本讲课件 PDF https://web.stanford.edu/class/cs329z/slides/lecture04.pdf (链接来自课程主页课表里第 4 讲的 Slides)。

内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢