

---------------------
课程 | 2026年斯坦福CS 329Z《Agent工程》| 第4讲:工具调用
课程 | 2026年斯坦福CS 329Z《Agent工程》| 第3讲:检索增强生成(RAG)
课程 | 2026年斯坦福CS 329Z《Agent工程》| 第2讲:给开发者的LLM原理
课程 | 2026年斯坦福CS 329Z《Agent工程课》| 第1讲:智能体系统入门
---------------------
这是「斯坦福 Agent 工程课」系列的第 5 篇。课程是 Stanford 2026 年秋季的 CS 329Z《Engineering AI Agents》,讲师是 Diyi Yang、Michael Ryan 和 John Yang。课件在课程官网公开,我每讲写一篇,按课件逐页讲,一页不跳。
第 5 讲在官网课表上是 10 月 7 日,标题是「Frameworks & Orchestration」,一共 132 页。课上有几段现场写代码的演示,课件给每段演示都配了备用页,这类页一共 59 页,多数是代码截图。这份课件的页面上没有印页码,本文的页码一律按 PDF 算。
这一讲要回答的问题,写在第 6 页的学习目标里:agent 工程里常用的框架有哪些,这些框架引入的抽象和前几讲讲过的系统设计怎样对应,以及怎样判断各种编排和可靠性工具有没有用。
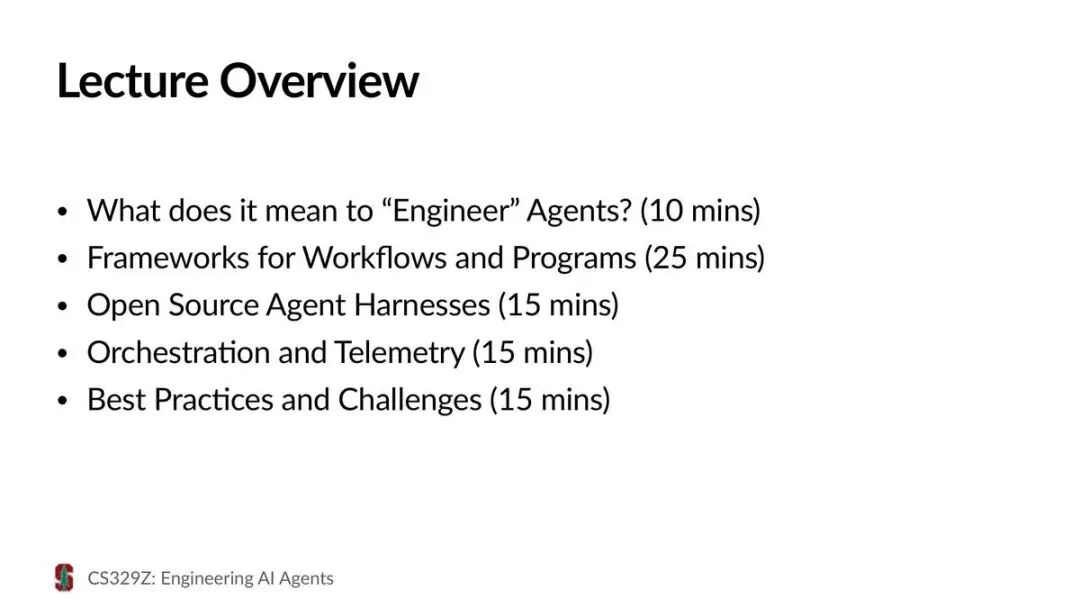
下面是这一讲的大纲,一共五块:什么叫「工程化」agent,工作流与程序的框架,开源 agent 脚手架,编排与遥测,最佳实践与挑战。括号里是课上分给它的分钟数。第二块内容最多,本文拆成 DSPy 和 LangGraph 两节来讲,其余按课件顺序走。
开场
开场先用 PyTorch 打了个比方:框架把底层细节藏起来,这一讲学的就是框架提供的抽象。
第 1 页是封面,标题是 Frameworks & Orchestration,讲师一栏是三位老师。
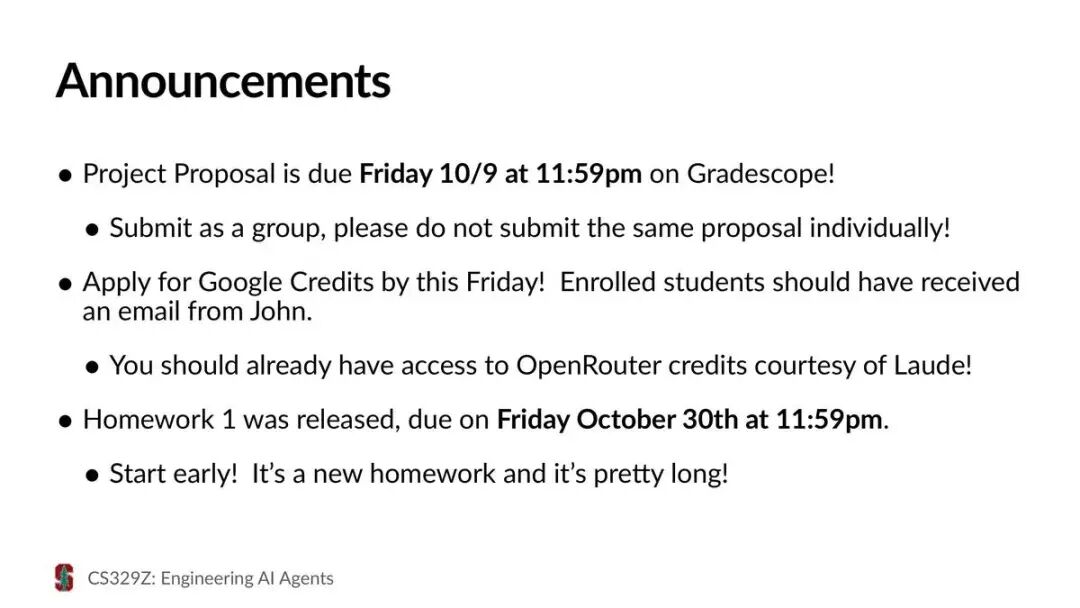
第 2 页是通知,三条。项目开题报告 10 月 9 日(周五)晚上 11:59 在 Gradescope 上截止,按小组交,同一份不要每个人各交一次。本周五前申请 Google 的算力额度,选课学生应该已经收到 John 的邮件;OpenRouter 的额度应该已经能用,由 Laude 提供。作业 1 已经发布,10 月 30 日(周五)晚上 11:59 截止,课件提醒早点开始,这是一份新作业,而且相当长。
补充Gradescope 是一个在线交作业和批改的平台。OpenRouter 是一个模型 API 的聚合服务,用一个密钥就能调用多家厂商的模型。
第 3 页是一个现场小调查:在座有谁用过 PyTorch?
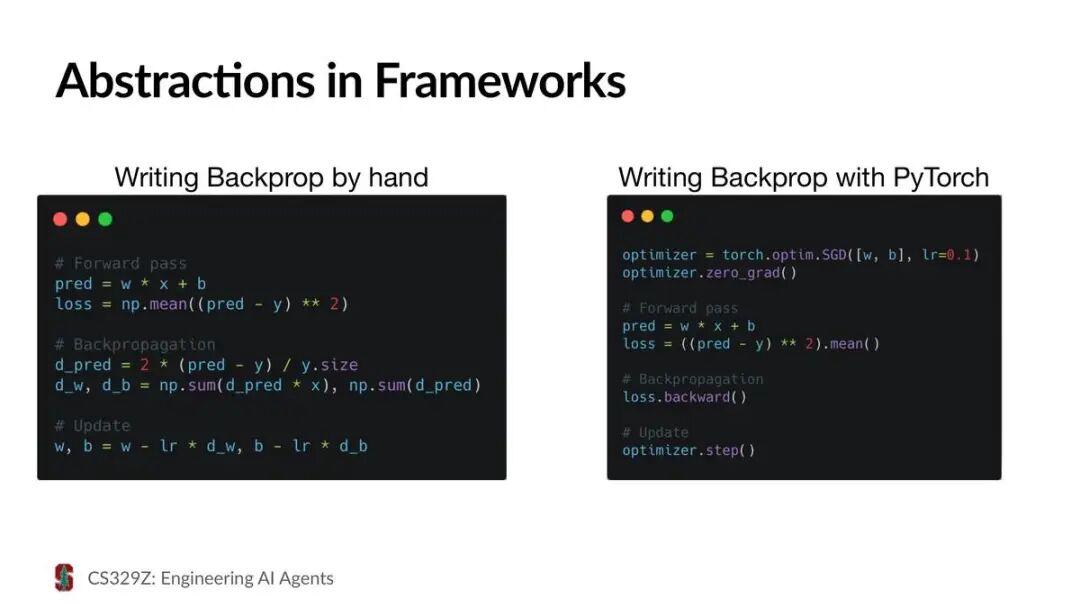
第 4 页的标题是「框架里的抽象」,左右两段代码做同一件事:训练一个 pred = w * x + b 的线性模型。
左边是手写反向传播:先算前向和损失,再自己写出对 w 和 b 的梯度公式,最后手动更新参数。右边是用 PyTorch 写:建一个 SGD 优化器,前向和损失照写,梯度只要一行 loss.backward(),更新只要一行 optimizer.step()。
第 5 页是三句话。框架把一部分底层系统细节藏了起来。在这门课剩下的部分,你必须自己实现,理解那些系统细节。今天的目标是学会这些抽象。
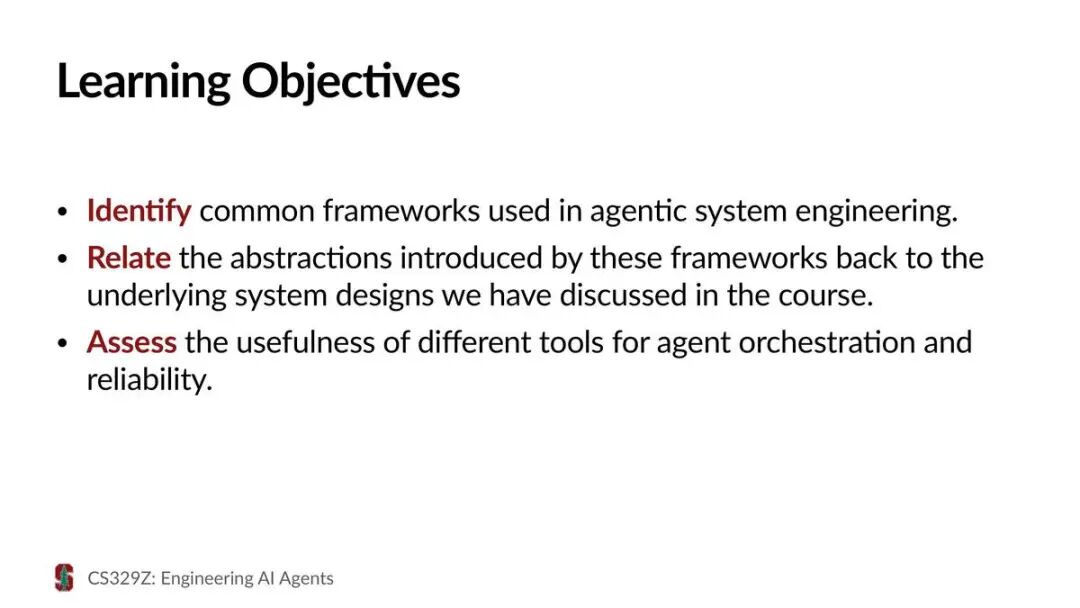
第 6 页是学习目标,三条:认出 agent 系统工程里常用的框架;把这些框架引入的抽象,和课上讲过的底层系统设计对应起来;评估不同工具在 agent 编排和可靠性上有多大用处。
第 7 页是大纲,已经放在本文开头。
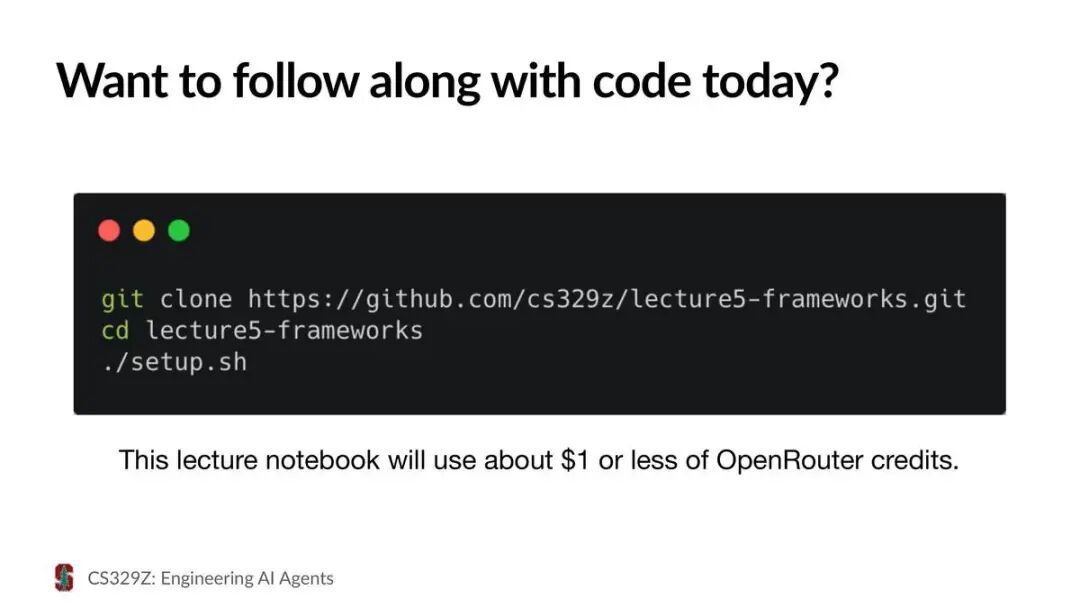
第 8 页告诉学生怎样跟着写代码:克隆 https://github.com/cs329z/lecture5-frameworks ,进目录,运行 ./setup.sh。课件写明,这份课堂 notebook 大约花 1 美元或更少的 OpenRouter 额度。
一、什么叫「工程化」agent
这一块给出一个三栏框架:数据,系统,评估。只做系统是「AI 系统」,三样一起做才是「AI 系统工程」。框架则按控制流交给谁,排在一条从模型到 agent 的光谱上。
第 9 页是这一块的标题页:「工程化」agent 是什么意思?页面底部有一条五段的进度条,对应大纲的五块,当前这块标成红色。后面每块的标题页都有这条进度条。
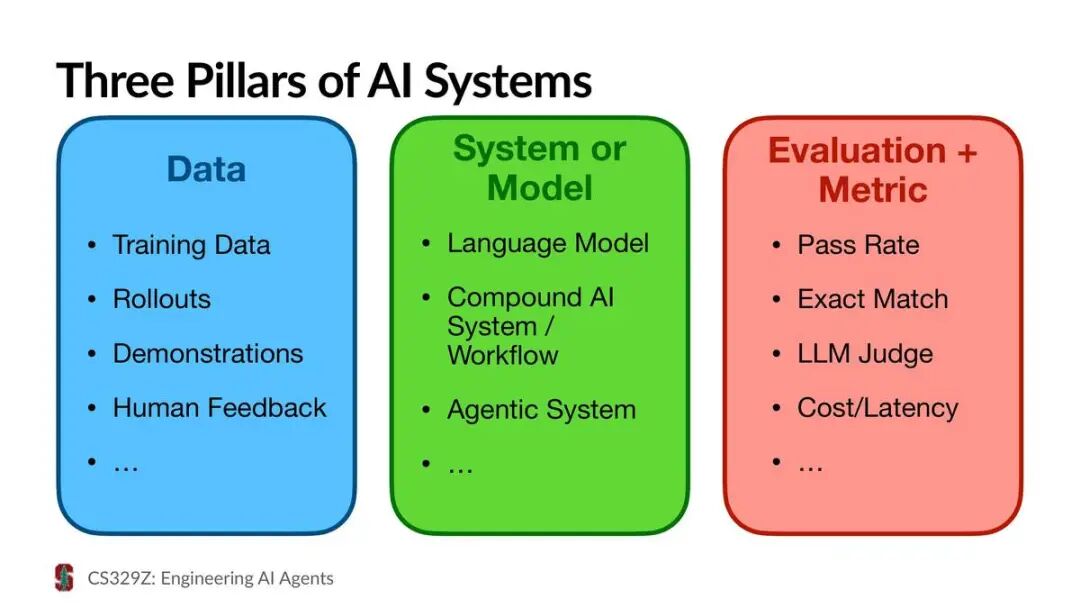
第 10 页是「AI 系统的三根支柱」,三栏。
数据:训练数据,rollout(agent 跑一遍留下的轨迹),示范,人类反馈。
系统或模型:语言模型,复合 AI 系统或工作流,agent 系统。
评估加指标:通过率,精确匹配,LLM 裁判,成本和延迟。
每栏最后都有一个省略号,表示不止这些。
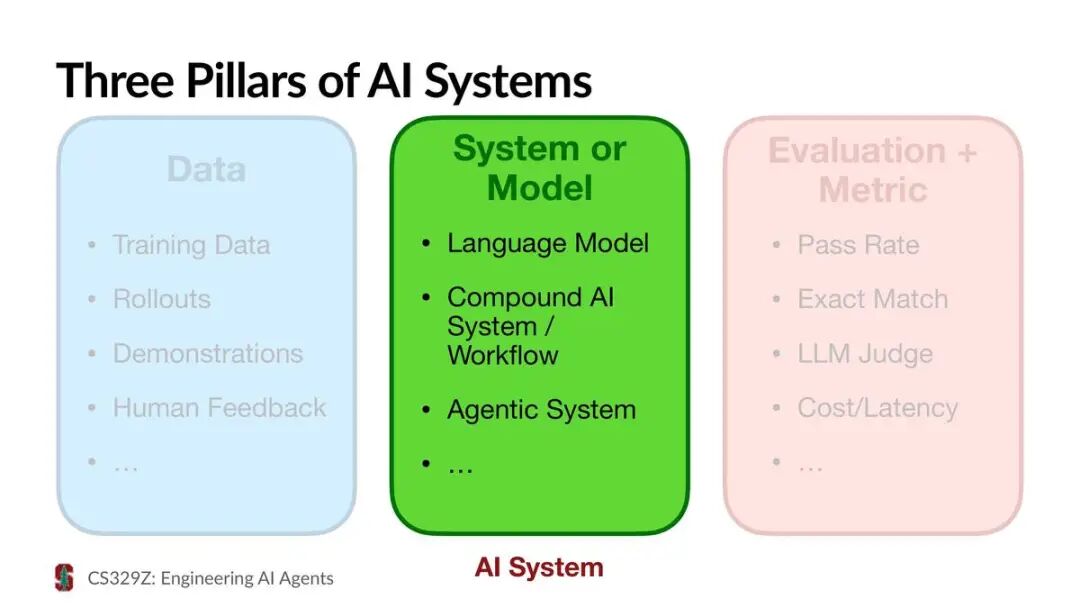
第 11 页把数据和评估两栏调淡,只留中间的「系统或模型」,下面标注:AI System。
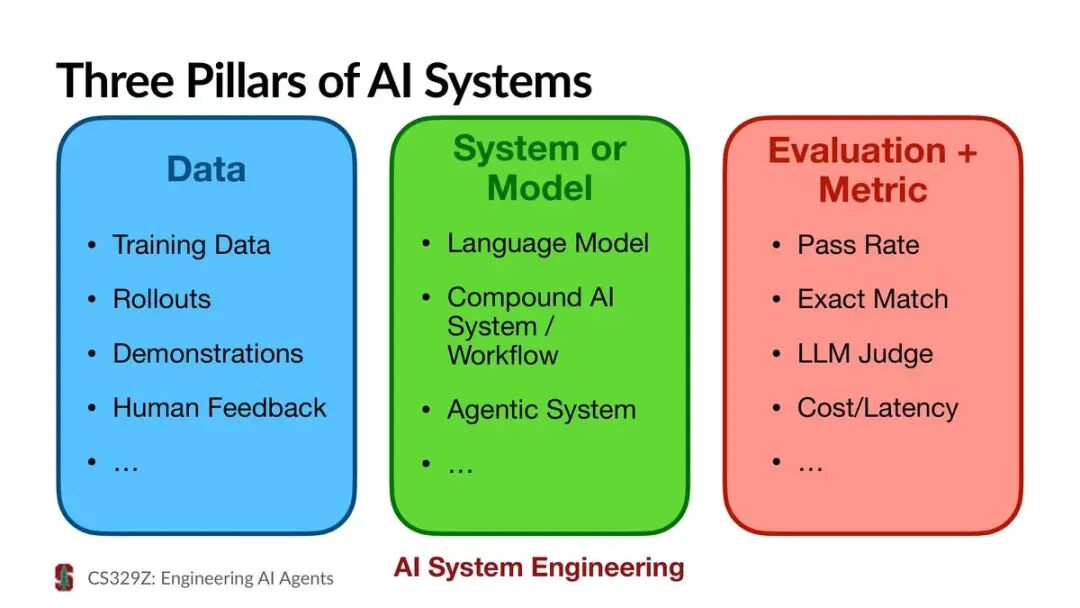
第 12 页三栏都恢复,下面的标注换成 AI System Engineering。前后两页对照着看:只有系统叫 AI 系统,三栏齐了才叫 AI 系统工程。
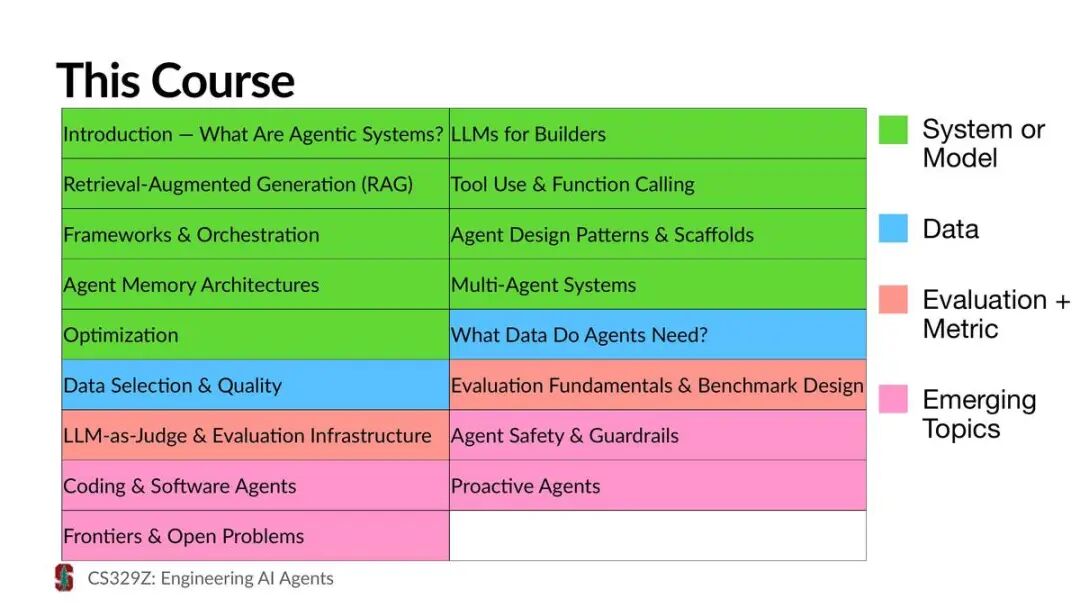
第 13 页把整门课的 17 讲按这三栏上了色。
绿色是系统或模型,从第 1 讲到第 9 讲:导论,面向开发者的 LLM,RAG,工具调用,框架与编排,agent 设计模式与脚手架,agent 记忆架构,多 agent 系统,优化。
蓝色是数据,两讲:agent 需要什么数据,数据选择与质量。
橙红色是评估加指标,两讲:评估基础与基准设计,LLM 裁判与评估基础设施。
粉色是新兴话题,四讲:agent 安全与护栏,编码与软件 agent,主动型 agent,前沿与开放问题。
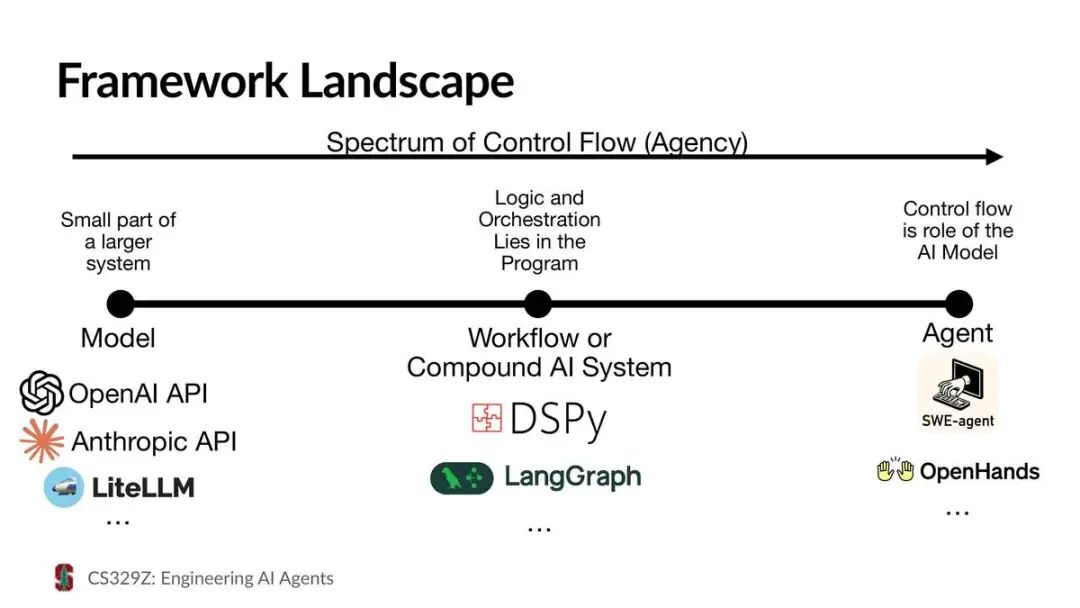
第 14 页是「框架版图」。上方是一条箭头,标题是「控制流(自主程度)的光谱」,光谱上有三个点。
左端是模型,它只是一个更大系统里的一小部分,例子是 OpenAI API,Anthropic API,LiteLLM。
中间是工作流或复合 AI 系统,逻辑和编排写在程序里,例子是 DSPy 和 LangGraph。
右端是 agent,控制流交给 AI 模型,例子是 SWE-agent 和 OpenHands。
补充LiteLLM 是一个 Python 库,用同一套接口调用多家厂商的模型。SWE-agent 是一个让语言模型在代码仓库里修 bug 的 agent,讲师 John Yang 是这个项目论文的第一作者。
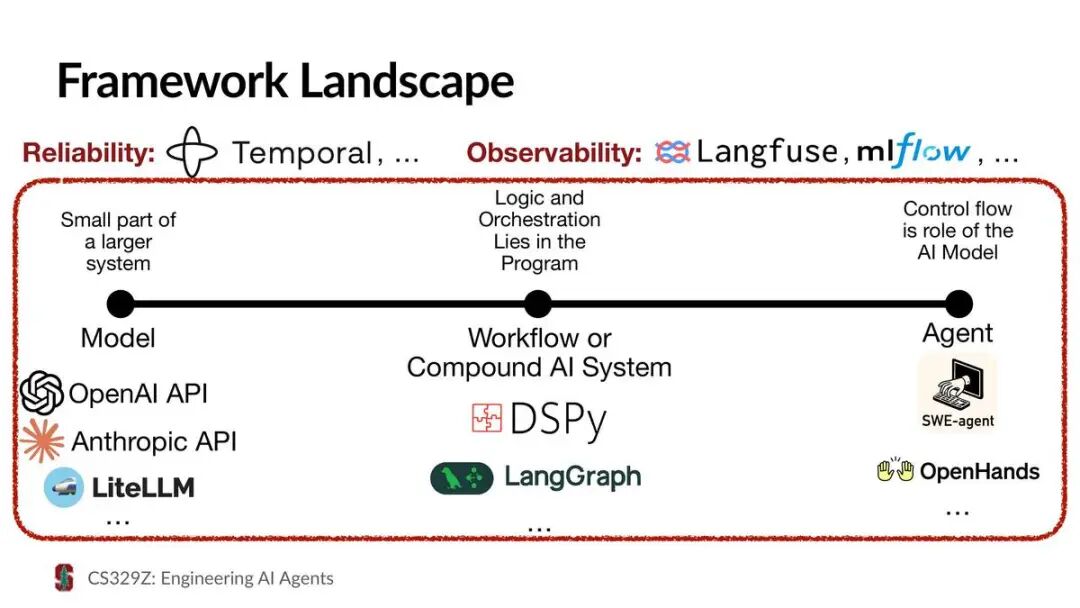
第 15 页在光谱上方加了一行:可靠性方面有 Temporal 等,可观测性方面有 Langfuse,MLflow 等。光谱这一块用红框圈了起来。
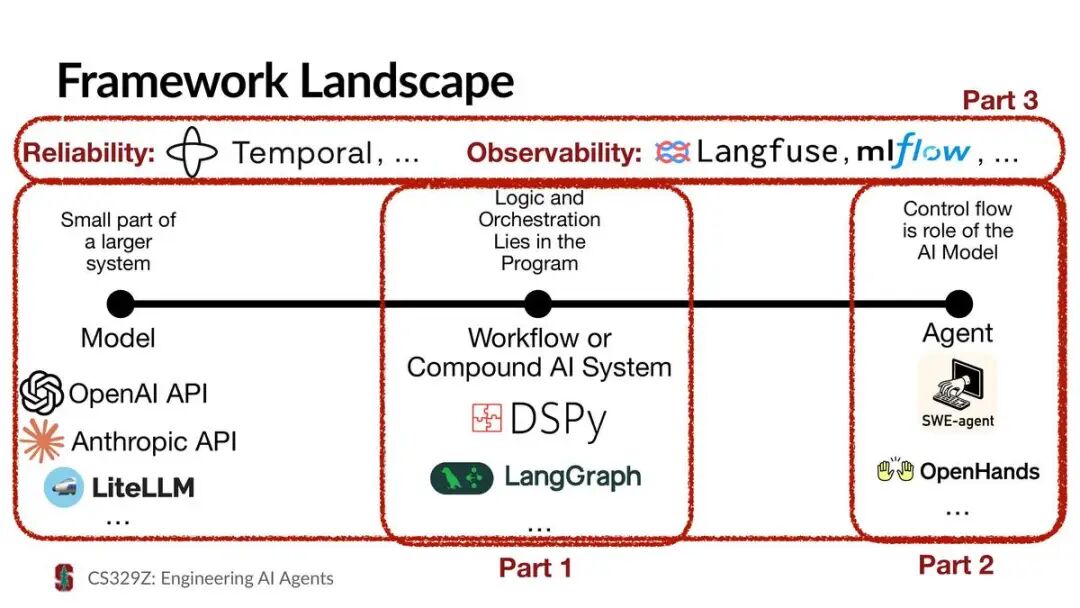
第 16 页把版图分成三部分,对应这一讲后面的三块:Part 1 是中间的工作流,Part 2 是右端的 agent,Part 3 是上方的可靠性和可观测性。
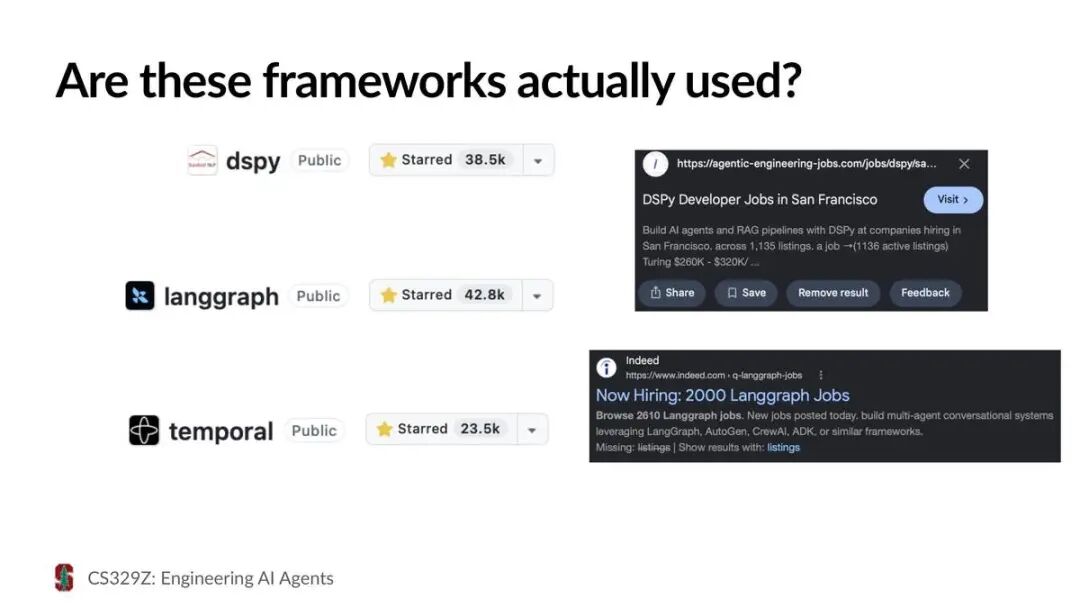
第 17 页问:这些框架真的有人用吗?
左边是三个 GitHub 仓库的星数:dspy 38.5k,langgraph 42.8k,temporal 23.5k。右边是两张招聘搜索结果的截图:一张是旧金山的 DSPy 开发岗位,写着 1,135 个职位;一张是 Indeed 上的「现招 2000 个 LangGraph 职位」,下面一行写的是浏览 2610 个 LangGraph 职位。
第 18 页是这一块的小结,四条。工程化 AI 系统需要三个核心部分:数据,系统,评估。AI 系统的自主程度是一条光谱,从模型到工作流再到 agent。光谱上每一档都有对应的框架。还有一些框架专门用来提高 agent 的可靠性和可观测性。
二、工作流框架之一:DSPy
DSPy 把一次模型调用拆成三样:签名说要什么,模块说怎么做,优化器用数据和指标去改提示词或权重。课上的演示里,优化器把一个小模型在测试集上的得分从 55% 提到了 100%。
第 19 页是第二块的标题页:工作流与程序的框架。
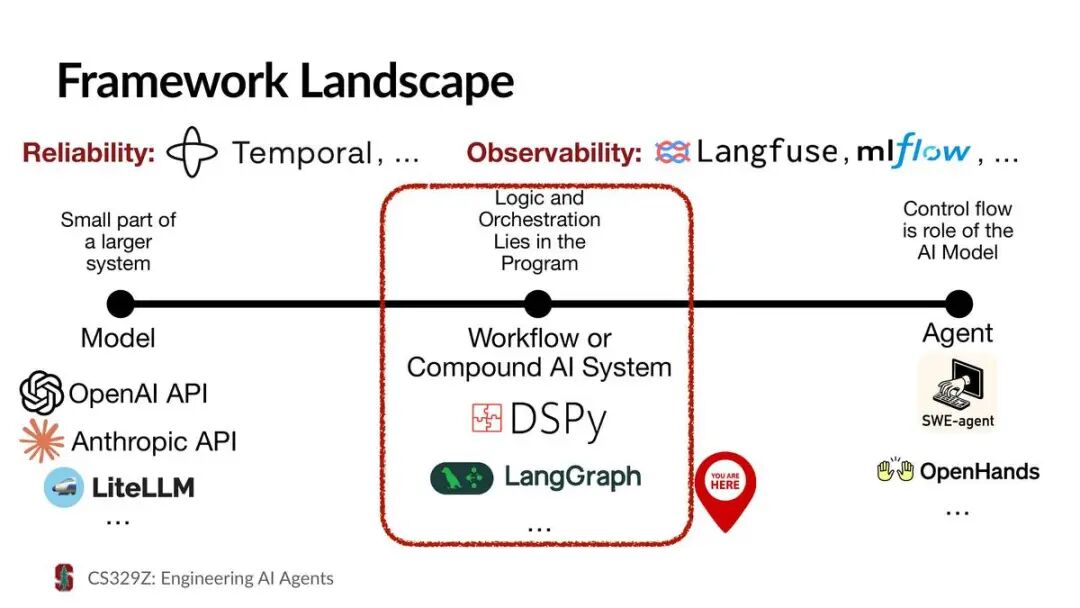
第 20 页回到框架版图,红框圈住中间的「工作流或复合 AI 系统」,旁边插了一个「你在这里」的定位标。
第 21 页是 DSPy 的标志。
补充DSPy 是斯坦福 NLP 组开源的框架,论文第一作者是 Omar Khattab。据课程官网,这篇论文是这一讲的必读,链接放在文末。
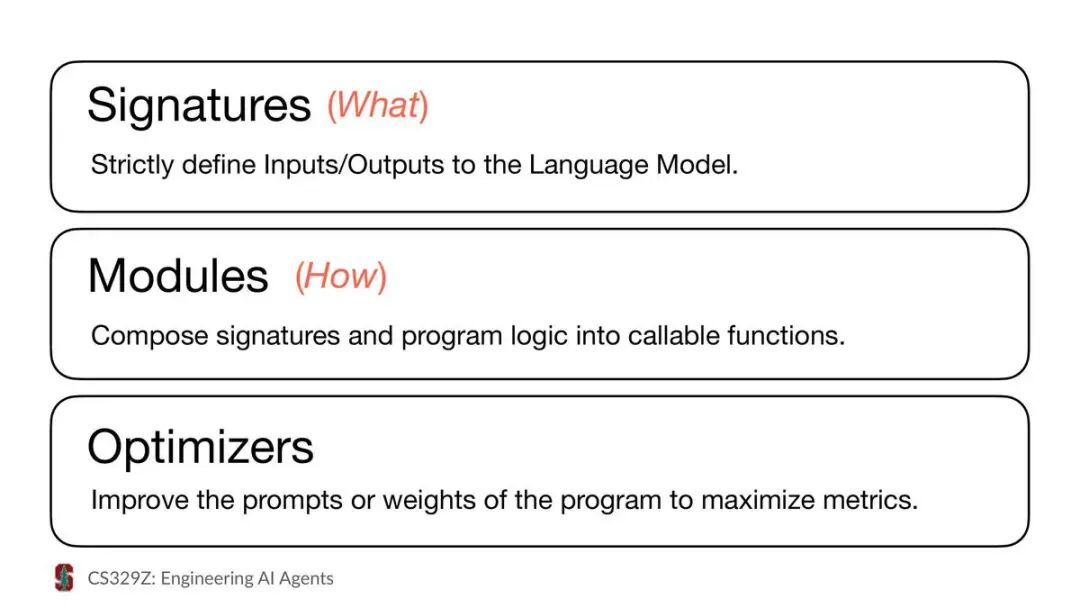
第 22 页列出 DSPy 的三个抽象。
签名(Signatures),对应「做什么」:严格规定语言模型的输入和输出。
模块(Modules),对应「怎么做」:把签名和程序逻辑组合成可以调用的函数。
优化器(Optimizers):改进程序的提示词或权重,让指标最大化。
第 23 页是一个红点加一行字「现场编程演示」,第 24 页是小标题页「签名」。从第 24 页起,演示部分的页面右下角都有一条红色横幅:「这是备用页,以防我们没法现场演示。」
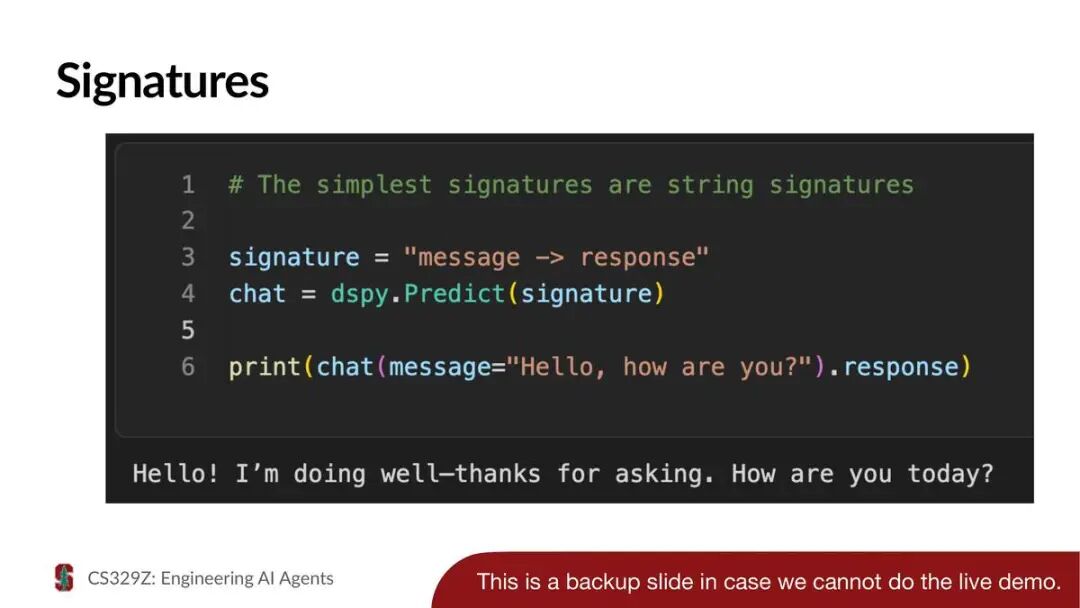
第 25 页是最简单的签名:一个字符串 "message -> response",意思是输入叫 message,输出叫 response。用 dspy.Predict(signature) 包一下,就能直接调用。传入「Hello, how are you?」,模型回了一句寒暄。
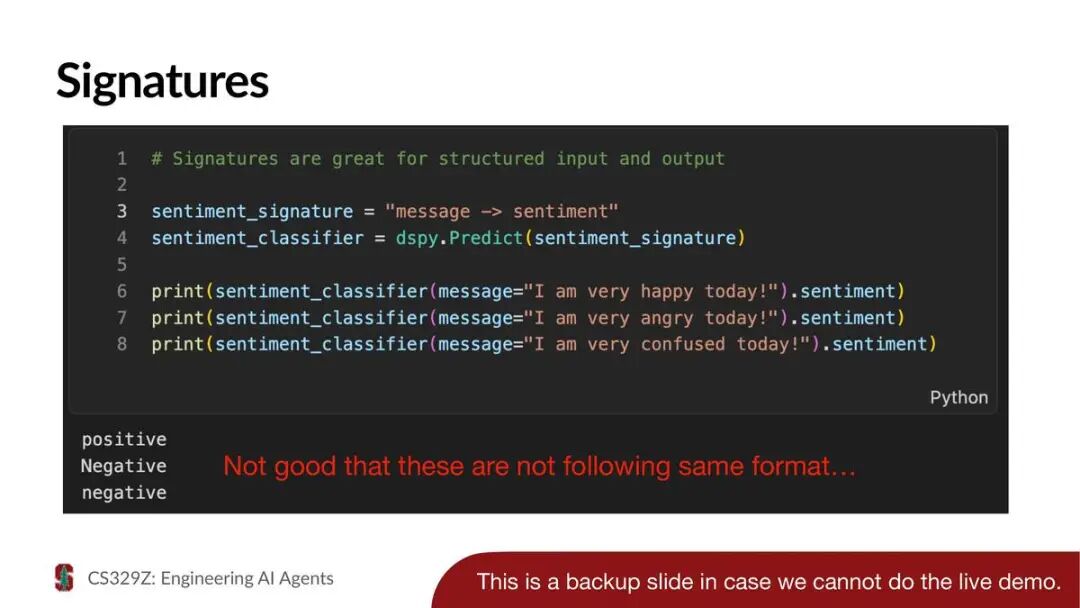
第 26 页的注释是:签名很适合做结构化的输入和输出。签名写成 "message -> sentiment",对三句话做情感分类:我今天很开心,我今天很生气,我今天很困惑。
输出是三行:positive,Negative,negative。课件在旁边用红字写:这几个输出格式不统一,这样不好。
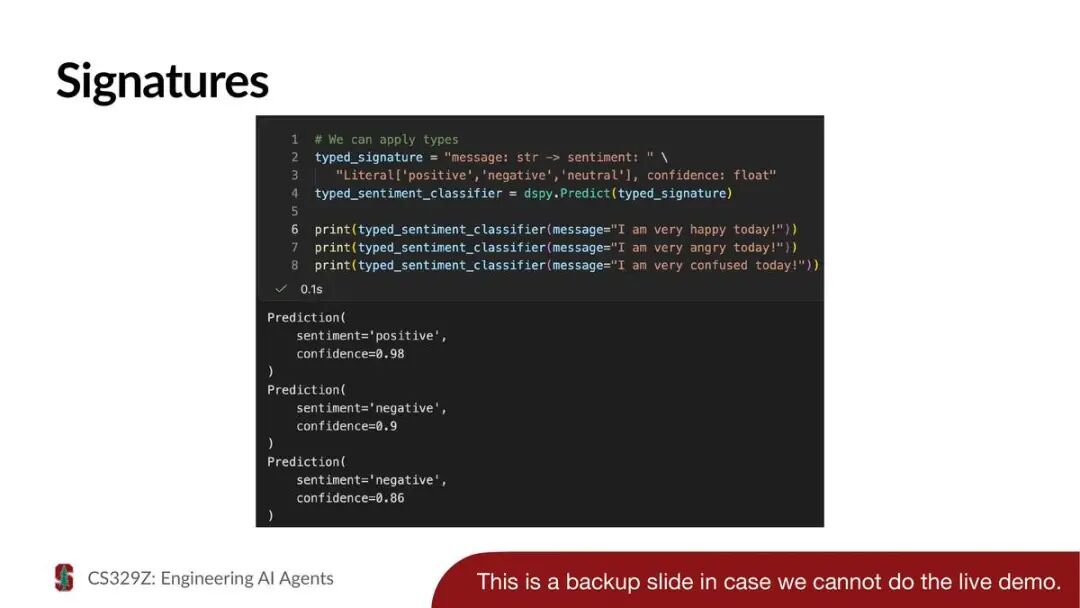
第 27 页给签名加上类型:输入 message 是字符串;输出 sentiment 只能是 'positive','negative','neutral' 三者之一,另外多一个浮点数 confidence。
同样三句话,输出变成三个 Prediction 对象:positive,置信度 0.98;negative,0.9;negative,0.86。
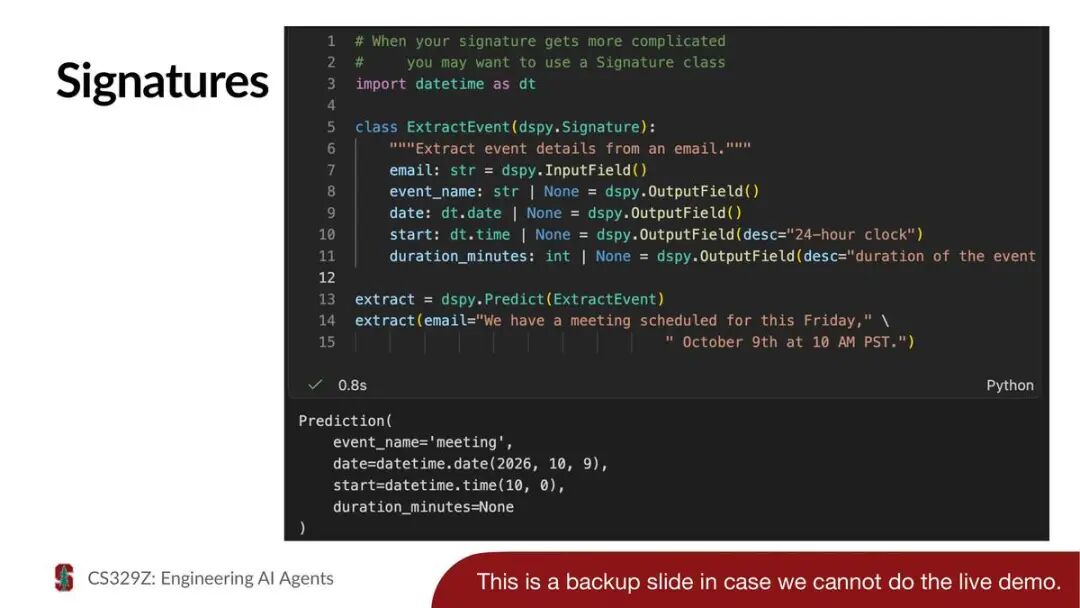
第 28 页的注释是:签名更复杂时,可以写成一个签名类。
ExtractEvent 类的说明文字是「从邮件里抽取事件细节」。输入字段是 email。输出字段有四个:事件名 event_name,日期 date,开始时间 start(描述里写着用 24 小时制),时长 duration_minutes。四个输出都允许为空。
传入的邮件是:「我们这周五,10 月 9 日上午 10 点(太平洋时间)有个会。」输出是:事件名 meeting,日期 2026 年 10 月 9 日,开始时间 10:00,时长为空。
第 29 页是小标题页「模块」。
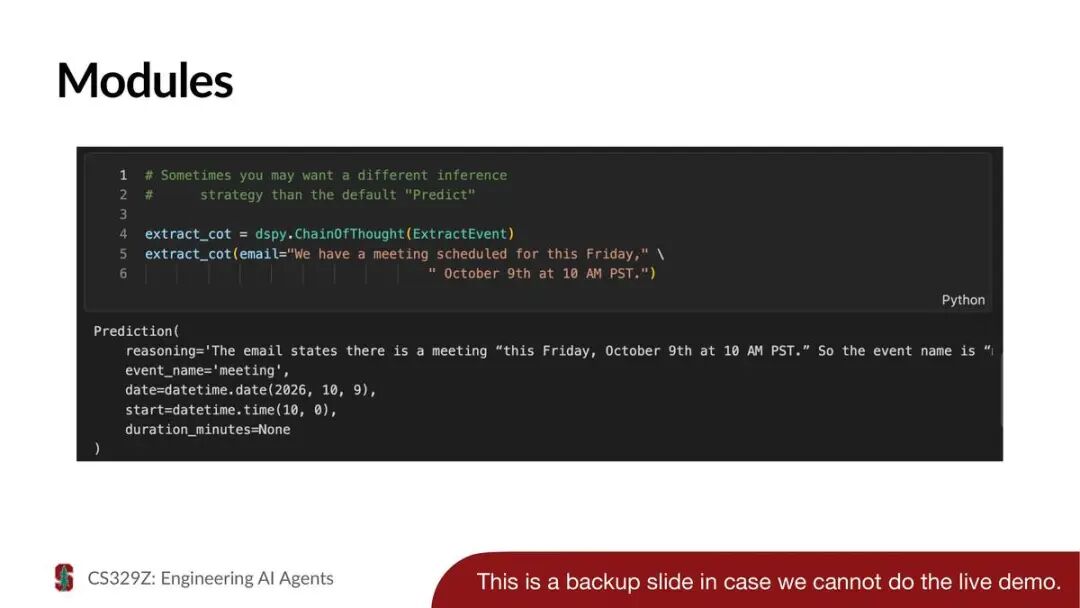
第 30 页的注释是:有时你想用别的推理策略,而不是默认的 Predict。把同一个 ExtractEvent 签名换成 dspy.ChainOfThought 来跑,输出里多了一个 reasoning 字段,先写一段推理,再给出和上一页相同的四个字段。
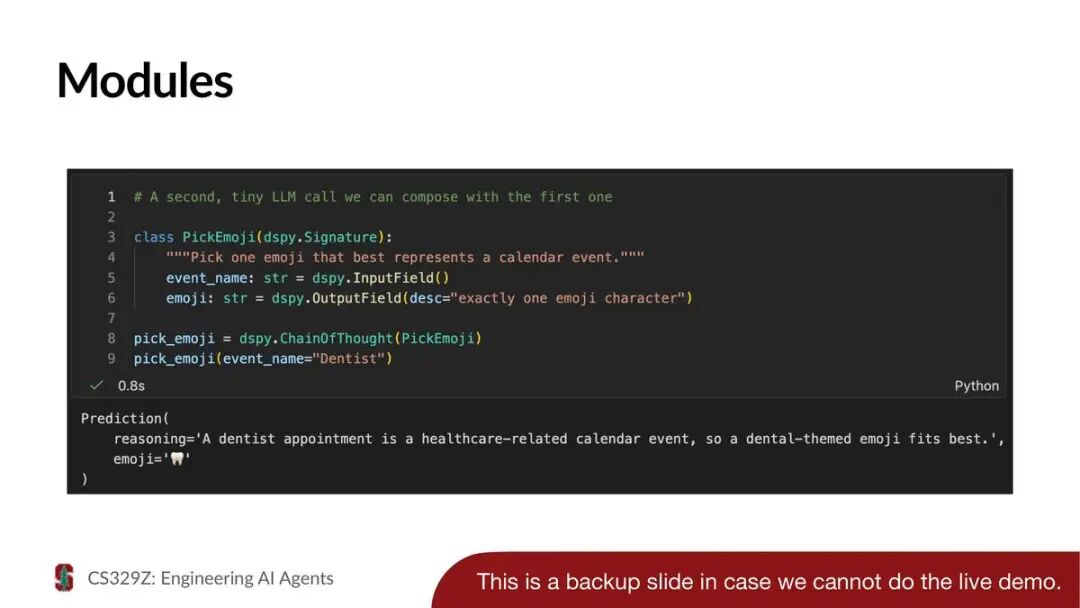
第 31 页又定义了一个很小的签名 PickEmoji:给一个日历事件挑一个最能代表它的 emoji,输出描述写着「正好一个 emoji 字符」。用 ChainOfThought 跑,输入事件名 Dentist(牙医),推理写的是牙医预约是和医疗有关的日历事件,所以选牙齿主题的 emoji,输出是一颗牙。
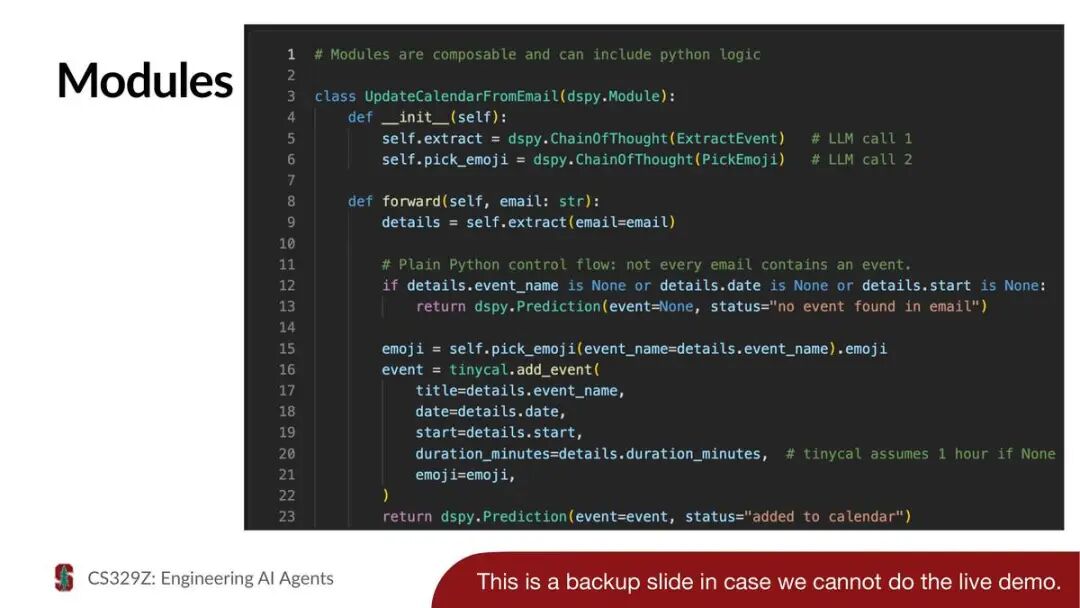
第 32 页的注释是:模块可以组合,也可以包含 Python 逻辑。
UpdateCalendarFromEmail 是一个模块类。初始化时放两个子模块:抽取事件的 ChainOfThought(ExtractEvent) 是第一次 LLM 调用,挑 emoji 的 ChainOfThought(PickEmoji) 是第二次 LLM 调用。
forward 方法里,先从邮件抽取细节。接着是一段普通的 Python 控制流,注释写着「不是每封邮件都含有事件」:事件名,日期,开始时间只要有一个为空,就直接返回「邮件里没找到事件」。否则挑一个 emoji,调用 tinycal.add_event 把事件写进日历,返回「已加入日历」。代码注释还写明,时长为空时 tinycal 默认按 1 小时算。
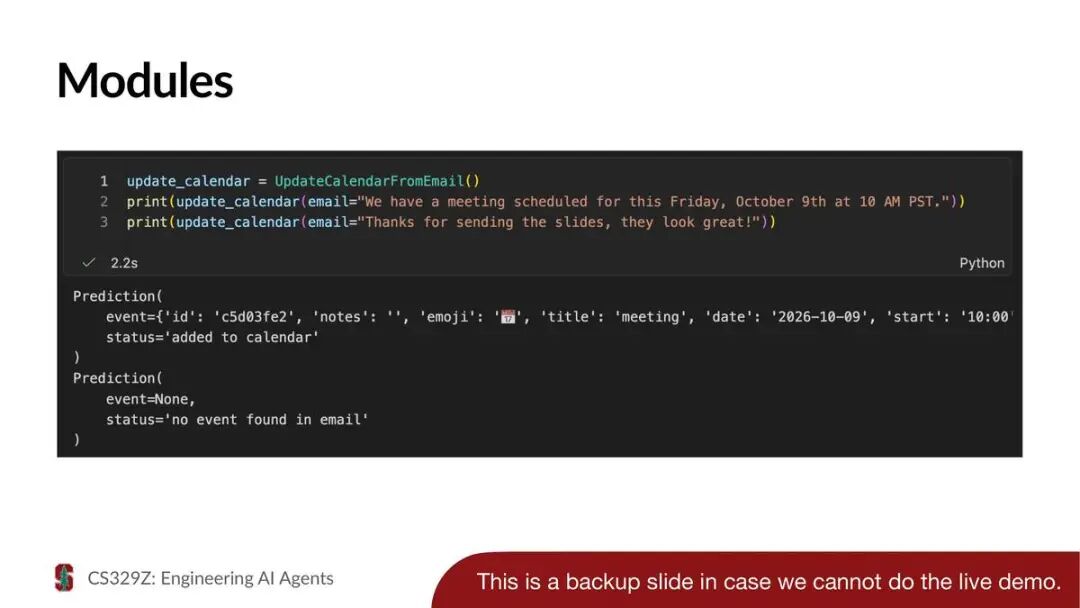
第 33 页运行这个模块,传两封邮件。第一封是周五 10 点开会那封,输出一个事件,标题 meeting,日期 2026-10-09,开始 10:00,状态是已加入日历。第二封是「谢谢你发来的幻灯片,看起来很棒!」,输出事件为空,状态是邮件里没找到事件。
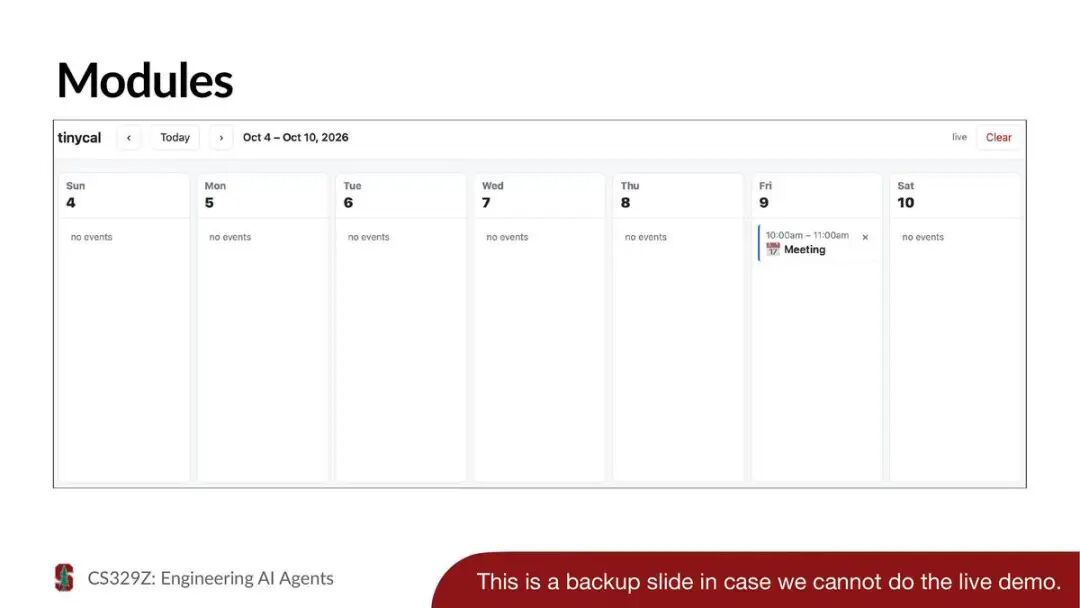
第 34 页是 tinycal 的界面,一个周视图,范围是 2026 年 10 月 4 日到 10 日。周五 9 日那一格出现了 10:00 到 11:00 的 Meeting,其余几天都是空的。
补充tinycal 是这份课堂代码里用来演示的一个小日历应用,后面 LangGraph 和 Temporal 的演示也往同一个日历里写事件。
第 35 页是小标题页「优化器」。
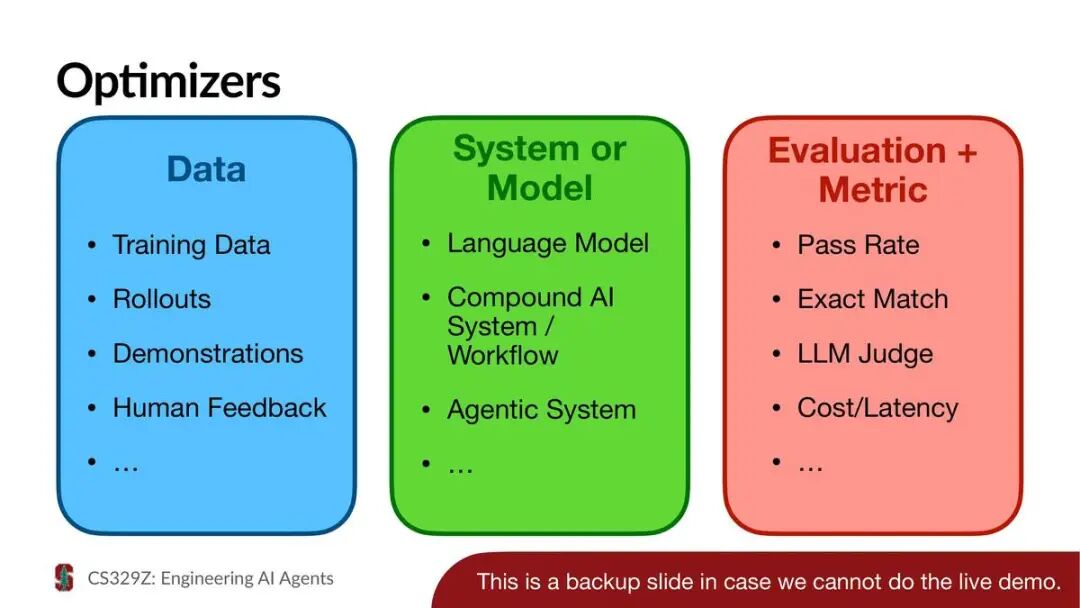
第 36 页的标题是「优化器」,再次放出三根支柱那张图,没有加别的标注。接下来的几页依次是数据,指标和优化。
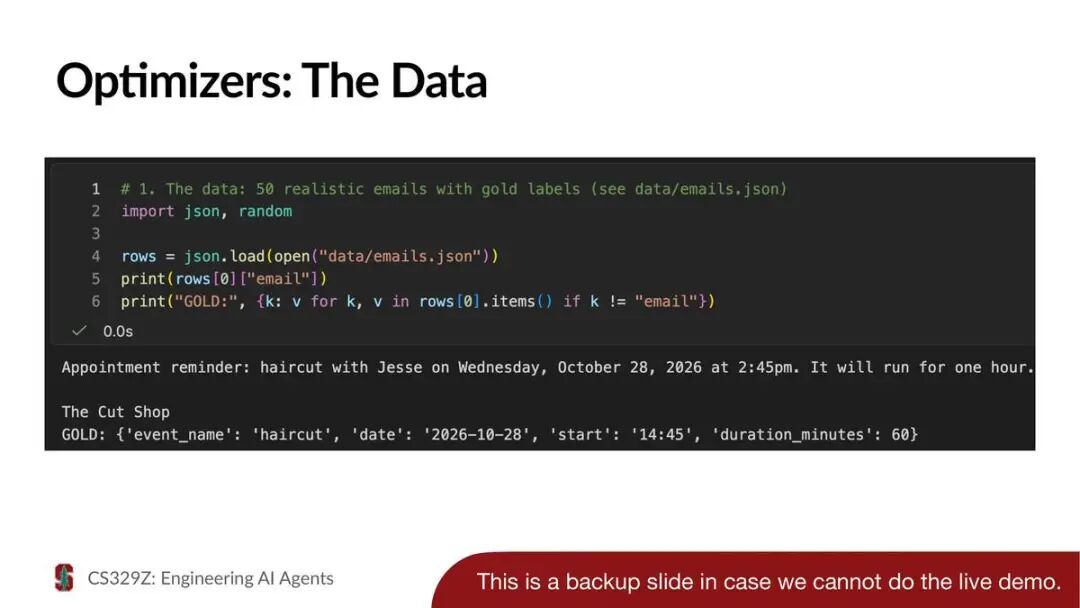
第 37 页是数据,注释写着:50 封真实风格的邮件,带标准答案(gold label)。打印出来的第一封是一条理发预约提醒:2026 年 10 月 28 日周三下午 2:45,和 Jesse 理发,时长一小时。它的标准答案是事件名 haircut,日期 2026-10-28,开始 14:45,时长 60 分钟。
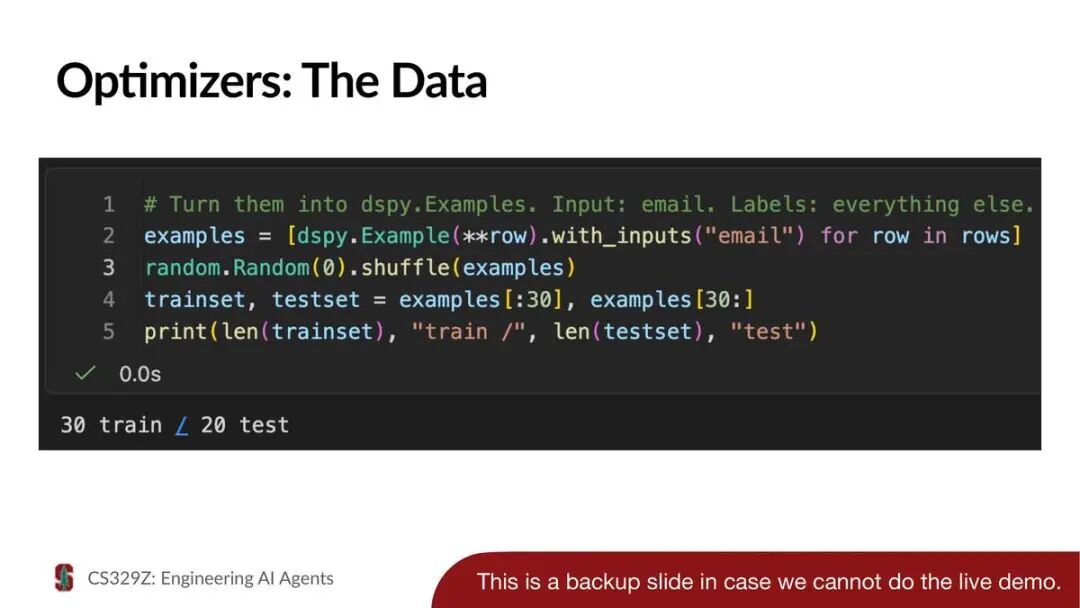
第 38 页把每条数据转成 dspy.Example,输入是 email,其余字段都是标签。用固定的随机种子 0 打乱,前 30 条做训练集,后 20 条做测试集。输出是「30 train / 20 test」。
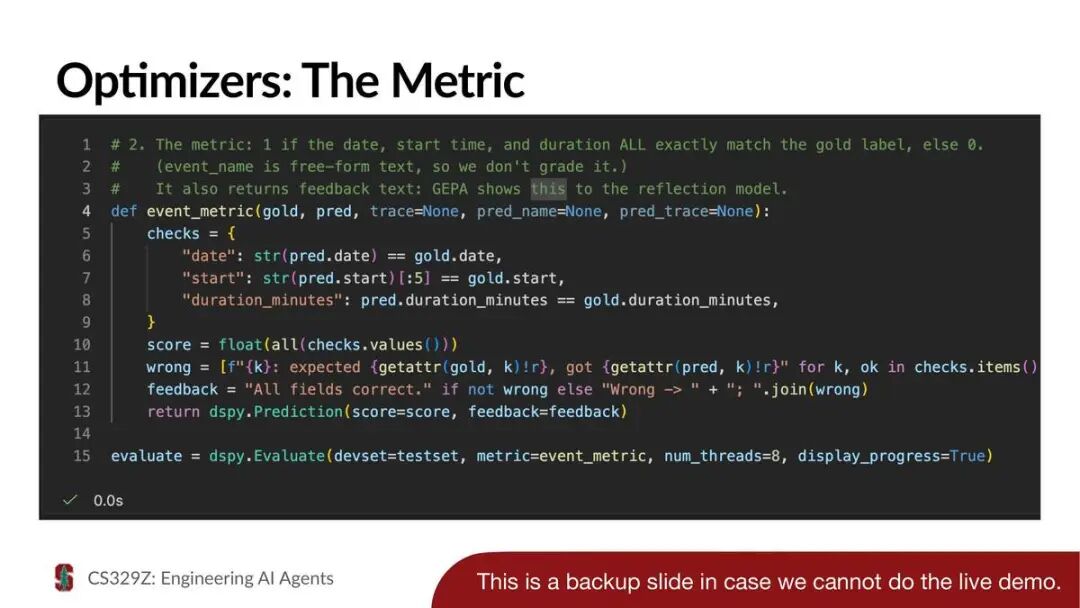
第 39 页是指标。注释写着:日期,开始时间,时长三项全部和标准答案完全一致记 1 分,否则记 0 分;事件名是自由文本,不打分。
event_metric 函数逐项比对这三个字段,算出分数。它还会生成一段反馈文字:全对就写「所有字段正确」,否则列出哪个字段期望是什么,实际是什么。注释写着,这段反馈是 GEPA 拿给反思模型看的。最后用 dspy.Evaluate 在测试集上跑这个指标,8 个线程并行。
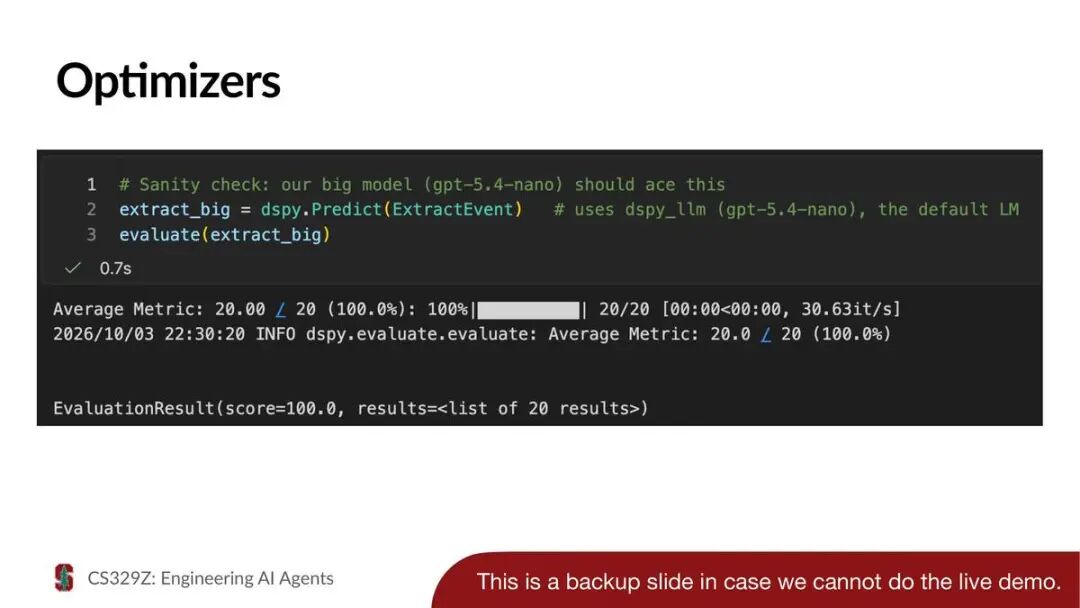
第 40 页先做一次健全性检查,注释写着:我们的大模型应该能全对。默认的大模型是 gpt-5.4-nano,用 Predict 直接跑 ExtractEvent,测试集上 20 条全对,100%。
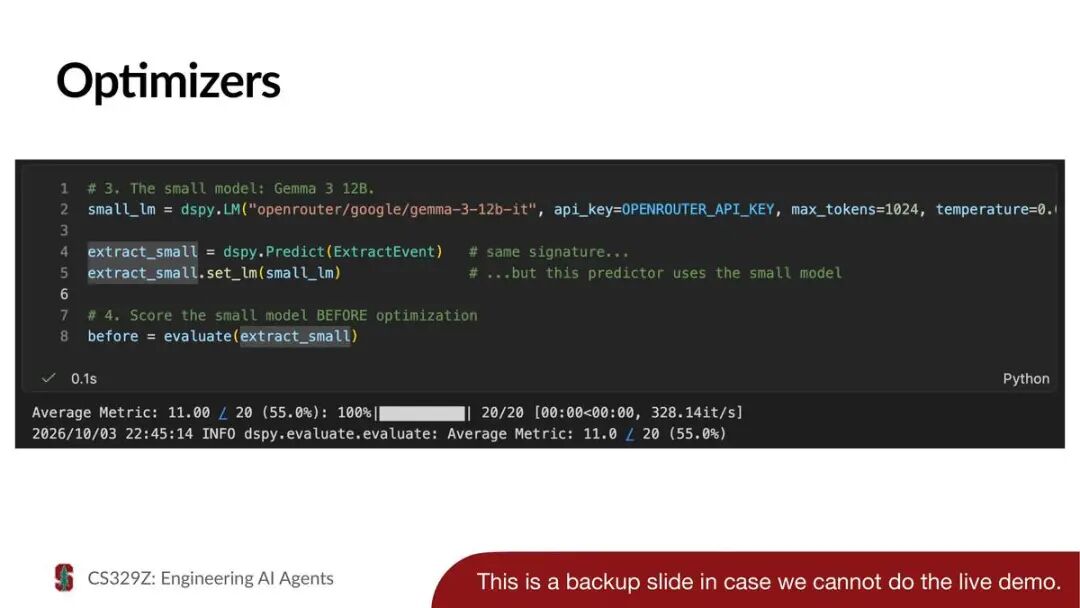
第 41 页换小模型:通过 OpenRouter 调用的 Gemma 3 12B。签名不变,只把这个预测器的模型换成小模型。优化前打分,20 条对 11 条,55%。
补充Gemma 3 是 Google 发布的开放权重模型系列,12B 指 120 亿参数。
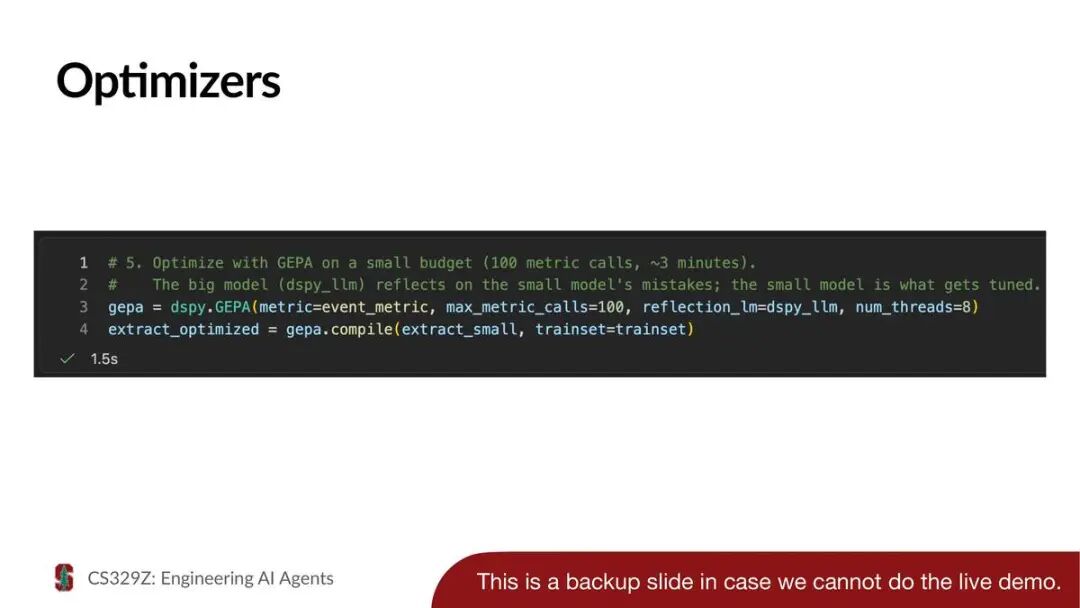
第 42 页用 GEPA 优化,注释写着:小预算,100 次指标调用,大约 3 分钟。大模型对小模型犯的错做反思,被调优的是小模型。代码里 GEPA 的参数是指标函数 event_metric,最多 100 次指标调用,反思模型用大模型,8 个线程;然后对小模型的程序在训练集上编译。
补充GEPA 是一种 prompt 优化方法,用模型对执行轨迹做反思,再据此改写提示词。按官网课表,第 9 讲「优化」会专门讲 GEPA。
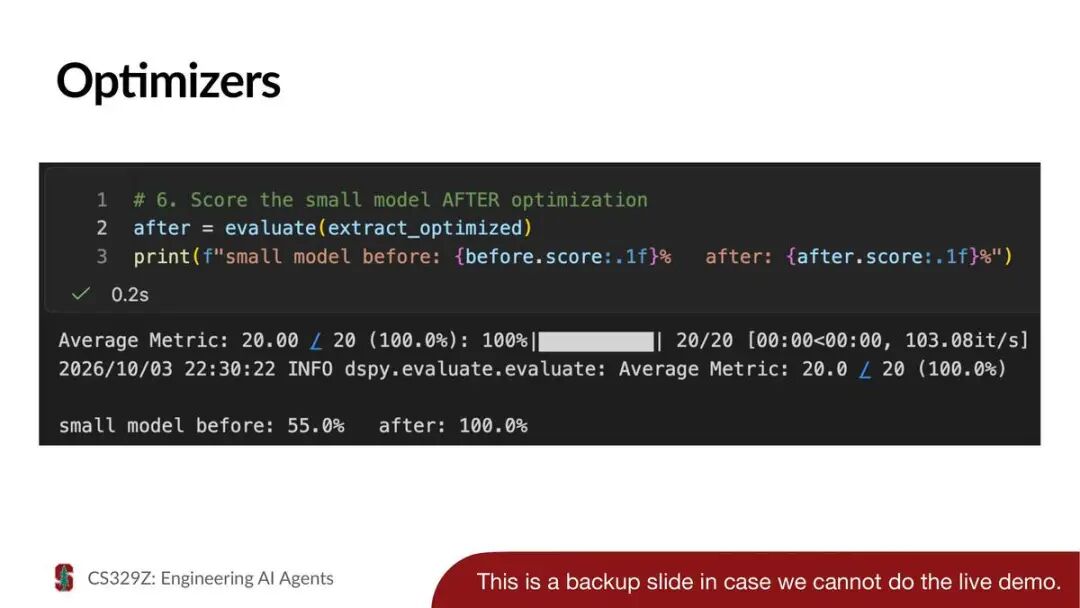
第 43 页对优化后的小模型再打分:20 条全对,100%。最后一行打印的是:small model before: 55.0%,after: 100.0%。
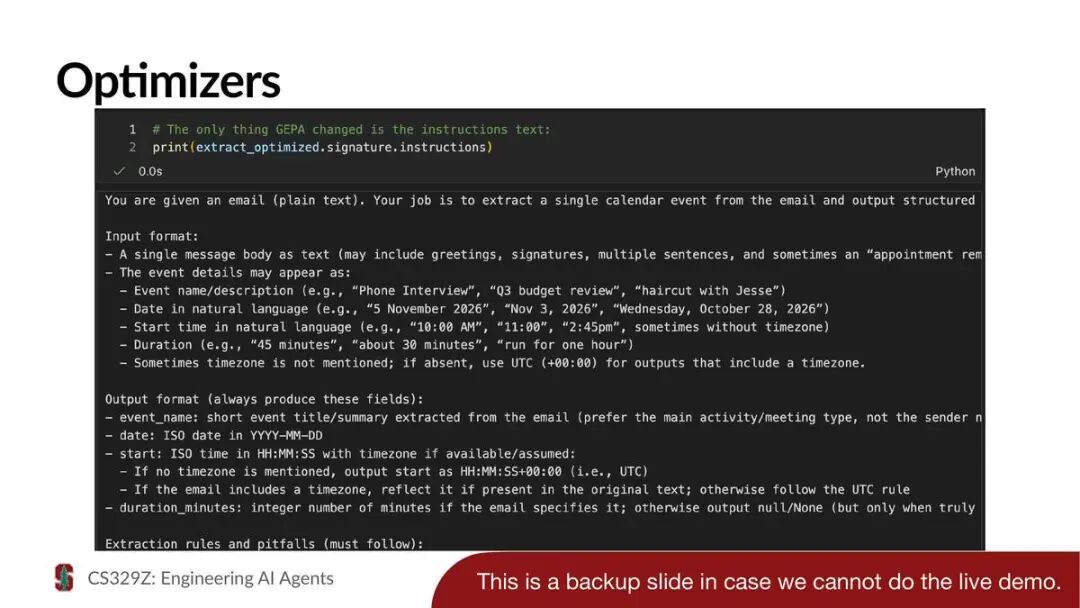
第 44 页的注释是:GEPA 唯一改动的是指令文本。打印出优化后的签名指令,开头是:你会拿到一封纯文本邮件,你的任务是从中抽取一个日历事件,并按结构化格式输出。
下面分几段写得很细。输入格式一段,列出事件名,日期,开始时间,时长在邮件里可能的写法,比如日期可能写成「5 November 2026」「Nov 3, 2026」「Wednesday, October 28, 2026」,时长可能写成「45 minutes」「about 30 minutes」「run for one hour」;没提时区就按 UTC。输出格式一段,规定每个字段的格式,比如日期用 YYYY-MM-DD,时长用整数分钟,邮件里没写才输出空。再往下是「抽取规则和易错点(必须遵守)」,截图到这里截断。
第 45 页是小标题页「Agent」。
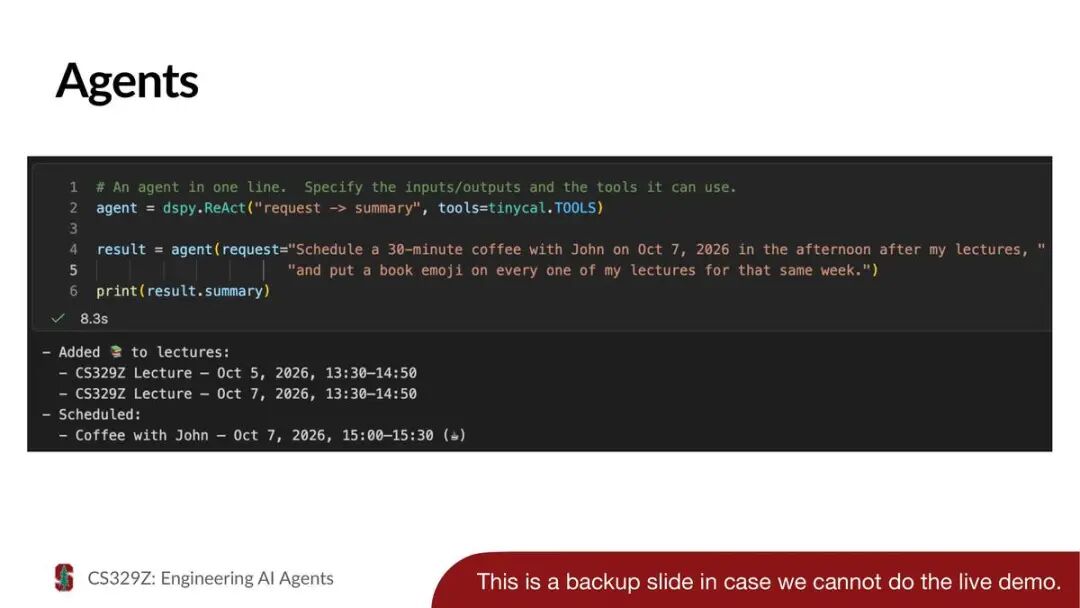
第 46 页的注释是:一行代码一个 agent,写清输入输出和它能用的工具就行。代码是 dspy.ReAct("request -> summary", tools=tinycal.TOOLS)。
给它的请求是:「10 月 7 日下午我上完课以后,安排一个和 John 的 30 分钟咖啡;再给我那一周的每节课都加一个书本 emoji。」用时 8.3 秒,输出的总结分两部分:给两节课加了书本 emoji,分别是 10 月 5 日和 10 月 7 日的 13:30 到 14:50;安排了和 John 的咖啡,10 月 7 日 15:00 到 15:30。
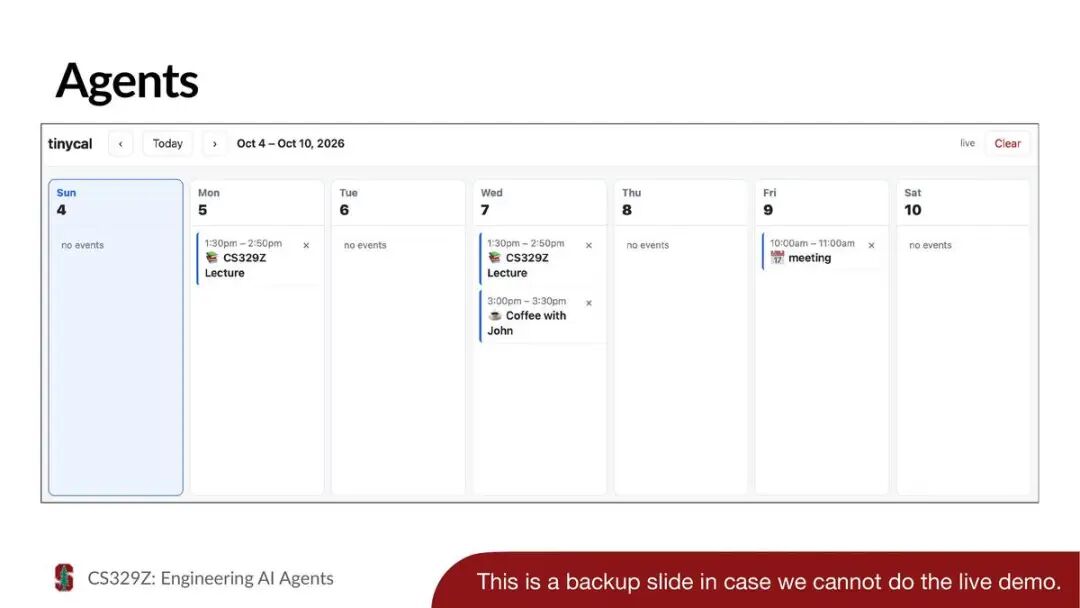
第 47 页是 agent 跑完后的日历:周一 5 日和周三 7 日各有一节 CS329Z 课,下午 1:30 到 2:50,带书本 emoji;周三课后 3:00 到 3:30 是和 John 的咖啡;周五 9 日还是之前那个会。
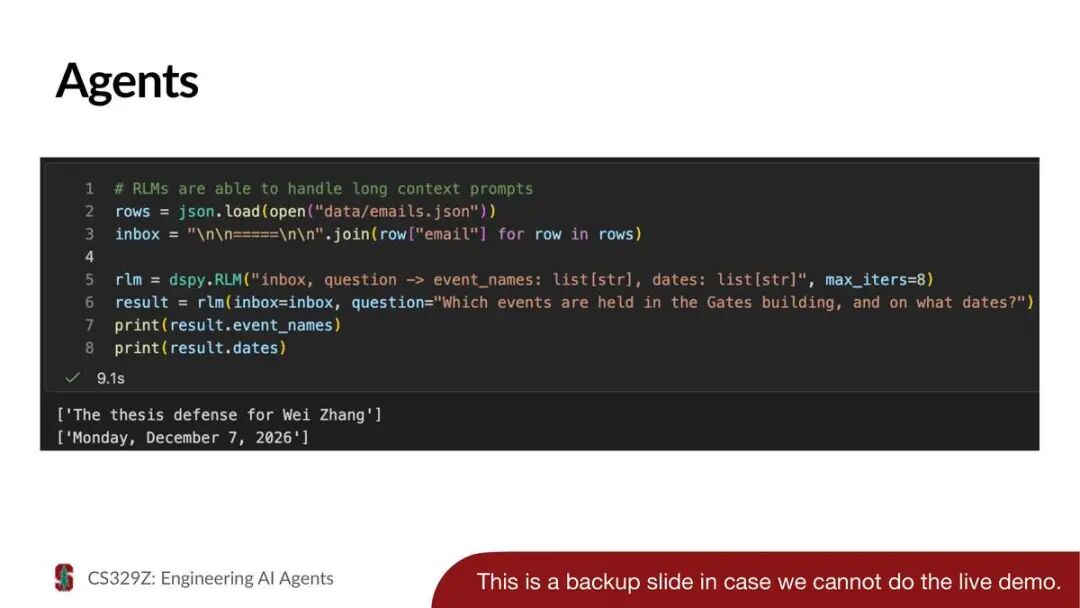
第 48 页的注释是:RLM 能处理长上下文的提示。把 50 封邮件全部拼成一个 inbox 字符串,签名是 "inbox, question -> event_names: list[str], dates: list[str]",最多迭代 8 轮。
问题是:哪些活动在 Gates 楼举行,在哪天?用时 9.1 秒,输出事件名是 Wei Zhang 的论文答辩,日期是 2026 年 12 月 7 日周一。
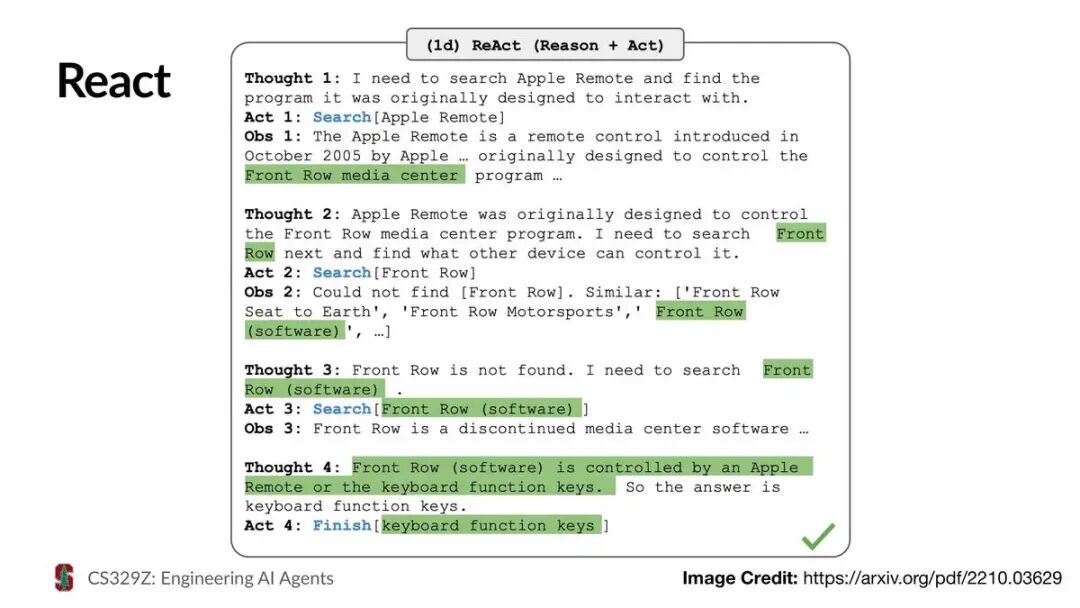
第 49 页是 ReAct 论文里的一张图,标题是「ReAct(推理加行动)」。课件这页没有印出题目。论文里的题目是:除了 Apple Remote,还有什么设备能控制 Apple Remote 最初设计来交互的那个程序?
模型交替写 Thought(想),Act(做),Obs(看到什么)。第 1 步搜索 Apple Remote,得知它最初用来控制 Front Row 媒体中心程序。第 2 步搜索 Front Row,没找到,返回几个相近的词条。第 3 步改搜 Front Row (software),得知它是一个已停产的媒体中心软件。第 4 步得出结论:Front Row 由 Apple Remote 或键盘功能键控制,答案是键盘功能键,然后 Finish。
补充ReAct 出自 Yao 等人的论文,发表在 ICLR 2023。据课程官网,这篇论文是下一讲的必读。
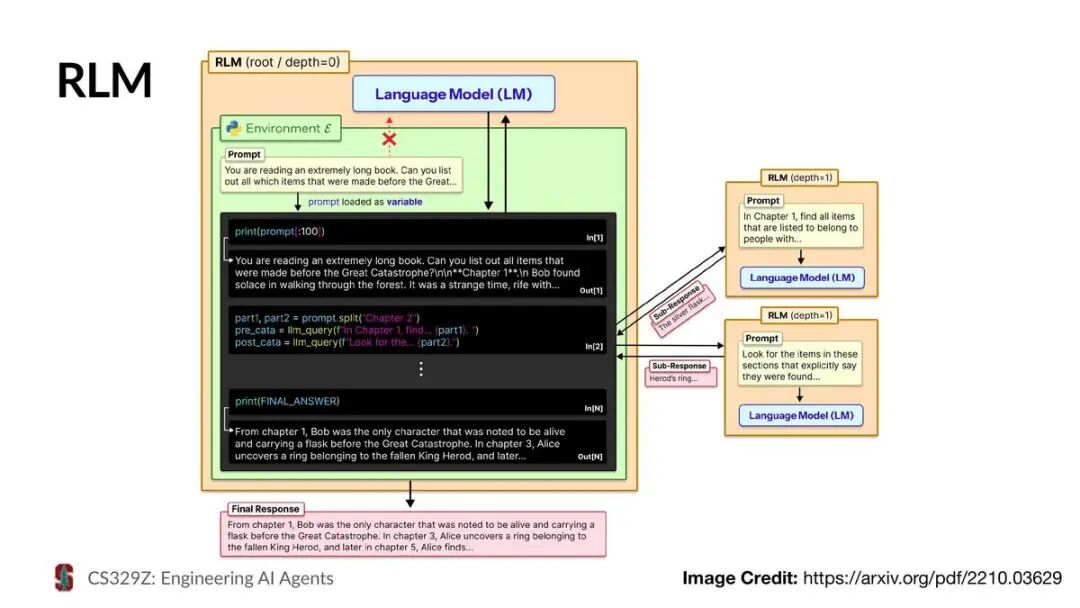
第 50 页是 RLM 的示意图。最外层是 RLM(根,深度 0):语言模型不直接读超长的提示,提示作为一个变量放进一个 Python 环境里。模型在环境里写代码,比如先打印提示的前 100 个字符,再按「Chapter 2」把文本切成两段,对每一段调用 llm_query,交给深度 1 的子 RLM 去处理。子 RLM 的回答返回到环境里,最后由根模型给出最终回答。
补充RLM 是 Recursive Language Model(递归语言模型)的缩写。本系列第 2 讲的课件讲上下文工程时也介绍过它。
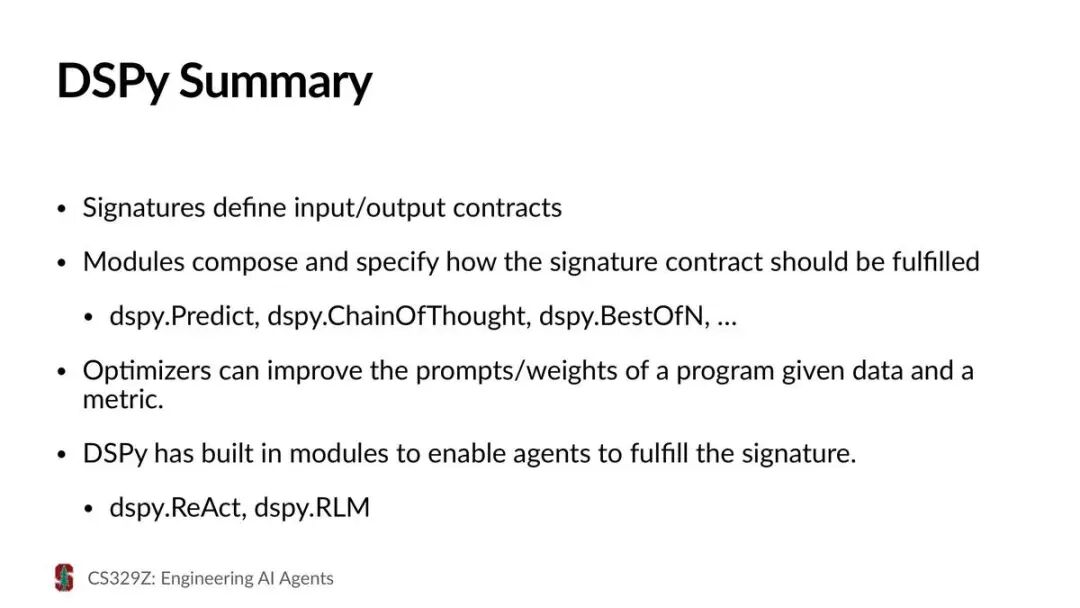
第 51 页是 DSPy 的小结。签名定义输入输出的契约。模块负责组合,并规定用什么方式完成签名的契约,例如 dspy.Predict,dspy.ChainOfThought,dspy.BestOfN。给定数据和指标,优化器可以改进程序的提示词或权重。DSPy 还有内置模块,让 agent 来完成签名,例如 dspy.ReAct 和 dspy.RLM。
三、工作流框架之二:LangGraph
LangGraph 用另一套抽象写工作流:一个共享的状态,读写状态的节点,决定走向的边。课上用它把 DSPy 那个「邮件进日历」的例子重写了一遍。
第 52 页是 LangGraph 的标志。
补充LangGraph 是 LangChain 团队开源的框架,用图来组织 LLM 应用的流程。
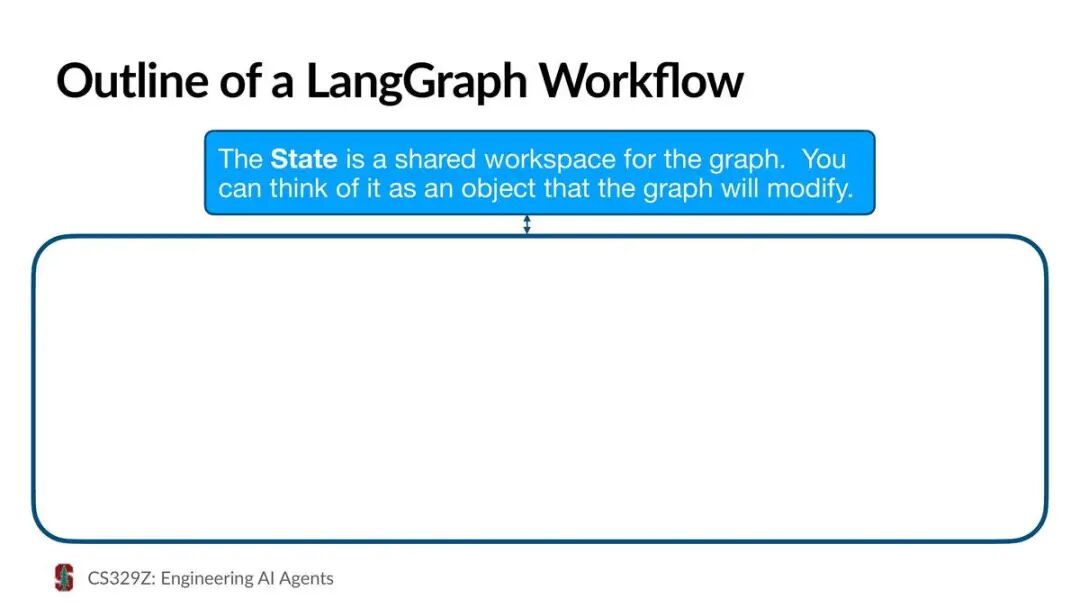
第 53 页开始一步步画 LangGraph 工作流的轮廓。先是一个空的大框,上方的蓝框写着:状态(State)是这张图的共享工作区,可以把它看成一个对象,图会去修改它。
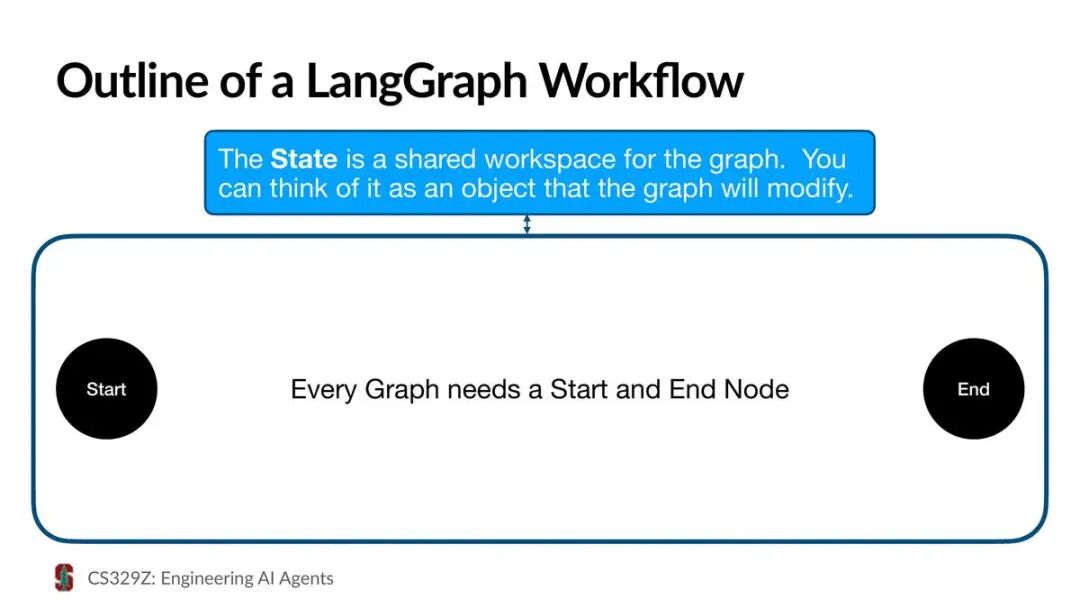
第 54 页在框里加了两端:每张图都需要一个开始节点和一个结束节点。
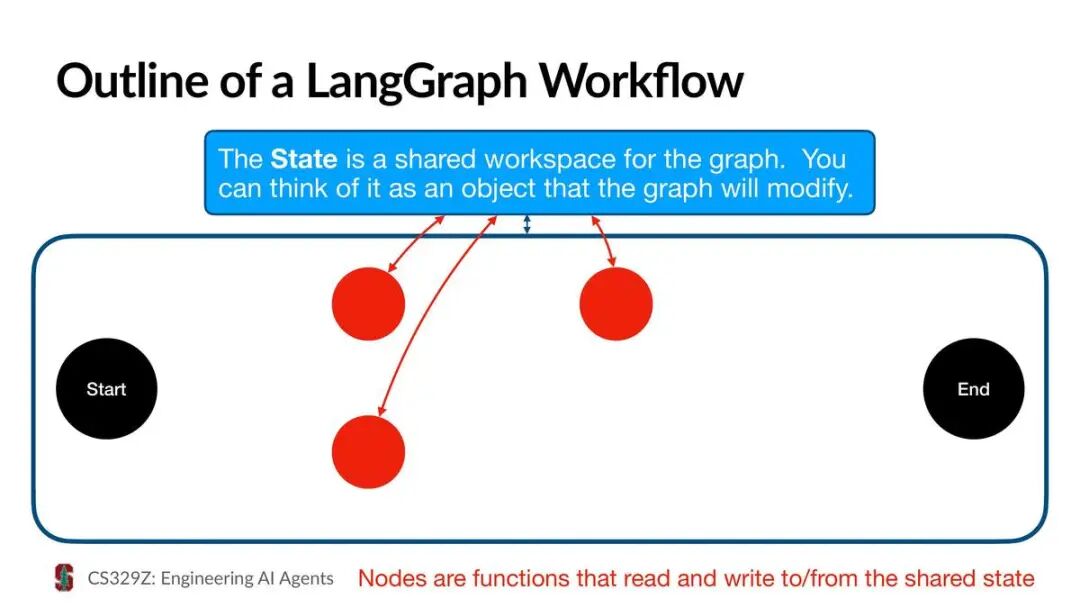
第 55 页加了三个红色的节点,每个都用双向箭头连到上方的状态。下方的红字是:节点是函数,从共享状态读,往共享状态写。
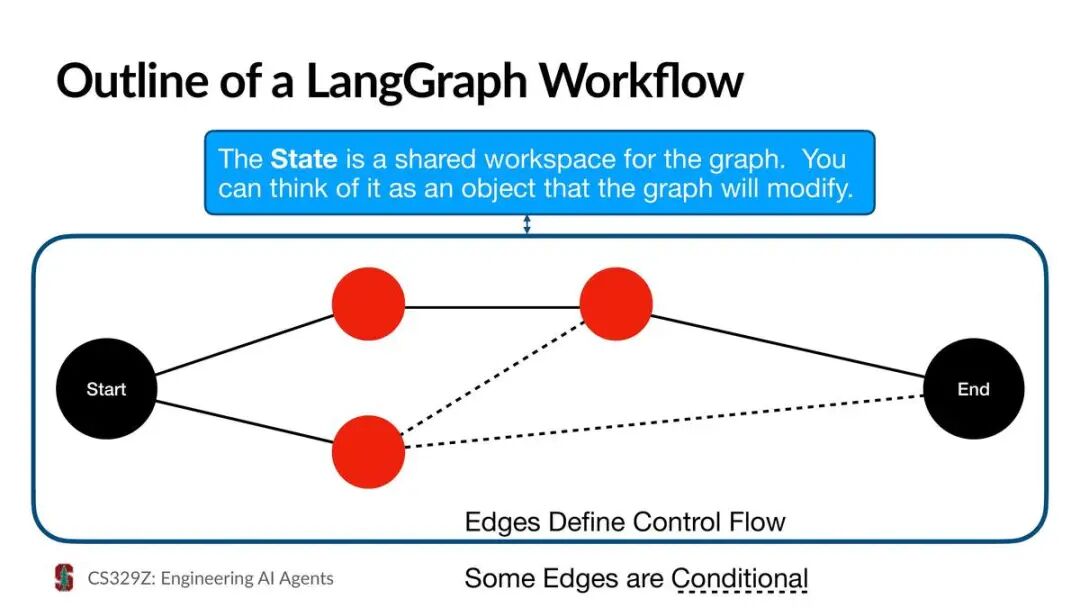
第 56 页加上边。实线把开始,几个节点和结束连起来;有两条是虚线。下方写着:边定义控制流,有些边是有条件的。
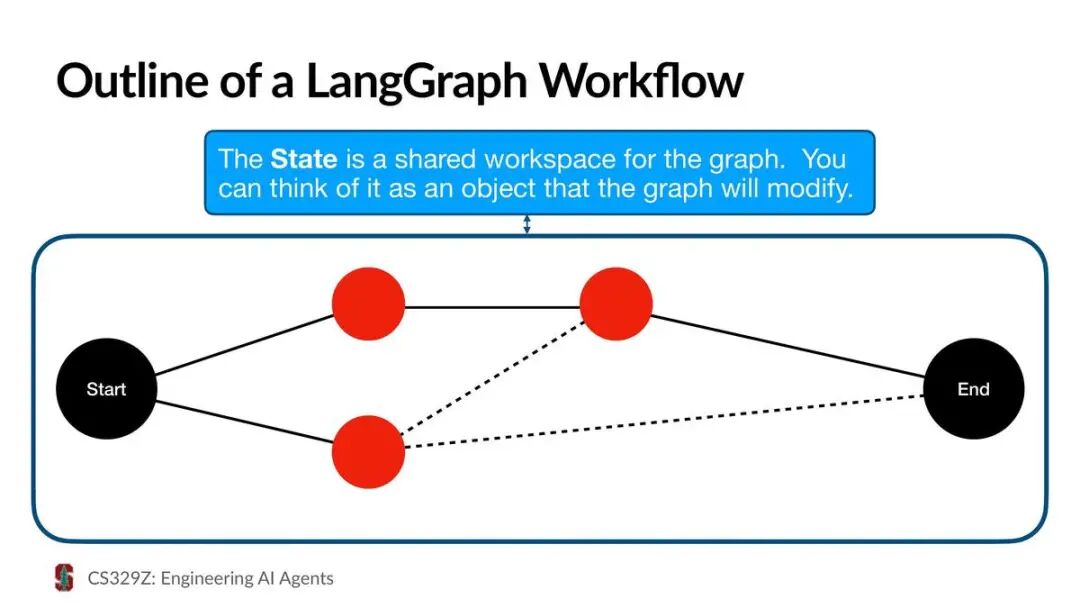
第 57 页是完整的工作流轮廓,和上一页相同,去掉了文字说明。
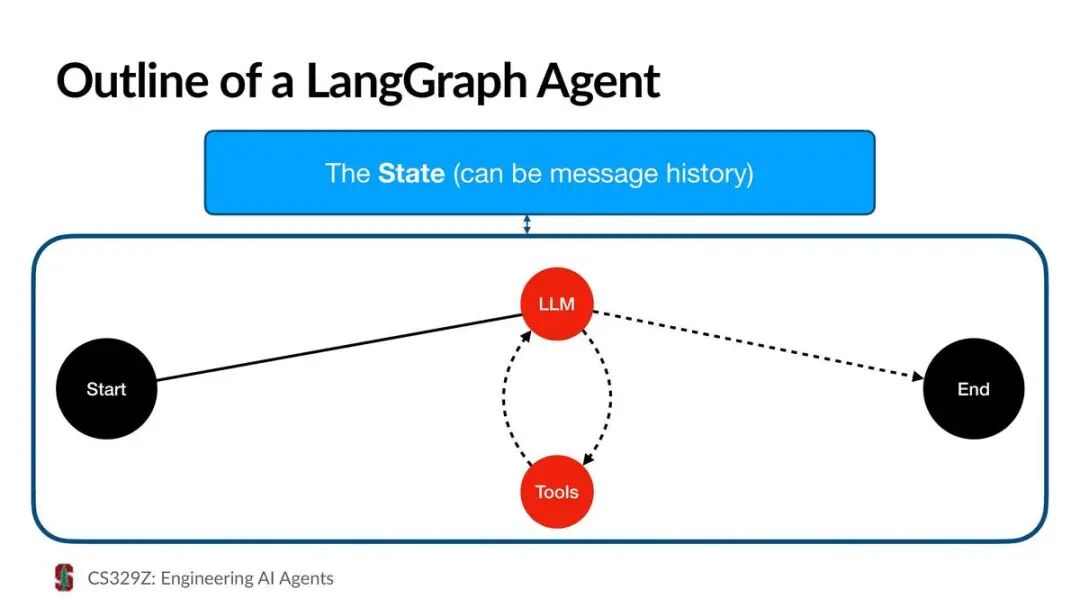
第 58 页换成 LangGraph agent 的轮廓。状态这里写的是「可以是消息历史」。图里只有两个节点:LLM 和工具。开始连到 LLM;LLM 和工具之间是一对虚线箭头,来回往返;LLM 另有一条虚线指向结束。
第 59 页是「现场编程演示」,第 60 页是小标题页「搭建图」,从这里起又是备用页。
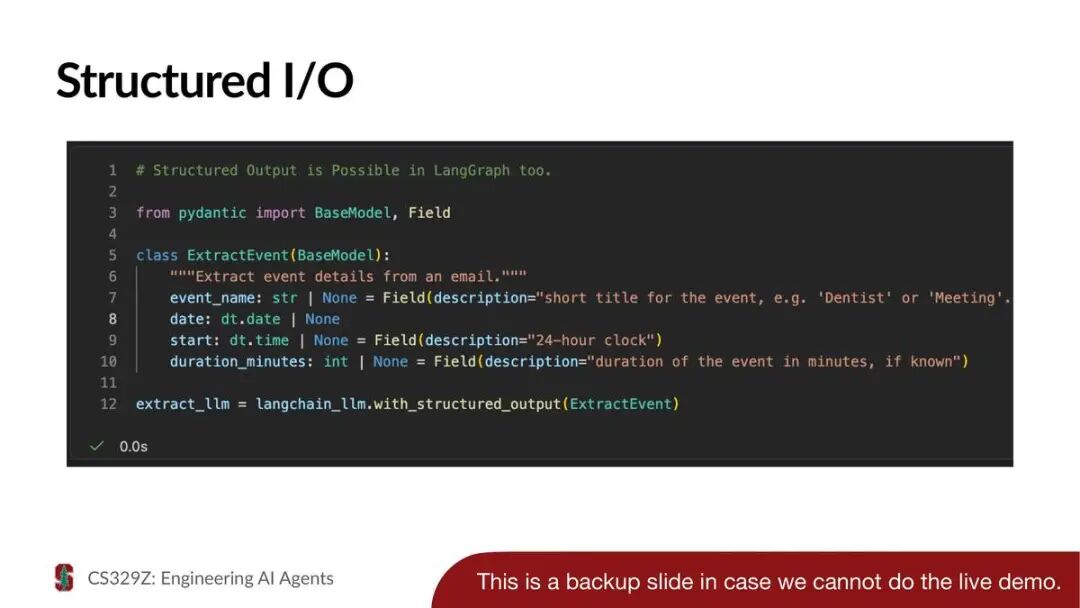
第 61 页的注释是:LangGraph 里也能做结构化输出。用 pydantic 的 BaseModel 定义 ExtractEvent,字段和 DSPy 那一版相同:事件名(描述是事件的简短标题,比如 Dentist 或 Meeting),日期,开始时间(24 小时制),时长(以分钟计,如果知道的话)。然后用 with_structured_output(ExtractEvent) 得到一个按这个结构输出的模型 extract_llm。
补充pydantic 是一个 Python 数据校验库,用类和类型注解定义数据结构。
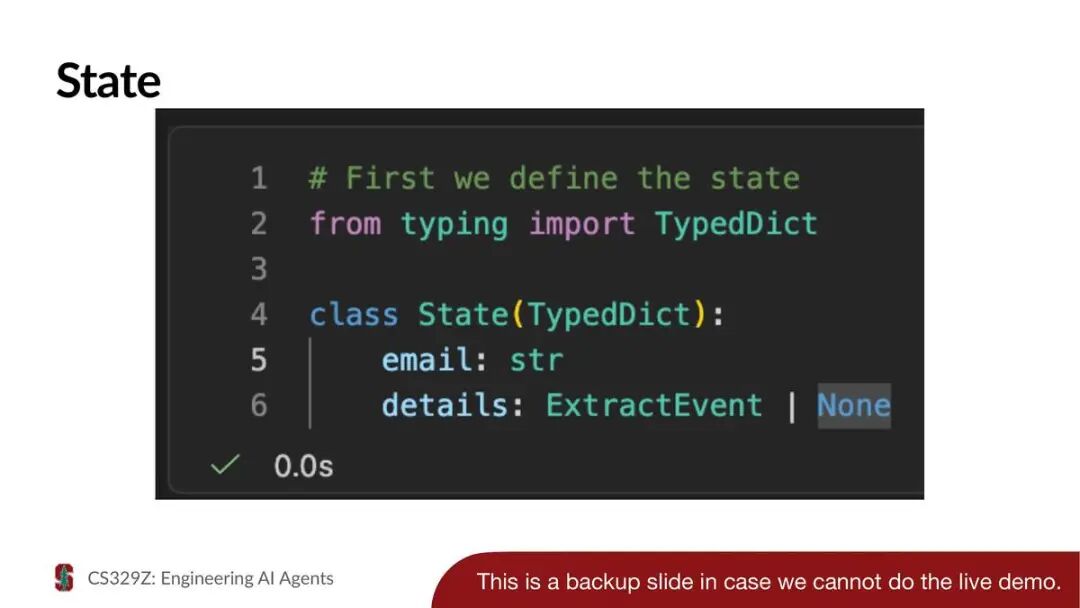
第 62 页定义状态:State 是一个 TypedDict,有两个键,email 是字符串,details 是 ExtractEvent 或空。
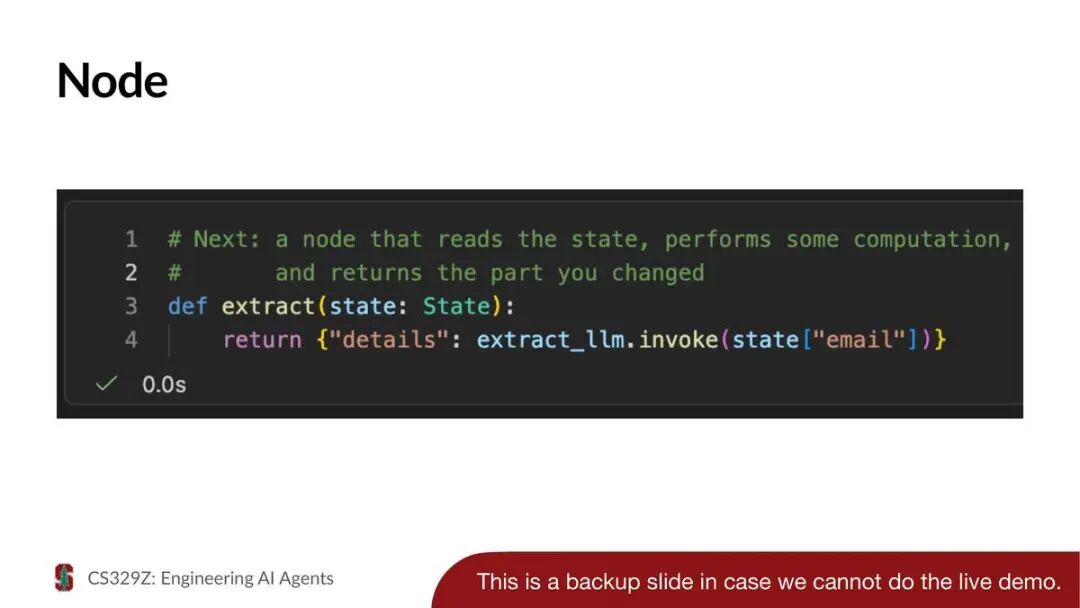
第 63 页定义一个节点,注释写着:节点读取状态,做一些计算,返回它改动的那部分。extract 函数读出状态里的 email,交给 extract_llm,返回 {"details": 抽取结果}。
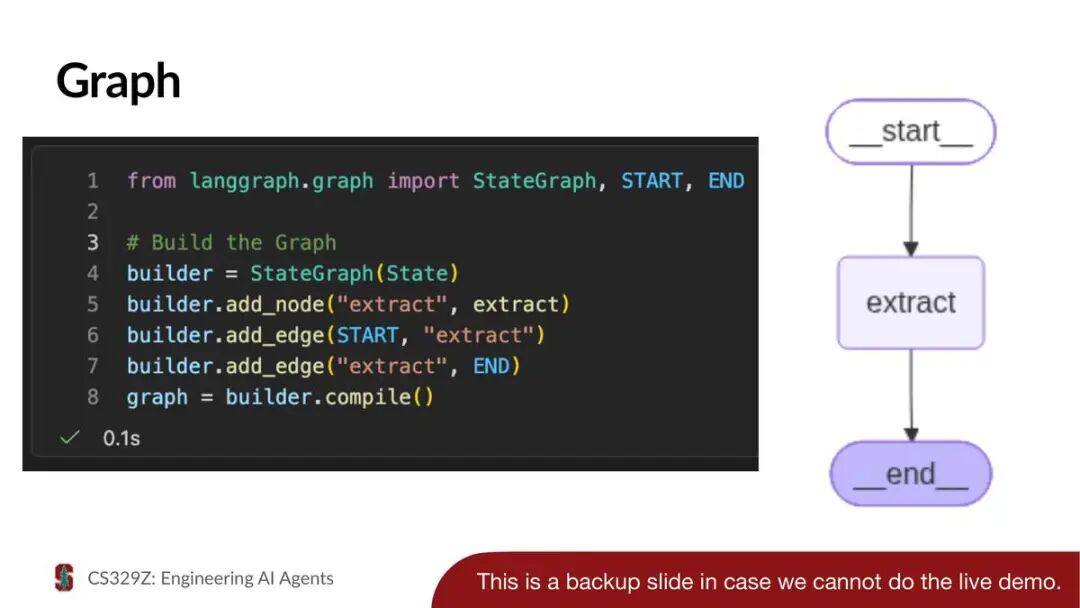
第 64 页把图搭起来。用 State 建一个 StateGraph,加入 extract 节点,加两条边:START 到 extract,extract 到 END,然后编译。右边是生成的流程图:__start__ 到 extract 到 __end__。
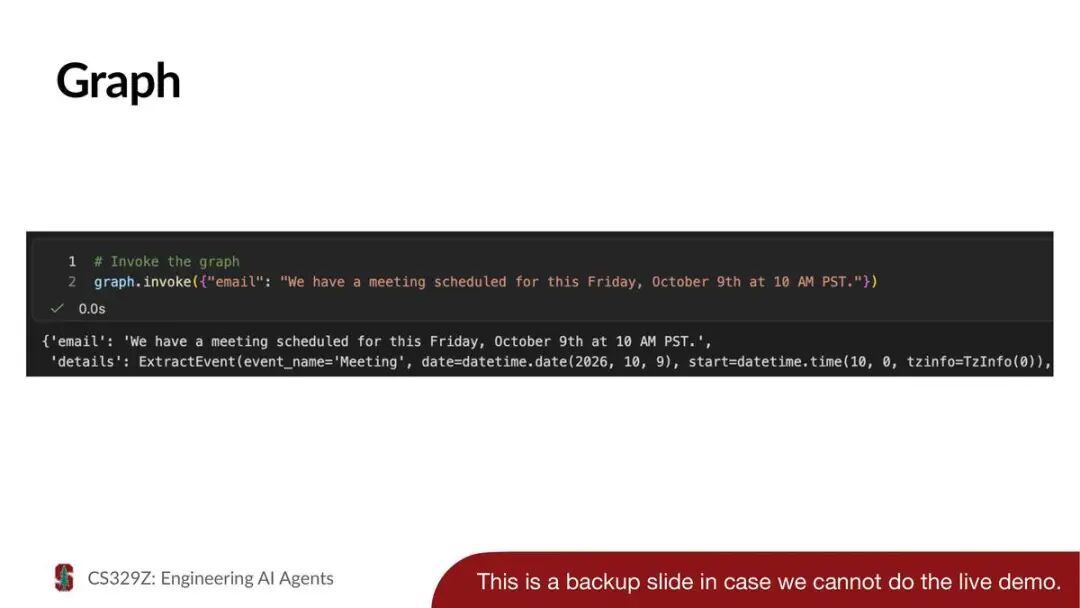
第 65 页调用这张图,传入周五开会那封邮件。返回的状态里,email 是原文,details 是抽出的 ExtractEvent:事件名 Meeting,日期 2026 年 10 月 9 日,开始时间 10:00。
第 66 页是小标题页「条件边与工作流」。
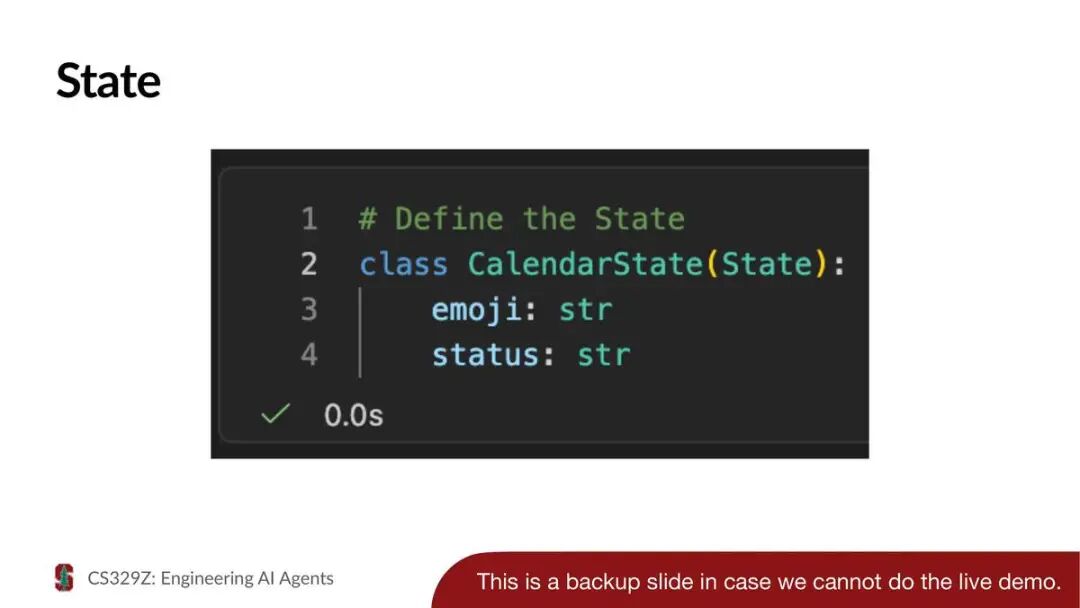
第 67 页扩展状态:CalendarState 继承 State,多两个字符串字段,emoji 和 status。
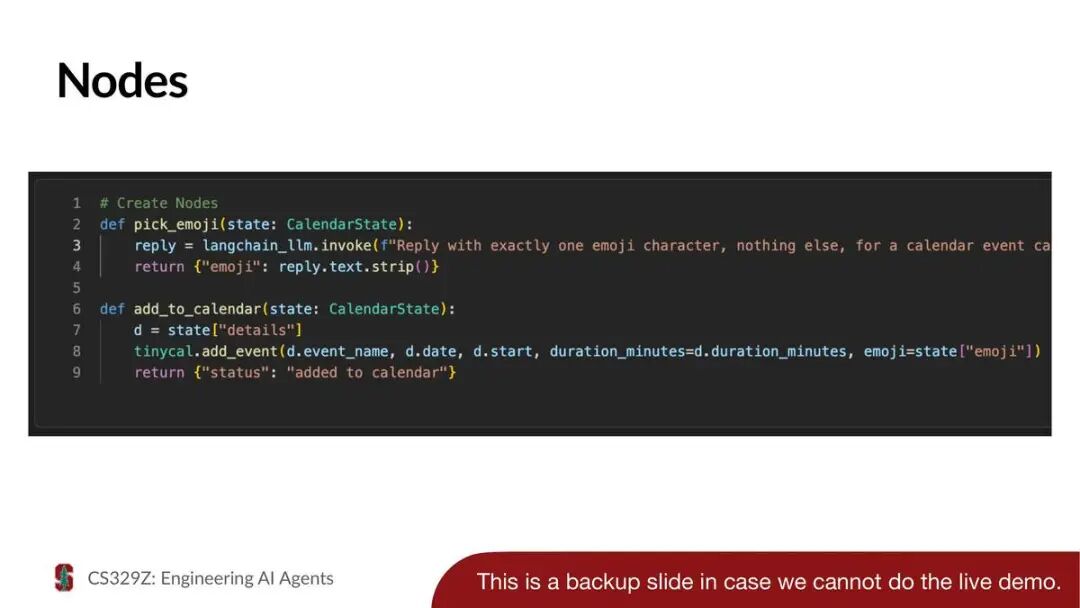
第 68 页建两个节点。pick_emoji 让模型「只回一个 emoji 字符,别的什么都不要」,返回 {"emoji": …}。add_to_calendar 从状态里取出 details 和 emoji,调用 tinycal.add_event,返回 {"status": "added to calendar"}。
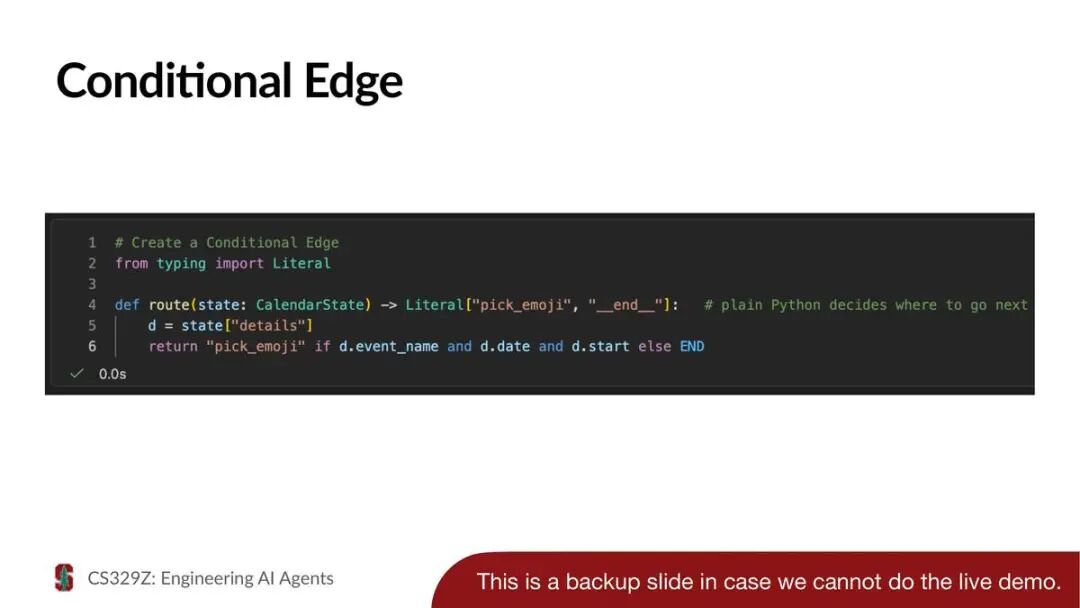
第 69 页建一条条件边。route 函数的返回值只能是 "pick_emoji" 或 "__end__",注释写着:由普通 Python 决定下一步去哪。事件名,日期,开始时间都有,就去 pick_emoji,否则直接到 END。
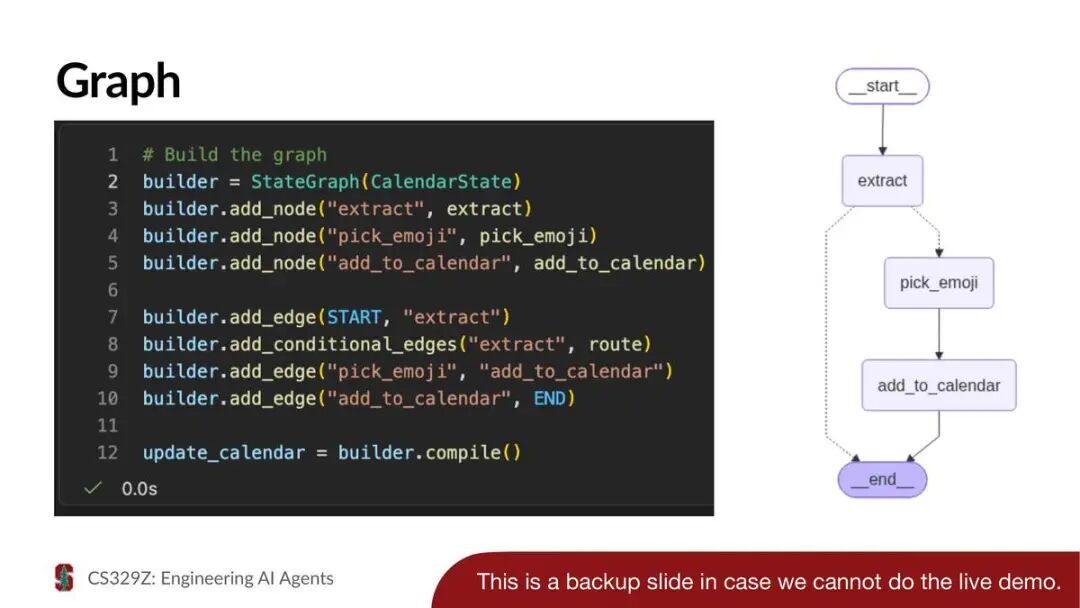
第 70 页搭完整的图:三个节点 extract,pick_emoji,add_to_calendar;START 到 extract;extract 之后接条件边 route;pick_emoji 到 add_to_calendar;add_to_calendar 到 END。右边的流程图里,extract 出来有两条虚线,一条去 pick_emoji,一条直接去 __end__。
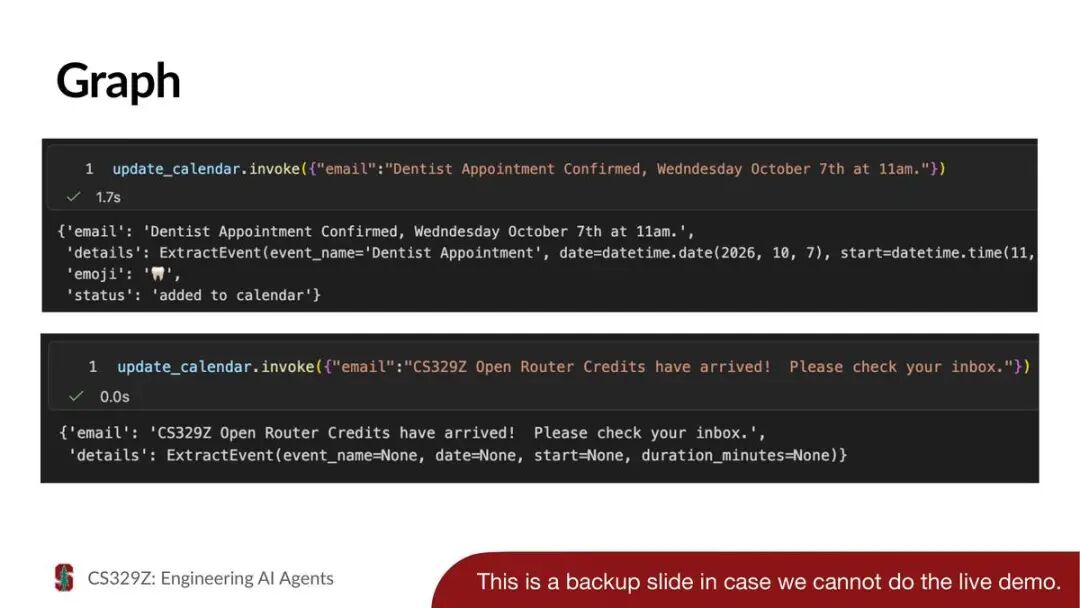
第 71 页跑两封邮件。第一封是「牙医预约已确认,10 月 7 日周三上午 11 点」,结果里抽出了 Dentist Appointment,日期 2026 年 10 月 7 日,emoji 是一颗牙,状态是已加入日历。第二封是「CS329Z 的 OpenRouter 额度到了,请查收邮箱」,抽出的四个字段全为空,结果里没有 emoji 和 status,图走了直接结束那条边。
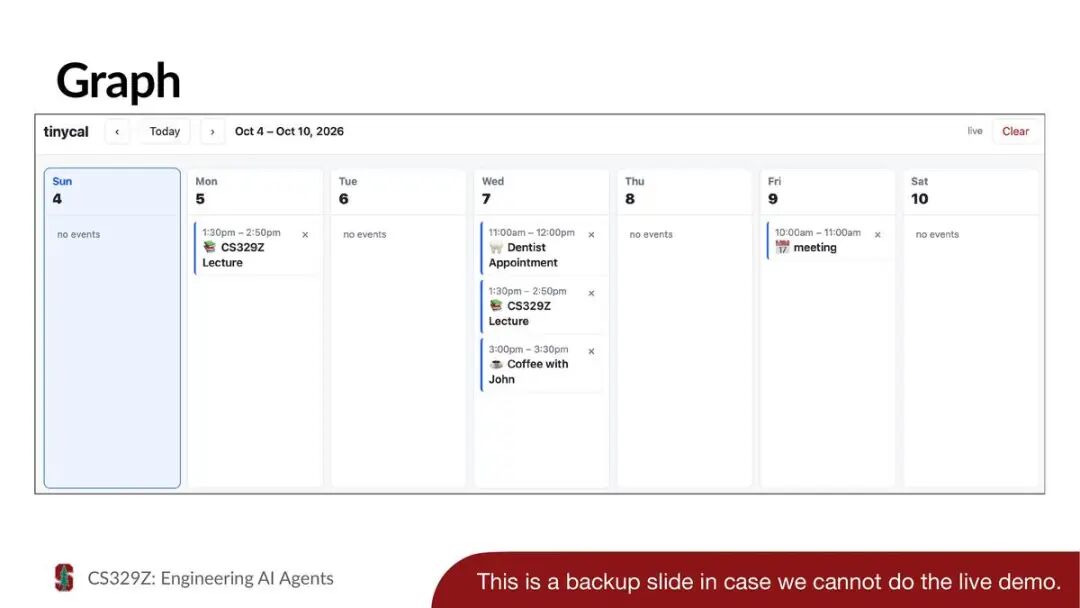
第 72 页的日历上,周三 7 日多了 11:00 到 12:00 的牙医预约。
第 73 页是小标题页「Agent」。
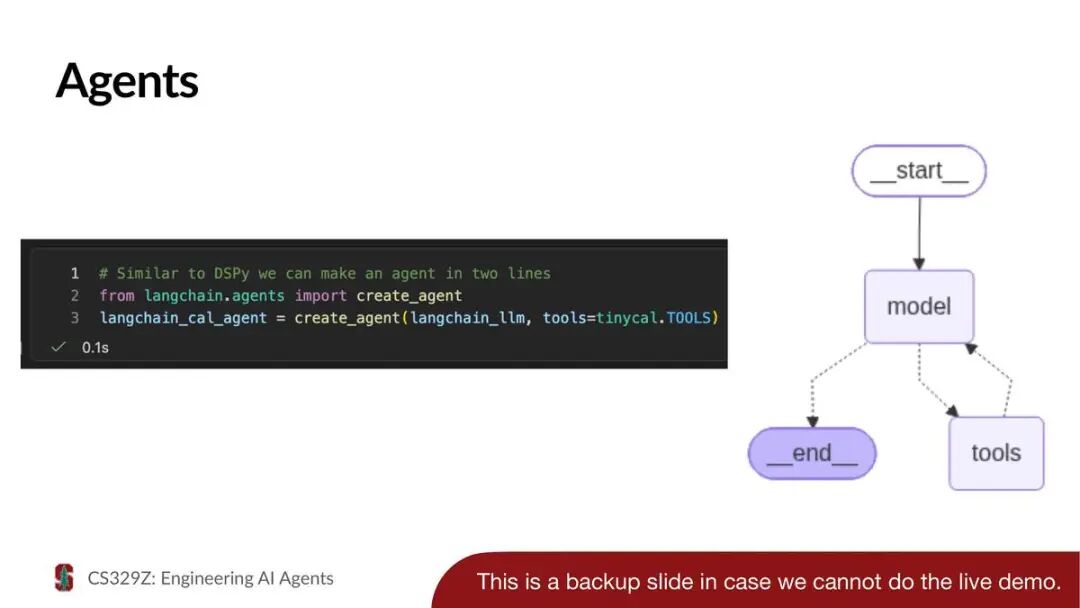
第 74 页的注释是:和 DSPy 一样,两行就能做出一个 agent。从 langchain.agents 导入 create_agent,传入模型和 tinycal.TOOLS。右边是它生成的图:__start__ 到 model;model 和 tools 之间来回;model 也可以去 __end__。
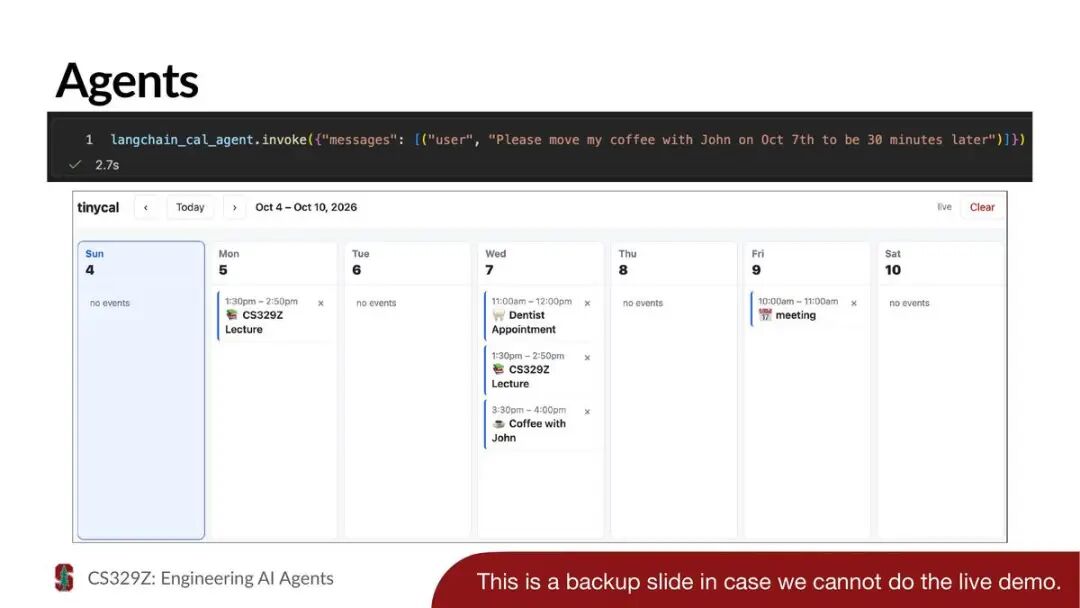
第 75 页调用这个 agent,消息是「请把我 10 月 7 日和 John 的咖啡往后挪 30 分钟」,用时 2.7 秒。下面的日历上,周三的咖啡变成了 3:30 到 4:00。
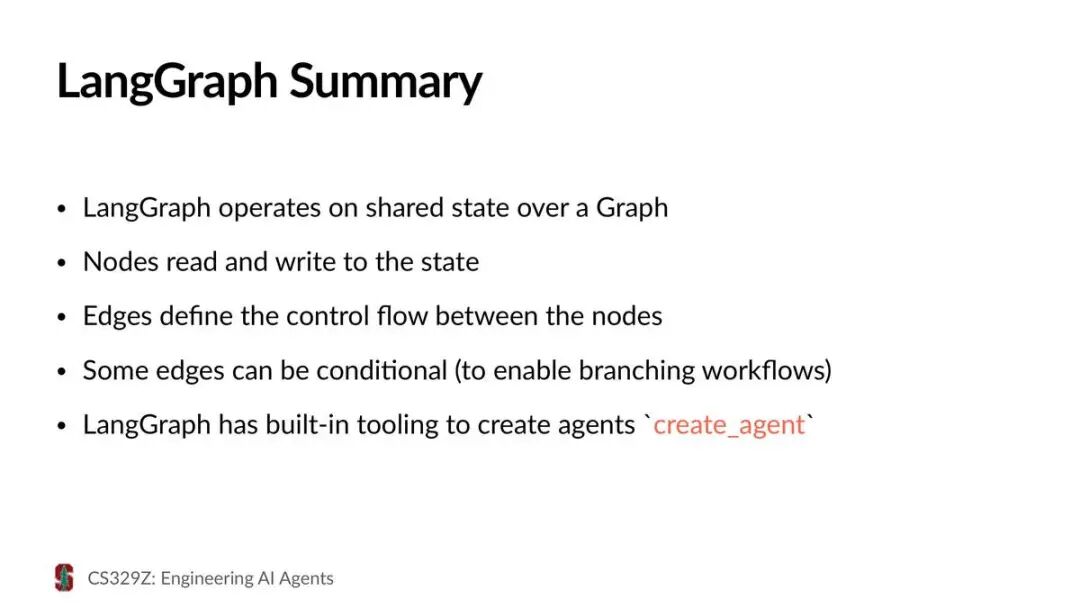
第 76 页是 LangGraph 的小结。LangGraph 在一张图上操作共享状态。节点读写状态。边定义节点之间的控制流。有些边可以有条件,用来做分支的工作流。LangGraph 有内置工具来创建 agent,也就是 create_agent。
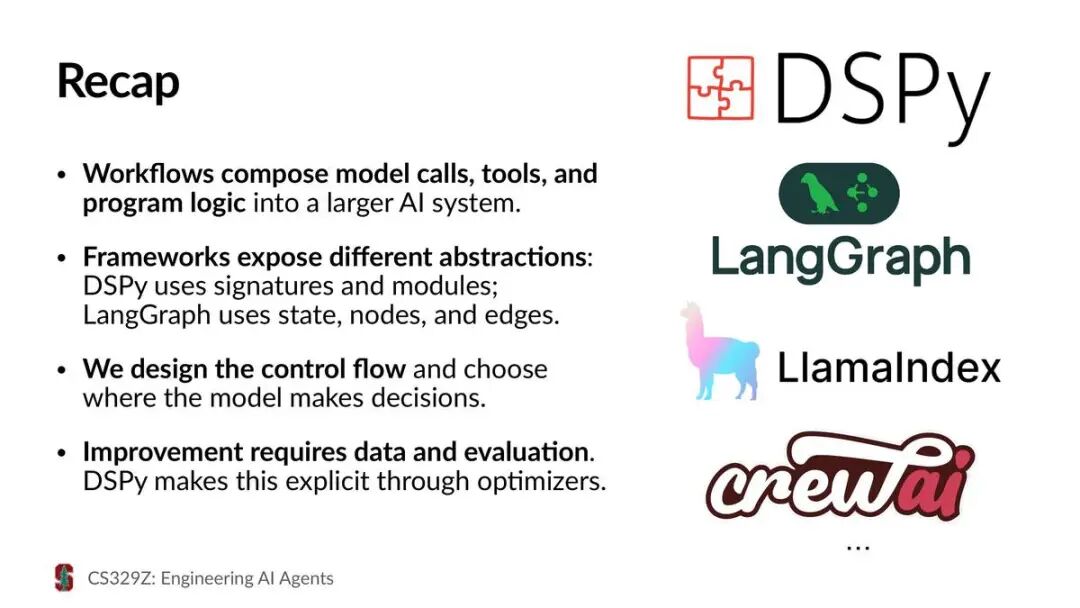
第 77 页是第二块的小结,四条。工作流把模型调用,工具和程序逻辑组合成一个更大的 AI 系统。不同框架提供不同的抽象:DSPy 用签名和模块,LangGraph 用状态,节点和边。控制流由我们来设计,模型在哪里做决定也由我们来选。改进需要数据和评估,DSPy 用优化器把这一点明确写了出来。
右边一列标志是 DSPy,LangGraph,LlamaIndex,crewAI,下面还有省略号。
补充LlamaIndex 是一个把 LLM 接到外部数据上的框架,常用来做 RAG。crewAI 是一个多 agent 协作框架。这两个框架只在这一页出现了标志,课件没有展开讲。
四、开源 agent 脚手架
同一个模型,换一个脚手架,成本和成功率都会变。课件比较了四个开源脚手架各自的取舍,又介绍了一种让模型自己写脚手架的方法。
第 78 页是第三块的标题页:开源 agent 脚手架(harness)。
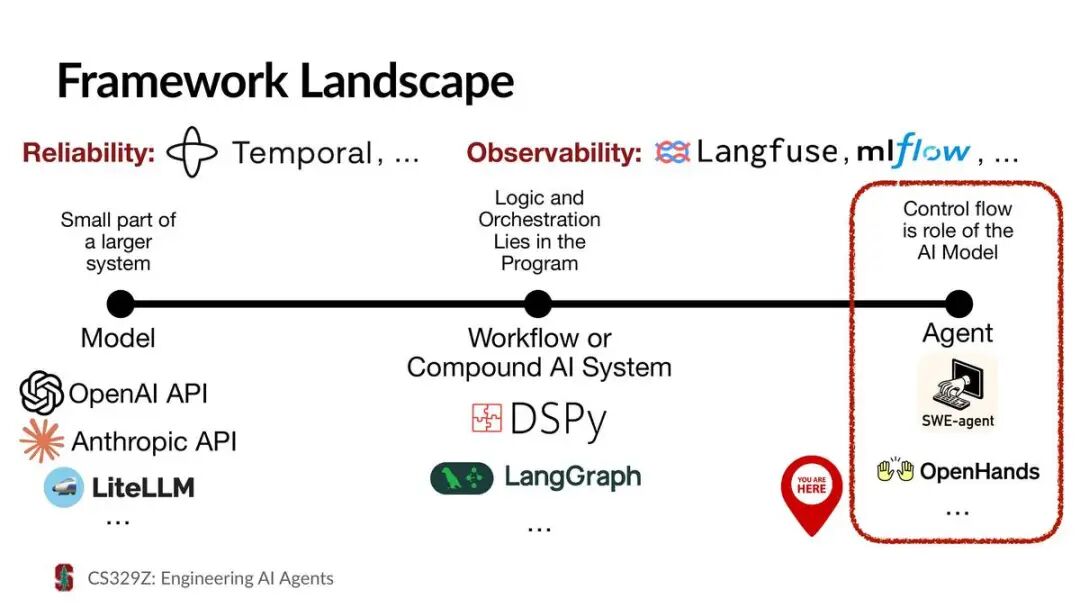
第 79 页回到框架版图,这次红框圈住光谱右端的 agent,「你在这里」的定位标挪到了这边。
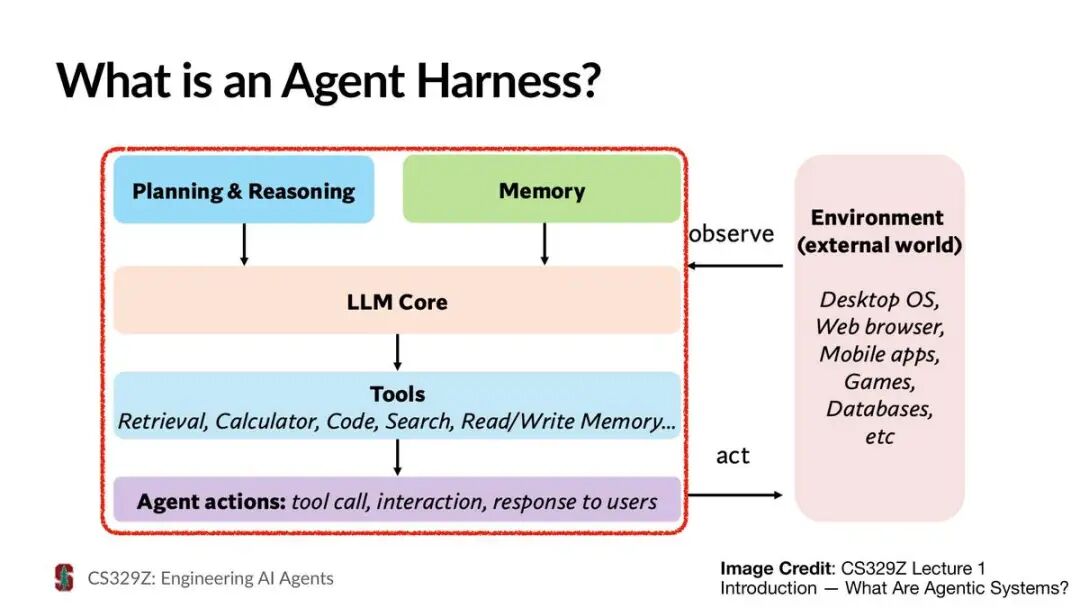
第 80 页问:什么是 agent 脚手架?用的是第 1 讲里的一张图。红框里是 agent:规划与推理,记忆,这两块都输入到中间的 LLM 核心;LLM 核心下面是工具,比如检索,计算器,代码,搜索,读写记忆;最下面是 agent 的动作,包括工具调用,交互,回复用户。红框右边是环境,也就是外部世界,比如桌面操作系统,网页浏览器,手机应用,游戏,数据库。agent 从环境观察,对环境行动。
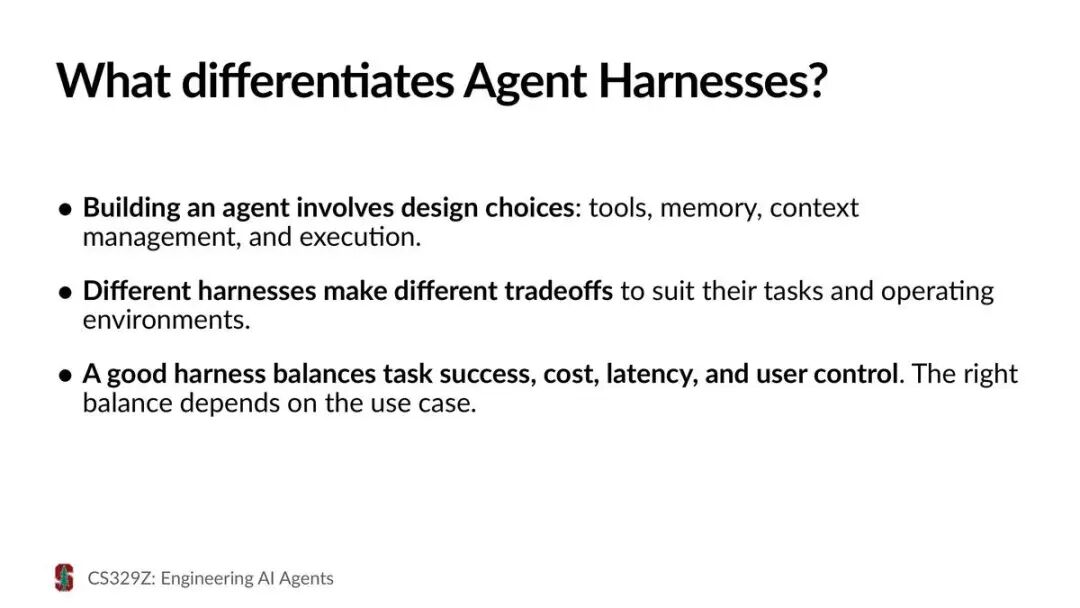
第 81 页讲脚手架之间差在哪,三条。搭 agent 要做一系列设计选择:工具,记忆,上下文管理,执行方式。不同的脚手架做不同的取舍,去适应各自的任务和运行环境。好的脚手架要在任务成功率,成本,延迟和用户控制之间取得平衡,怎样平衡取决于用途。
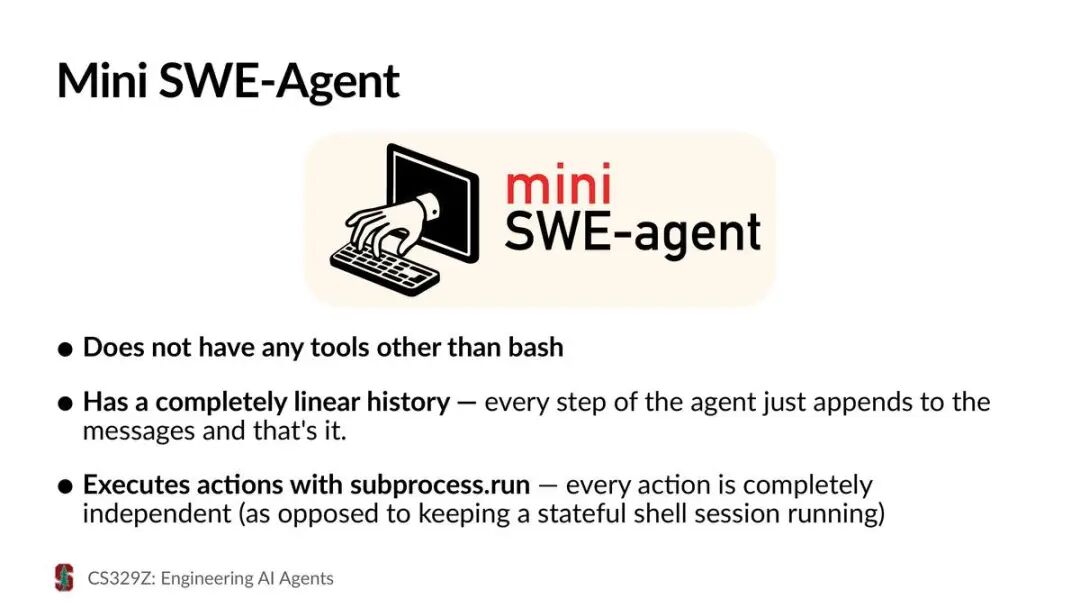
第 82 页是 mini SWE-agent,三个特点。除了 bash,没有任何别的工具。历史完全是线性的,agent 每走一步,就往消息列表后面追加一条,仅此而已。用 subprocess.run 执行动作,每个动作完全独立,不保留一个有状态的 shell 会话。
补充mini SWE-agent 是 SWE-agent 团队做的精简版。subprocess.run 是 Python 里启动一个子进程执行命令的函数,每次调用都是一个新进程。
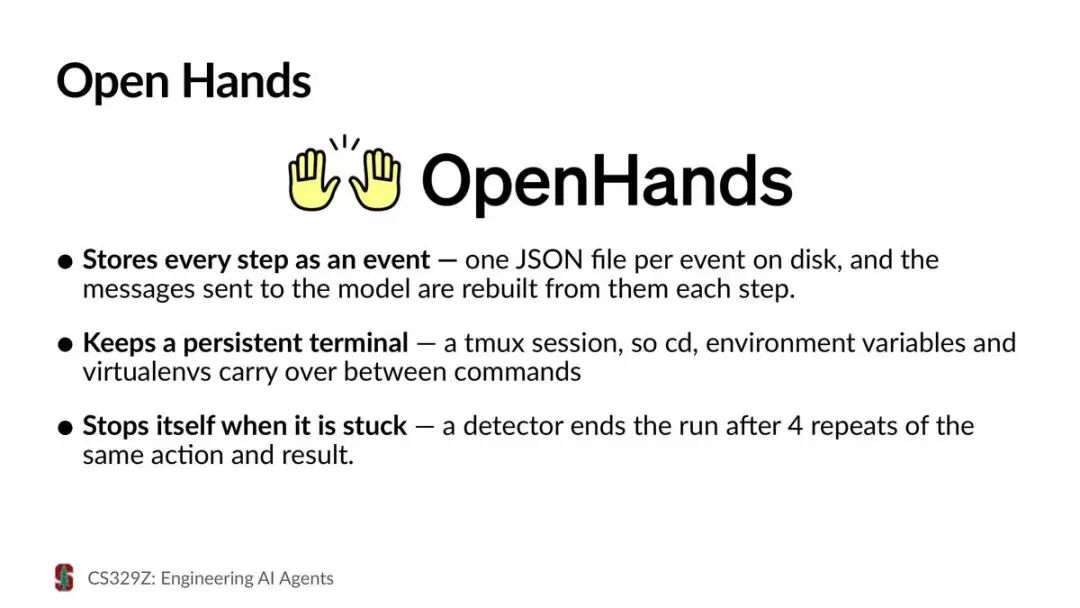
第 83 页是 OpenHands,三个特点。每一步都存成一个事件,磁盘上每个事件一个 JSON 文件,每一步发给模型的消息都从这些事件重建出来。保留一个持久的终端,也就是一个 tmux 会话,所以 cd,环境变量和虚拟环境在命令之间都会保留。卡住时会自己停下:有一个检测器,同样的动作和结果重复 4 次,就结束这次运行。
补充tmux 是一个终端复用工具,可以让一个终端会话在后台一直存在。
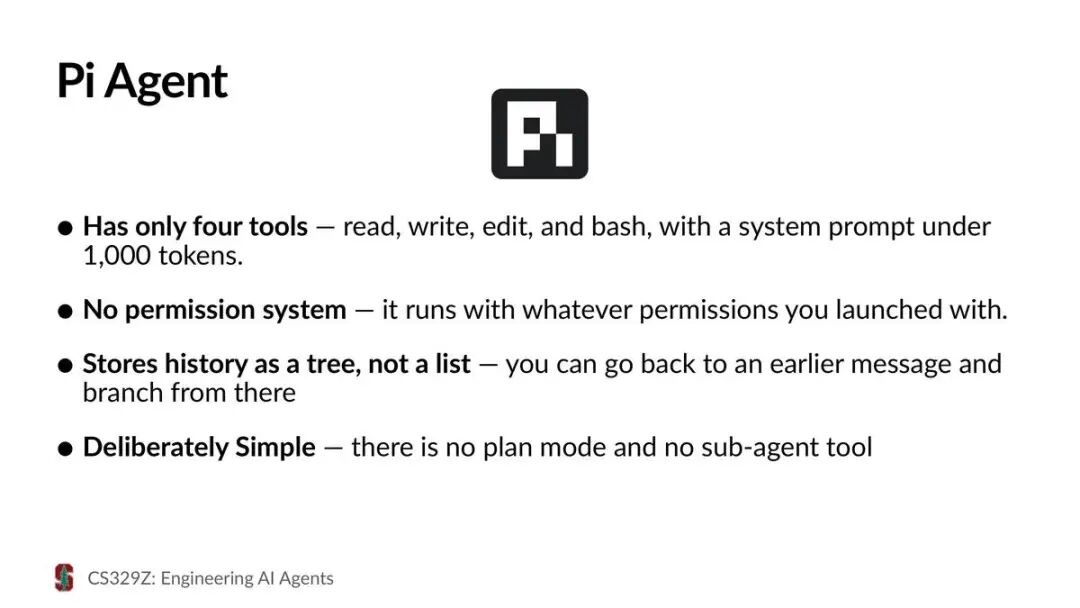
第 84 页是 Pi,四个特点。只有四个工具:读,写,编辑,bash,系统提示不到 1,000 个 token。没有权限系统,你用什么权限启动它,它就用什么权限运行。历史存成一棵树,不是一个列表,可以回到更早的某条消息,从那里分出一条新分支。刻意保持简单,没有计划模式,也没有子 agent 工具。
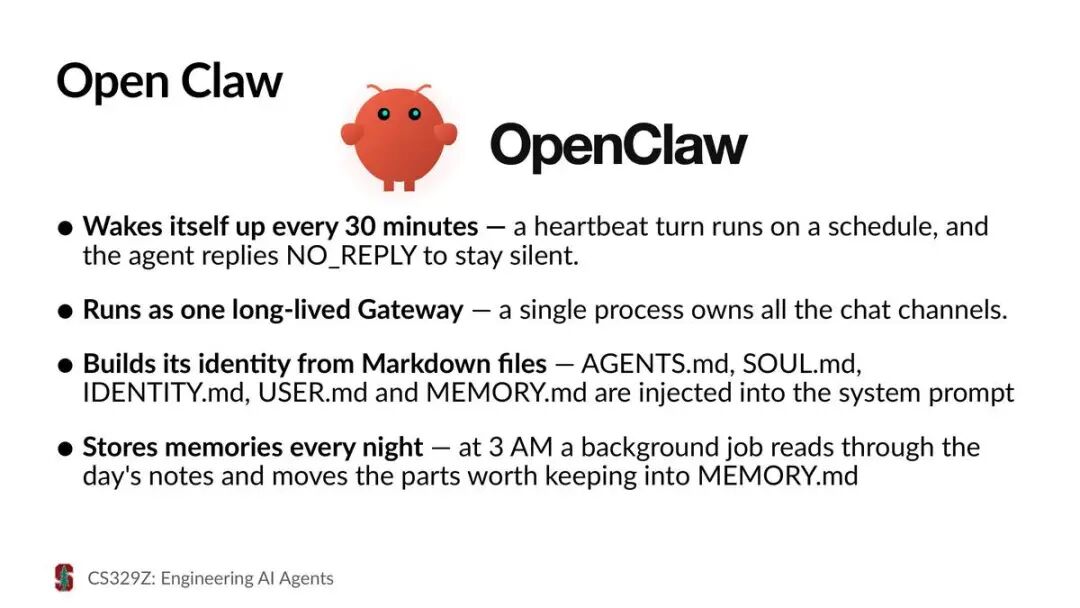
第 85 页是 OpenClaw,四个特点。每 30 分钟自己醒一次:按计划跑一轮心跳,不需要说话时,agent 回复 NO_REPLY 保持沉默。以一个长期运行的 Gateway 进程运行,所有聊天渠道都归这一个进程管。身份由几个 Markdown 文件构成:AGENTS.md,SOUL.md,IDENTITY.md,USER.md 和 MEMORY.md 会被注入系统提示。每晚整理记忆:凌晨 3 点,一个后台任务读一遍当天的笔记,把值得保留的部分移进 MEMORY.md。
补充OpenClaw 是一个开源的个人 AI 助手,通过聊天软件和用户对话。
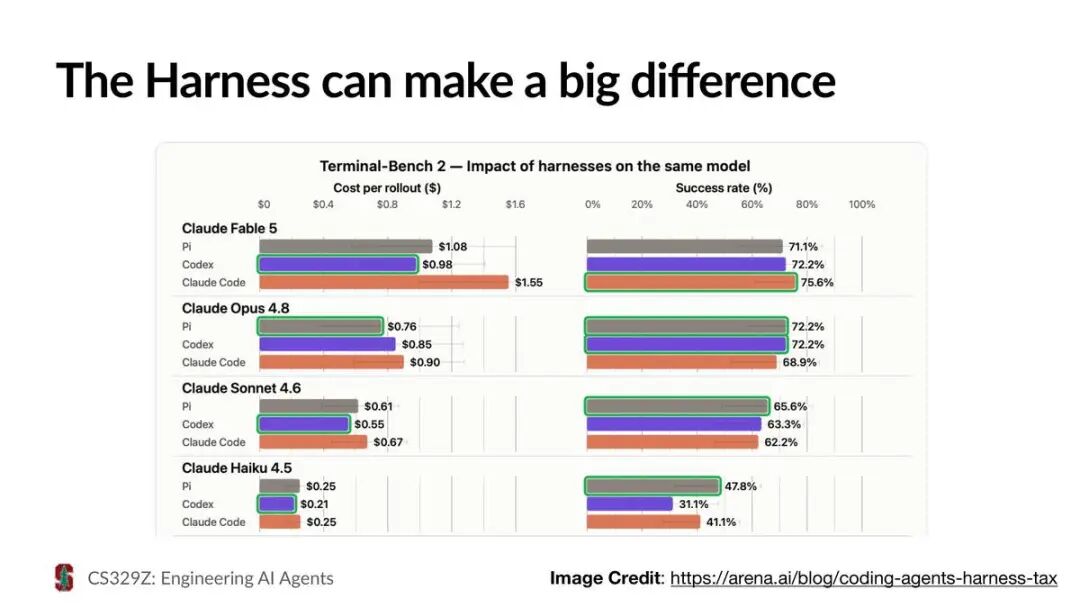
第 86 页的标题是:脚手架能带来很大差别。图来自 arena.ai 的一篇博客,标题是「Terminal-Bench 2,同一个模型上不同脚手架的影响」。四个模型,每个模型分别套 Pi,Codex,Claude Code 三个脚手架,左边是每次运行的成本,右边是成功率。
Claude Fable 5:成本 Pi 1.08 美元,Codex 0.98 美元,Claude Code 1.55 美元;成功率 Pi 71.1%,Codex 72.2%,Claude Code 75.6%。
Claude Opus 4.8:成本 0.76,0.85,0.90 美元;成功率 72.2%,72.2%,68.9%。
Claude Sonnet 4.6:成本 0.61,0.55,0.67 美元;成功率 65.6%,63.3%,62.2%。
Claude Haiku 4.5:成本 0.25,0.21,0.25 美元;成功率 47.8%,31.1%,41.1%。
每组里有绿框标出的条,对照数字看,标的是这个模型下成本最低和成功率最高的那一项。差距最大的是 Haiku 4.5:同一个模型,Pi 的成功率 47.8%,Codex 是 31.1%。
补充Terminal-Bench 是一个让 agent 在命令行环境里完成任务的基准。Codex 和 Claude Code 分别是 OpenAI 和 Anthropic 的编码 agent。
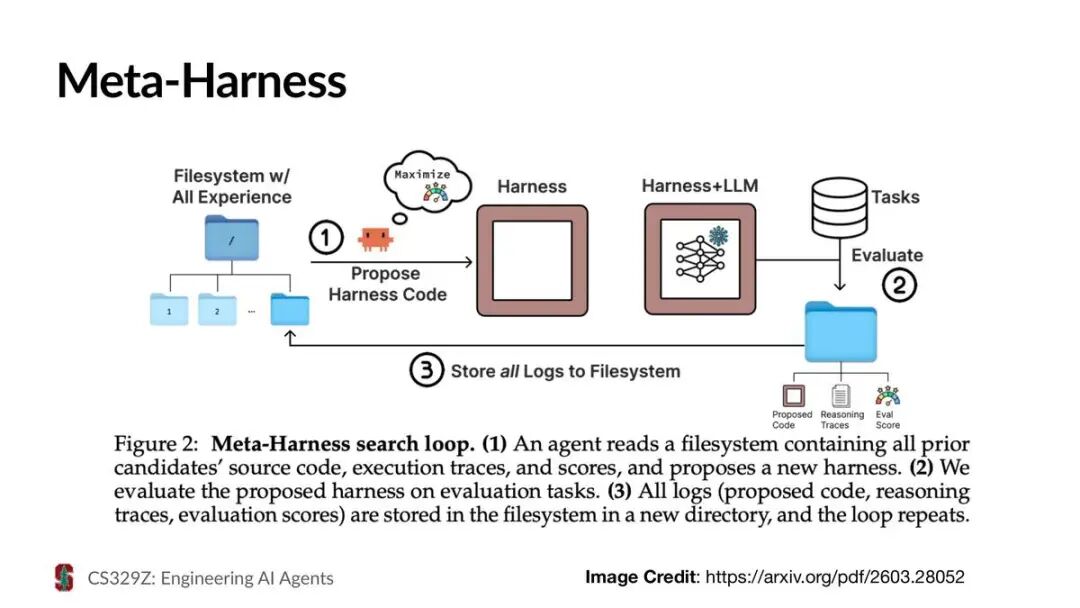
第 87 页是 Meta-Harness,图来自论文 arXiv 2603.28052 的图 2,搜索循环分三步。第一步,一个 agent 读一个文件系统,里面存着之前所有候选脚手架的源代码,执行轨迹和得分,然后提出一个新的脚手架。第二步,在评估任务上评估这个新脚手架。第三步,所有日志,包括提出的代码,推理轨迹,评估得分,都存进文件系统里的一个新目录,然后循环重复。
第 88 页是同一篇论文的图 1。
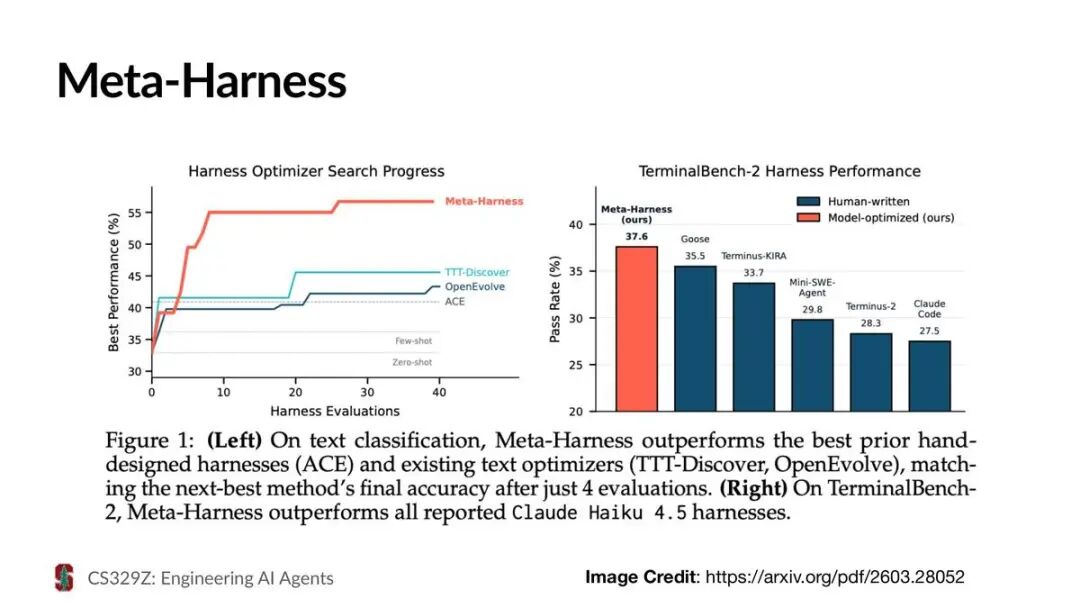
左图是文本分类任务上的搜索过程,横轴是评估脚手架的次数,纵轴是目前最好的成绩。Meta-Harness 的曲线在前 10 次评估里就升到 55% 左右,之后到 57% 左右;TTT-Discover 和 OpenEvolve 两条曲线停在 43% 到 46% 左右;ACE 是一条 41% 左右的水平虚线;更低处还有 few-shot 和 zero-shot 两条水平基准线。图注写着:Meta-Harness 超过了之前最好的人工设计脚手架(ACE)和已有的文本优化器(TTT-Discover,OpenEvolve),只用 4 次评估就追平了第二名的最终准确率。
右图是 TerminalBench-2 上,都用 Claude Haiku 4.5 的各脚手架通过率。图例把 Meta-Harness 标为模型优化出的脚手架,其余五个是人工编写的:Meta-Harness 37.6%,Goose 35.5%,Terminus-KIRA 33.7%,Mini-SWE-Agent 29.8%,Terminus-2 28.3%,Claude Code 27.5%。图注写着:在 TerminalBench-2 上,Meta-Harness 超过了所有已报告的 Claude Haiku 4.5 脚手架。
第 89 页把这一块收在一起,三条。搭 agent 没有唯一的方法。这门课里,你们会把这些设计决定都试一遍。说不定你能做出下一个流行的 agent 脚手架。
五、编排与遥测
agent 一跑就是很久,中途哪一步失败都不该让整件事重来。课件用 Temporal 演示了三件事:每一步都有记录,失败的步骤自动重试,进程被杀掉后工作流还能接着跑完。
第 90 页是第四块的标题页:编排与遥测。
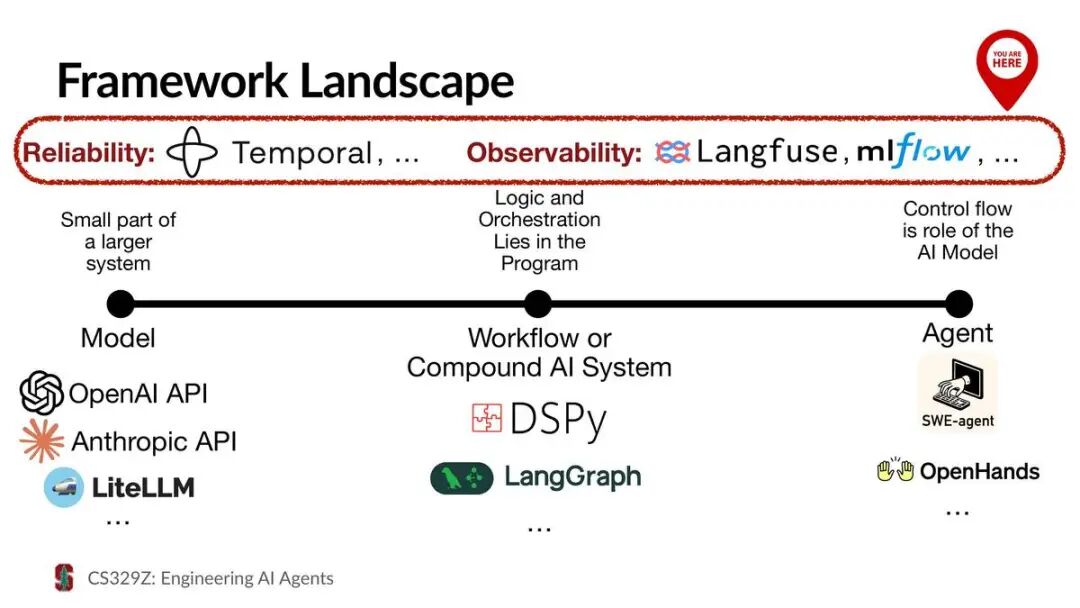
第 91 页回到框架版图,这次红框圈住上方的可靠性和可观测性那一行,定位标挪到了最上面。
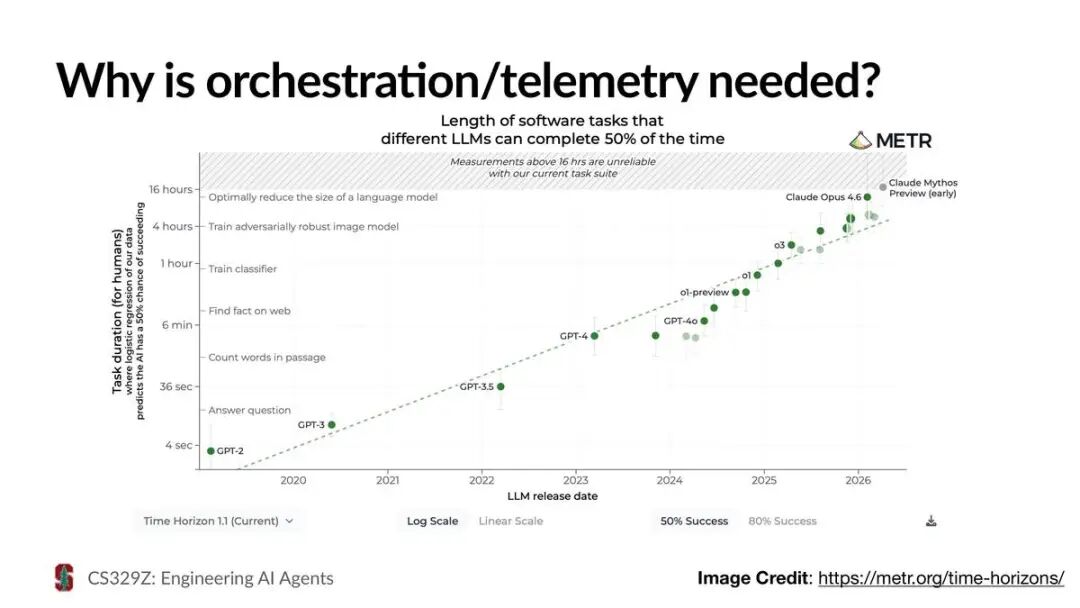
第 92 页问:为什么需要编排和遥测?图来自 METR,标题是「不同 LLM 有 50% 把握完成的软件任务有多长」。横轴是模型发布时间,刻度从 2020 年到 2026 年,GPT-2 的点在 2020 年之前;纵轴是这类任务人类要做多久,刻度从 4 秒,36 秒,6 分钟,1 小时,4 小时到 16 小时。
模型的点从左下的 GPT-2 一路往右上走:GPT-3,GPT-3.5,GPT-4,GPT-4o,o1-preview,o1,o3,Claude Opus 4.6,最右上角是 Claude Mythos Preview(early)。图的顶部有一条阴影带,注明 16 小时以上的测量不可靠。
补充METR 是一家做 AI 能力评估的研究机构,这张图是它的「时间跨度」(time horizon)指标。
第 93 页给出三条理由。agent 会运行很长时间(课件括号里说明,上一页的时长是按人类完成任务的时间算的),支撑它们的基础设施必须可靠。有日志和可观测性工具,调试起来更方便。这些是好的软件工程实践用教训换来的经验,可以搬到 agent 上。
第 94 页是 Temporal 的标志。
补充Temporal 是一个开源的「持久执行」(durable execution)平台。程序的每一步执行结果都被服务器记下来,进程崩溃后可以从记录里恢复,接着往下跑。
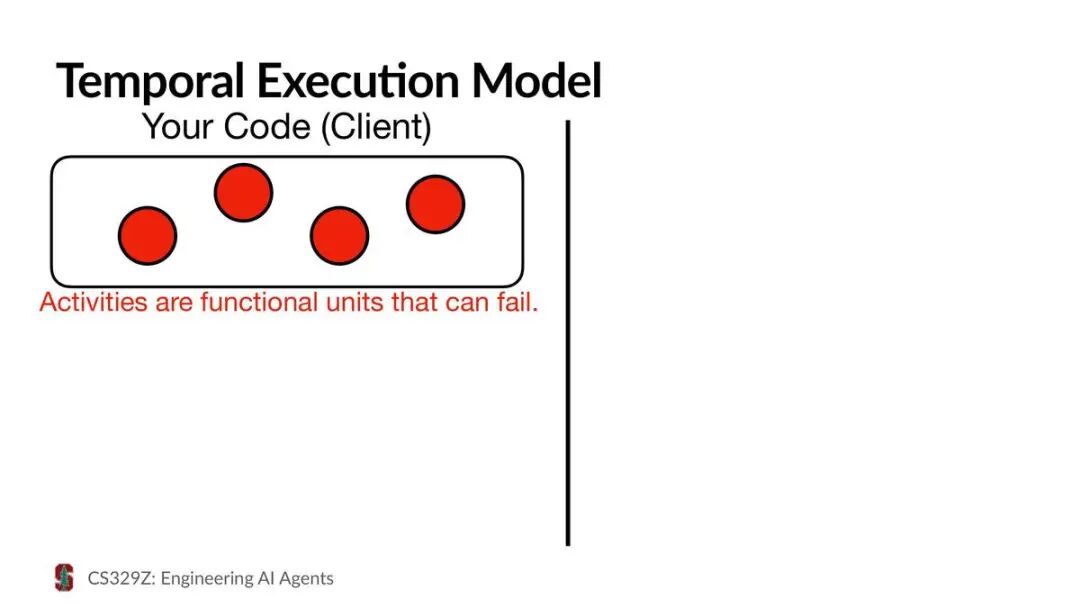
第 95 页开始一步步画 Temporal 的执行模型。左边是「你的代码(客户端)」,框里是四个红点。红字是:Activity 是可能失败的功能单元。
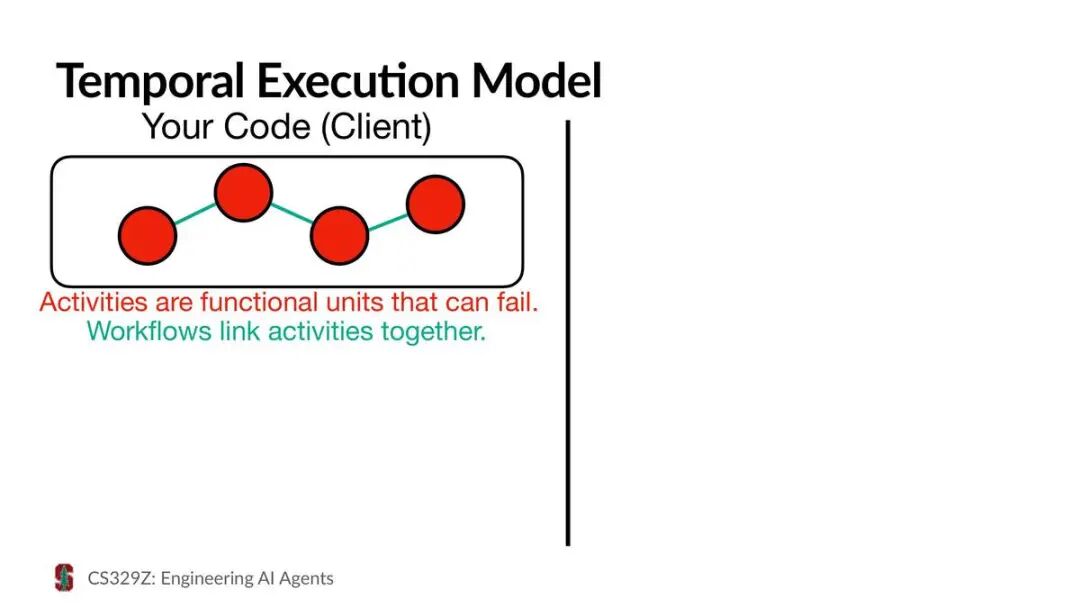
第 96 页用绿线把四个红点连起来,绿字是:Workflow 把 activity 串在一起。
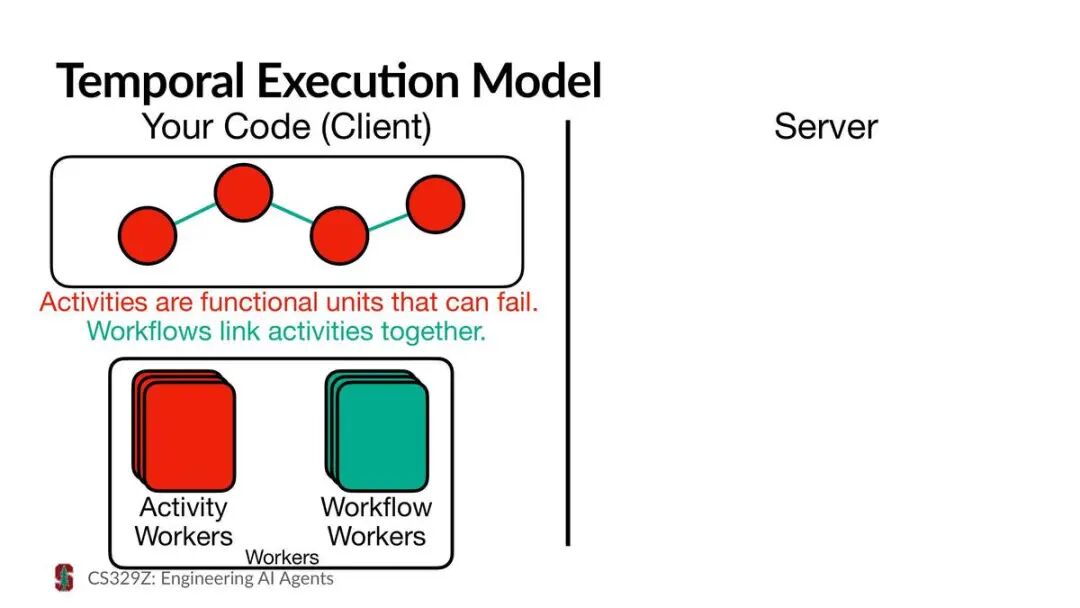
第 97 页在下方加了 Worker:一组 Activity Worker,一组 Workflow Worker。竖线右边出现了 Server(服务器),目前是空的。
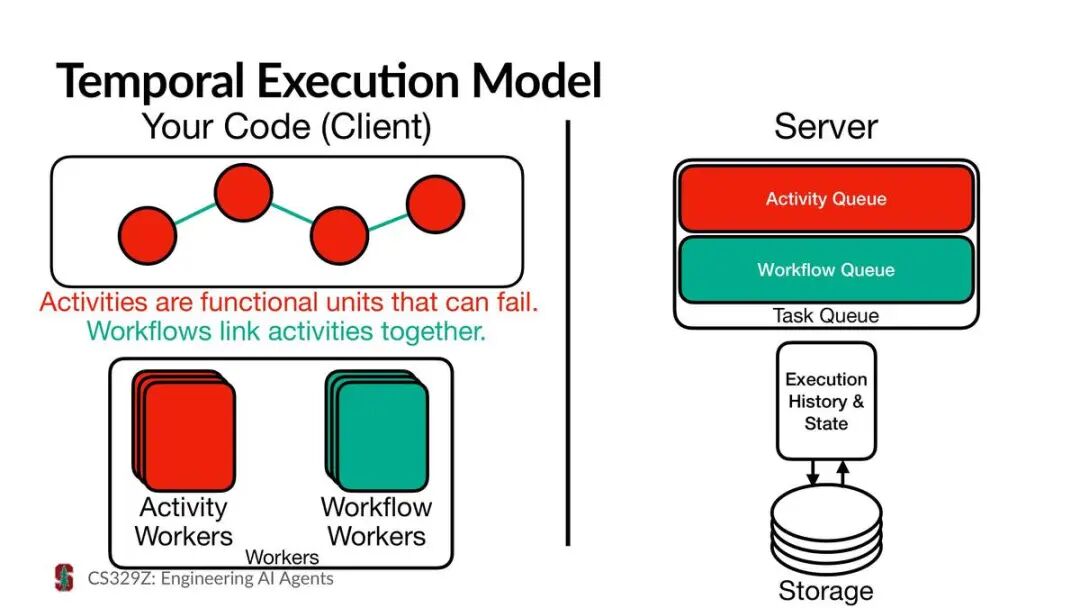
第 98 页把服务器画完:上面是任务队列,分 Activity 队列和 Workflow 队列;下面是执行历史和状态,读写存储。
第 99 页是「现场编程演示」,第 100 页是小标题页「持久工作流」。
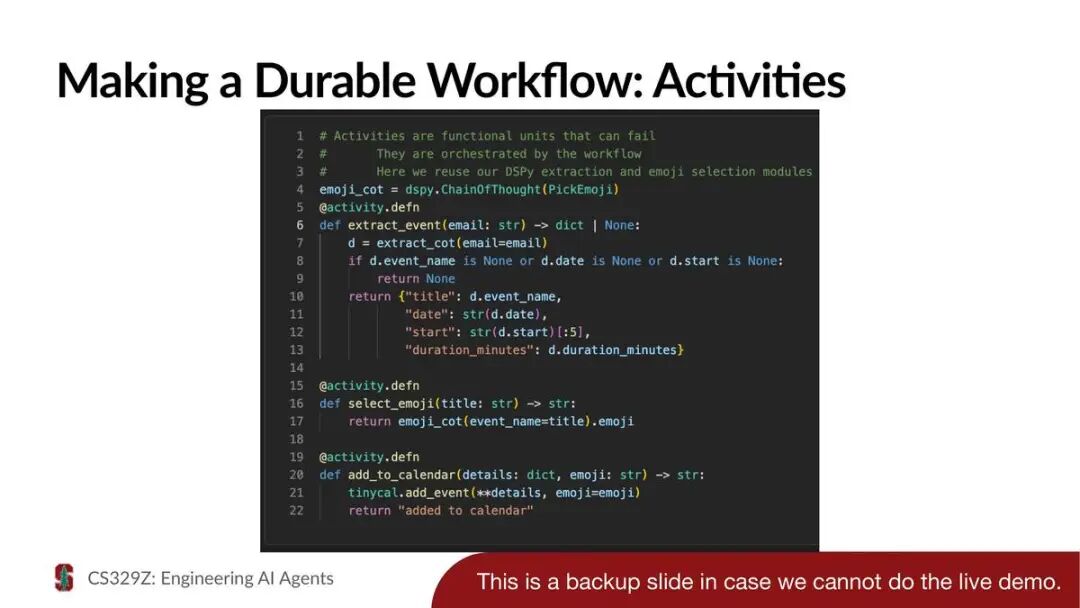
第 101 页定义 activity。注释写着:activity 是可能失败的功能单元,由 workflow 来编排,这里复用前面 DSPy 的抽取模块和挑 emoji 模块。三个函数都加了 @activity.defn 装饰器:extract_event 用 ChainOfThought 抽取事件,缺字段时返回空,否则返回一个包含标题,日期,开始时间,时长的字典;select_emoji 按标题挑 emoji;add_to_calendar 把事件写进 tinycal。
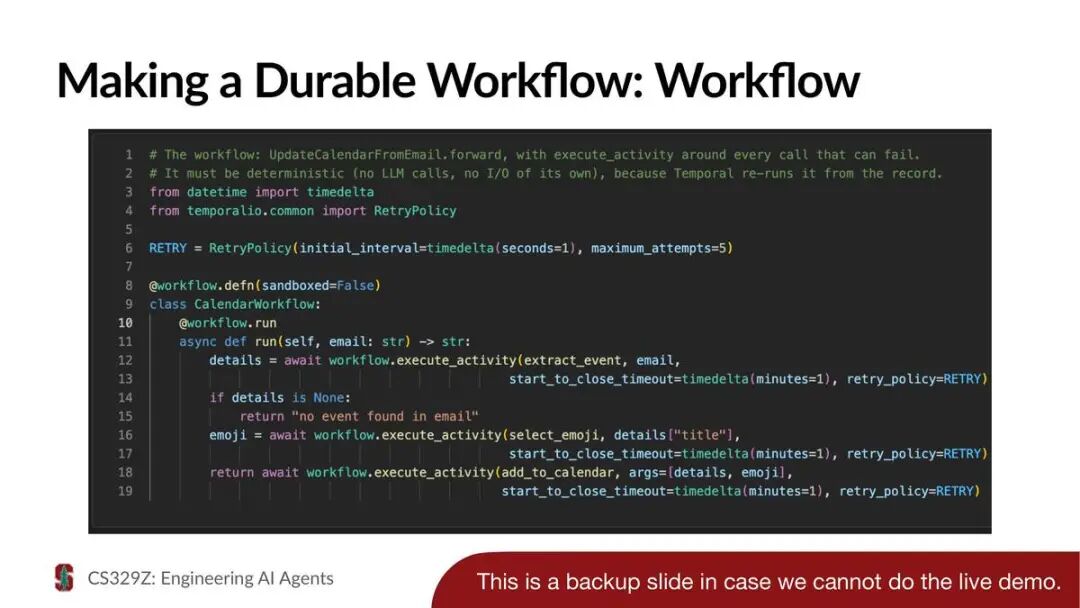
第 102 页定义 workflow。注释写着两点:这个 workflow 就是 UpdateCalendarFromEmail 的 forward,只是每个可能失败的调用外面都包了一层 execute_activity;workflow 本身必须是确定性的,自己不能调 LLM,也不能做 I/O,因为 Temporal 会按记录把它重新跑一遍。
重试策略是:初始间隔 1 秒,最多尝试 5 次。三个 activity 依次执行,每个都设了 1 分钟的超时,用同一个重试策略。抽取结果为空时,返回「邮件里没找到事件」。
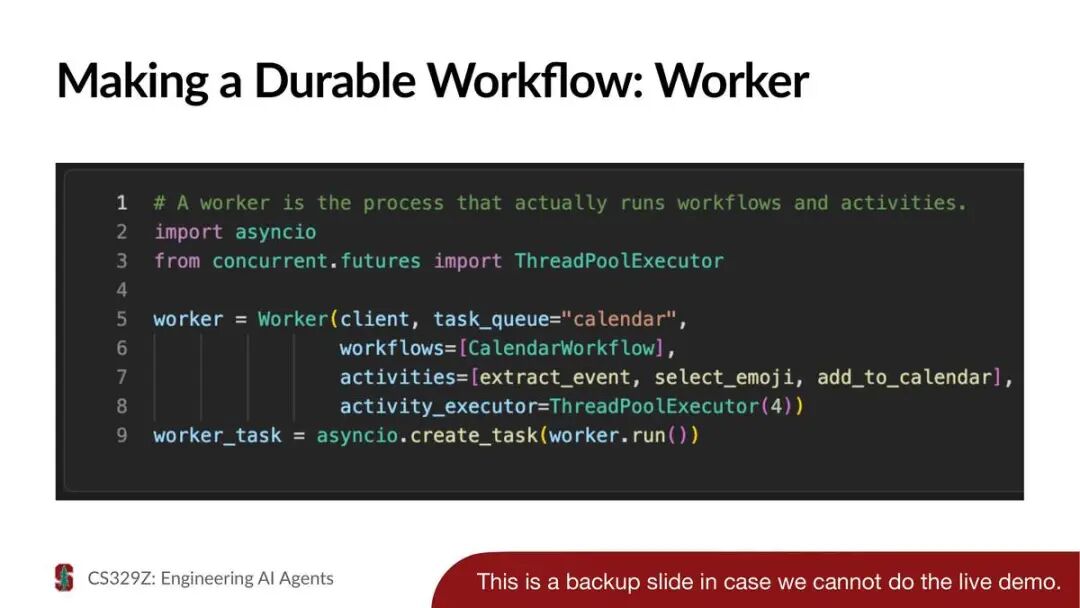
第 103 页定义 worker,注释写着:worker 是真正执行 workflow 和 activity 的进程。它连到客户端,监听名为 calendar 的任务队列,注册 CalendarWorkflow 和三个 activity,用一个 4 线程的线程池跑 activity,然后作为一个异步任务启动。
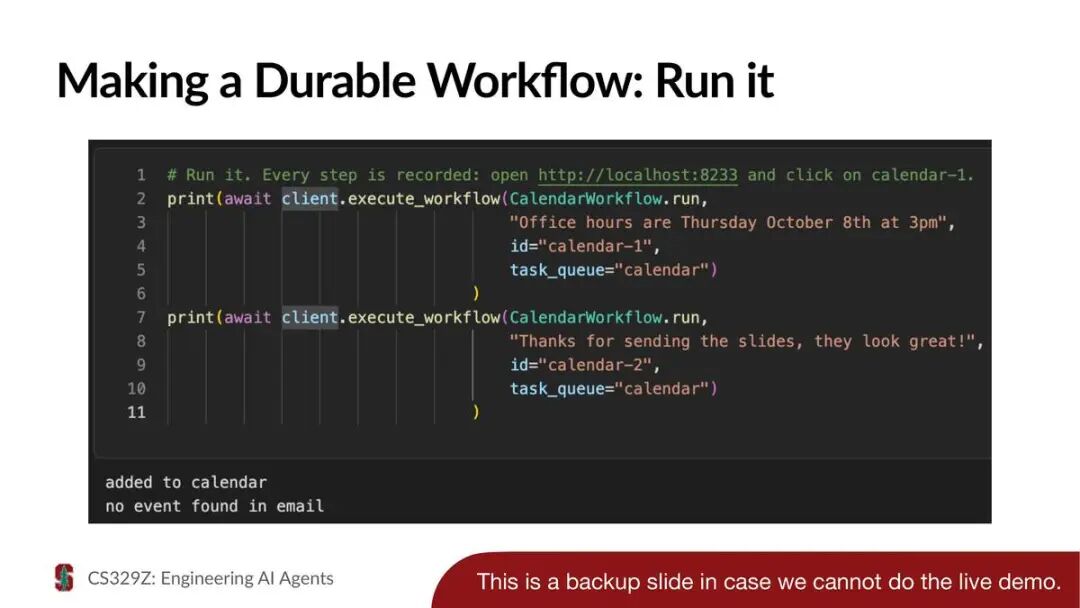
第 104 页运行。注释写着:每一步都有记录,打开 http://localhost:8233 ,点 calendar-1 就能看到。两次执行 workflow:第一次的邮件是「答疑时间是 10 月 8 日周四下午 3 点」,id 是 calendar-1;第二次是那封谢谢幻灯片的邮件,id 是 calendar-2。输出两行:已加入日历;邮件里没找到事件。
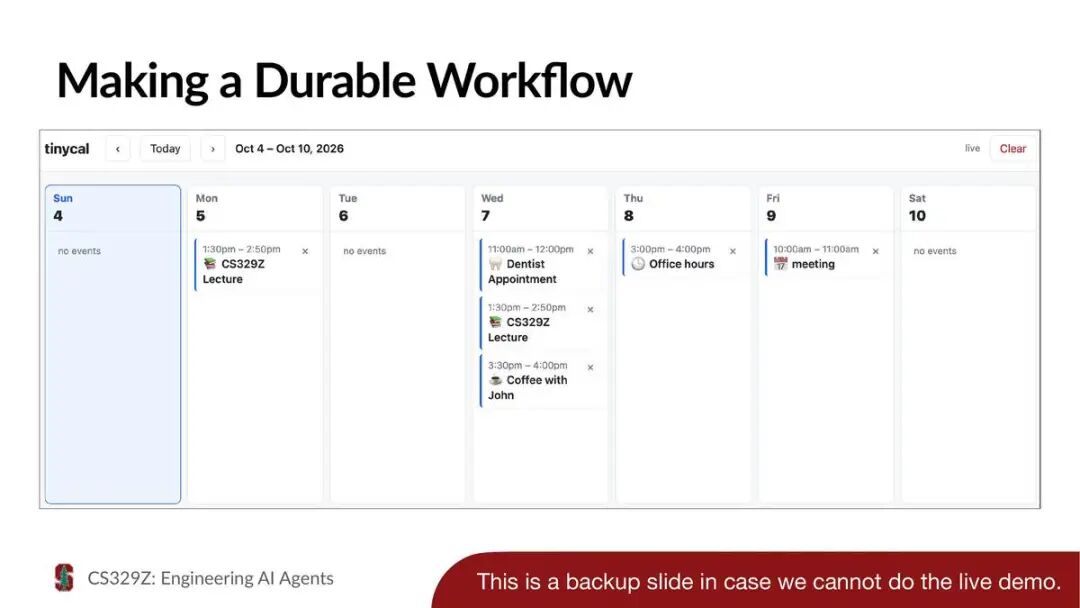
第 105 页的日历上,周四 8 日多了 3:00 到 4:00 的 Office hours(答疑时间)。
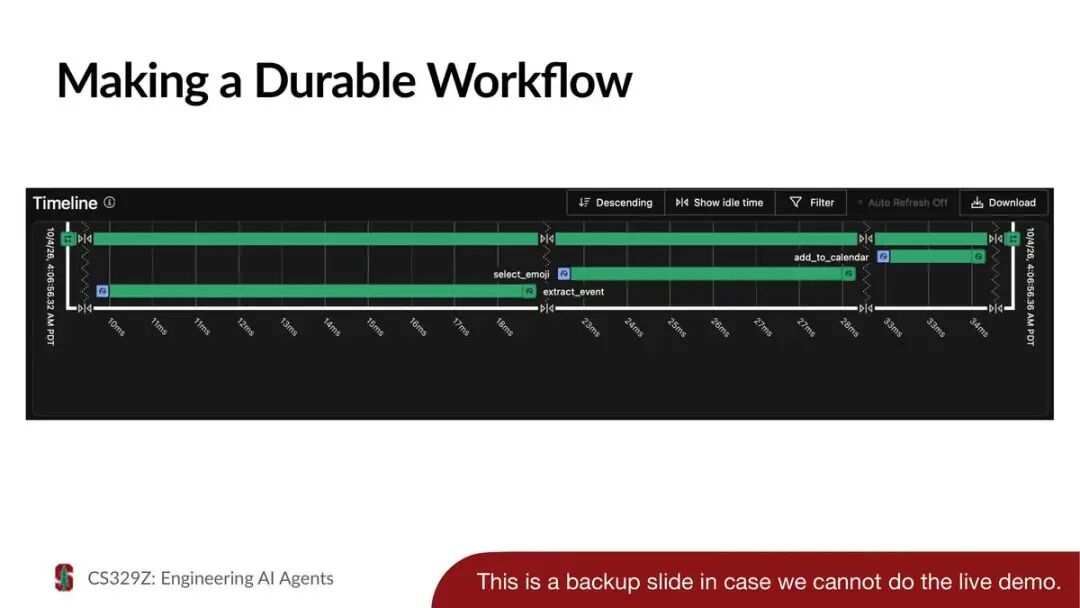
第 106 页是 Temporal 界面里这次运行的时间线。extract_event,select_emoji,add_to_calendar 三个 activity 依次排开,每一段都有起止时间。
第 107 页是小标题页「重试」。
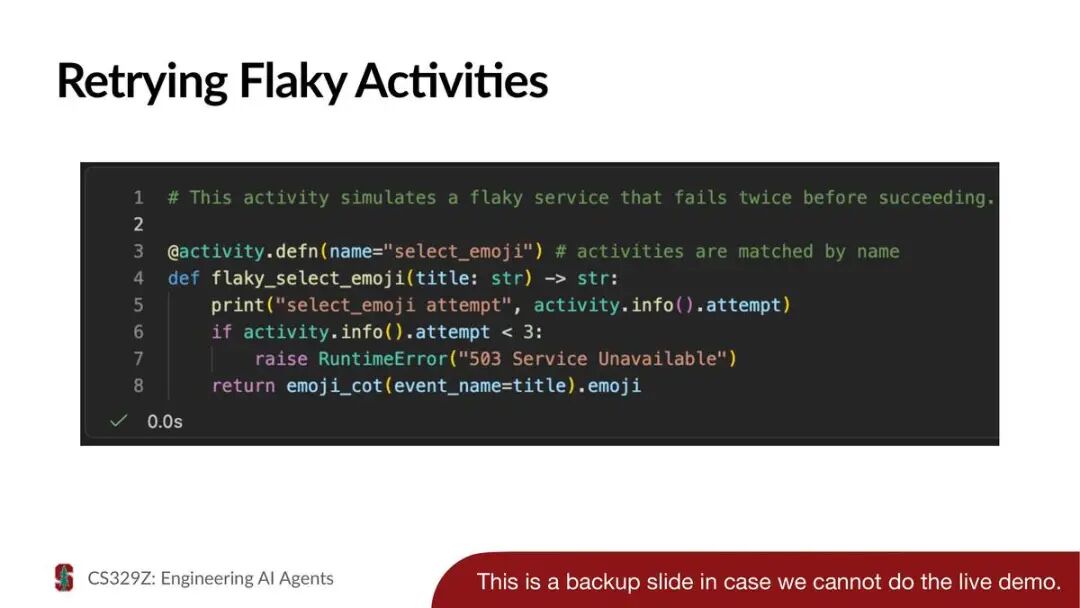
第 108 页模拟一个不稳定的服务,注释写着:这个 activity 先失败两次,第三次才成功。它注册的名字仍是 select_emoji,注释说明 activity 是按名字匹配的。函数里打印当前是第几次尝试,次数小于 3 就抛出「503 Service Unavailable」。
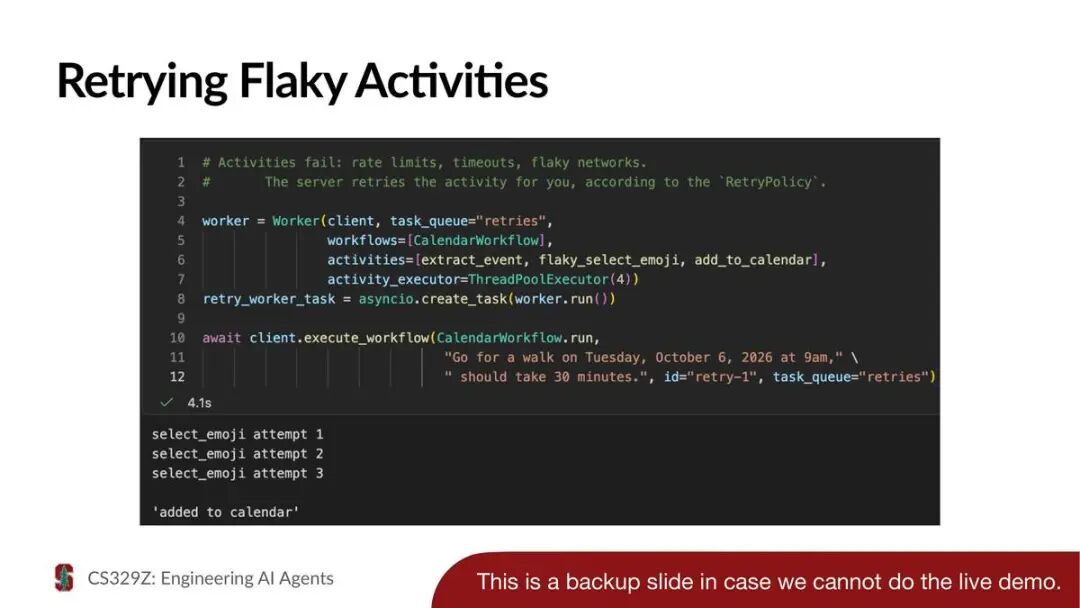
第 109 页的注释是:activity 会失败,原因有限流,超时,网络不稳定;服务器会按 RetryPolicy 替你重试。新起一个 worker,监听 retries 队列,把 select_emoji 换成这个不稳定的版本。执行的邮件是「10 月 6 日周二上午 9 点去散步,大概 30 分钟」。
输出依次是 select_emoji 第 1 次尝试,第 2 次尝试,第 3 次尝试,最后是已加入日历。
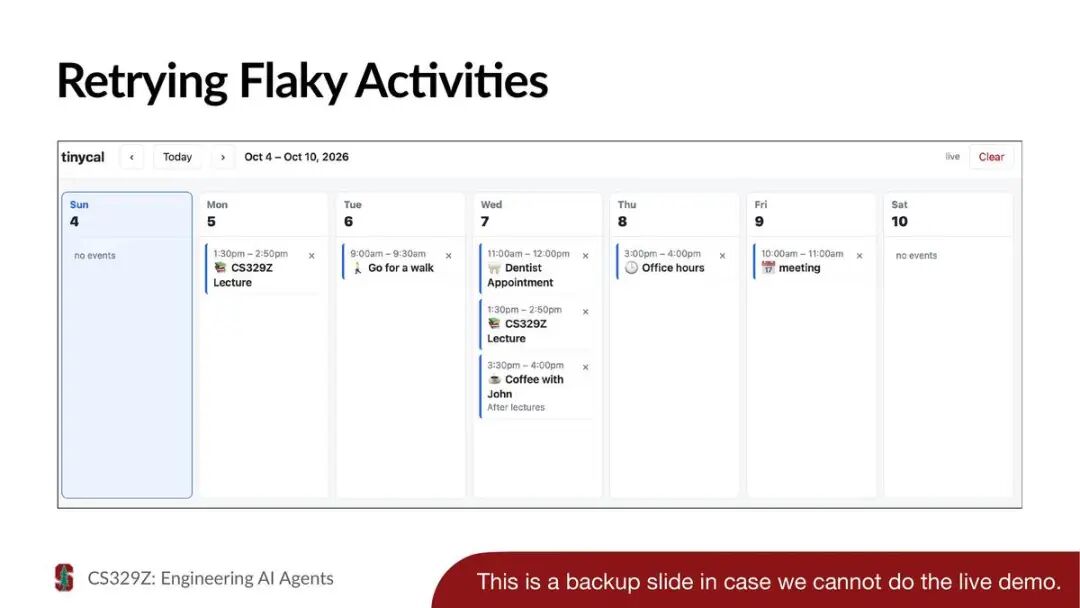
第 110 页的日历上,周二 6 日多了 9:00 到 9:30 的 Go for a walk(去散步)。
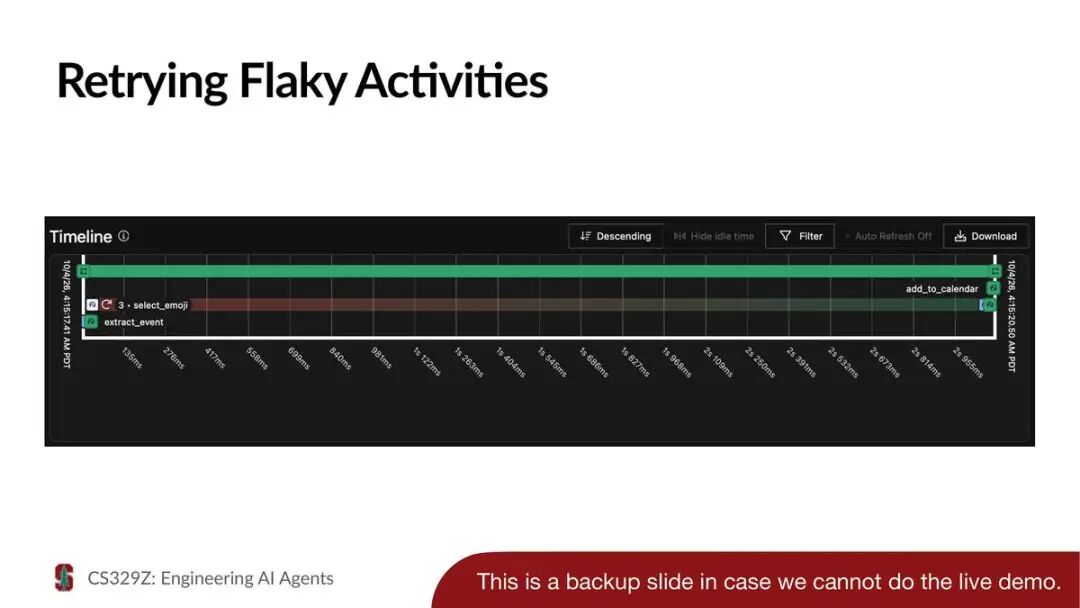
第 111 页是这次运行的时间线。select_emoji 那一行带着一个 3,表示尝试了 3 次,这一段比其他 activity 长得多。
第 112 页是小标题页「基于服务器的编排」。
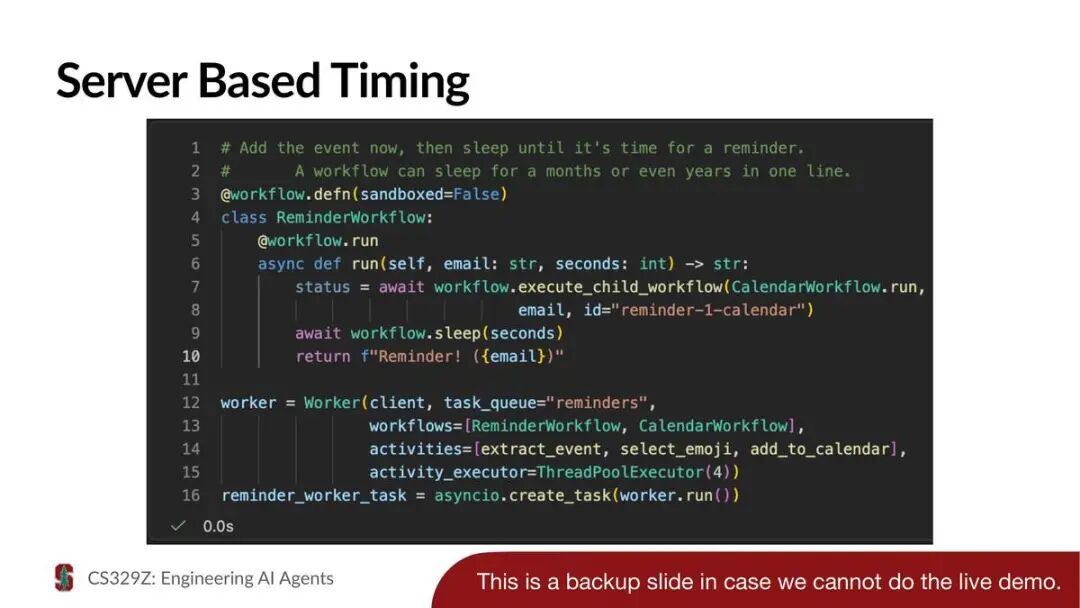
第 113 页的注释是:现在先加事件,然后睡到该提醒的时候;一个 workflow 用一行代码就能睡上几个月甚至几年。ReminderWorkflow 先把 CalendarWorkflow 作为子 workflow 执行,把事件写进日历;然后调用 workflow.sleep 睡指定的秒数;醒来后返回一条提醒。worker 监听 reminders 队列。
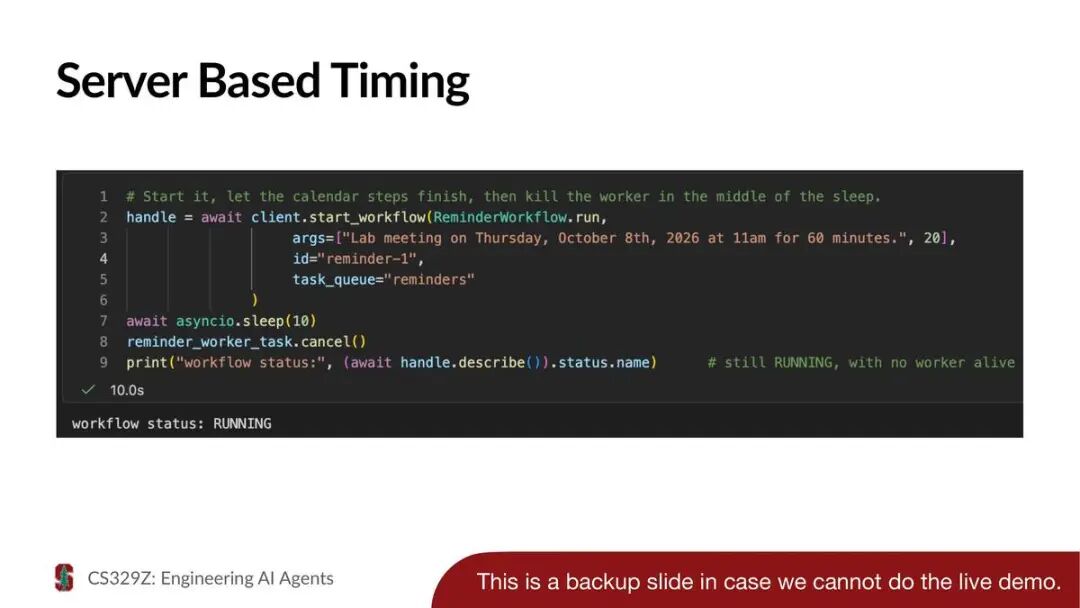
第 114 页的注释是:启动它,等日历那几步做完,然后在睡眠中途把 worker 杀掉。启动时传入「10 月 8 日周四上午 11 点开 60 分钟的组会」,睡眠 20 秒。等 10 秒后取消 worker 任务,再查 workflow 的状态。
输出是 workflow status: RUNNING。代码注释写着:仍是 RUNNING,尽管已经没有活着的 worker。
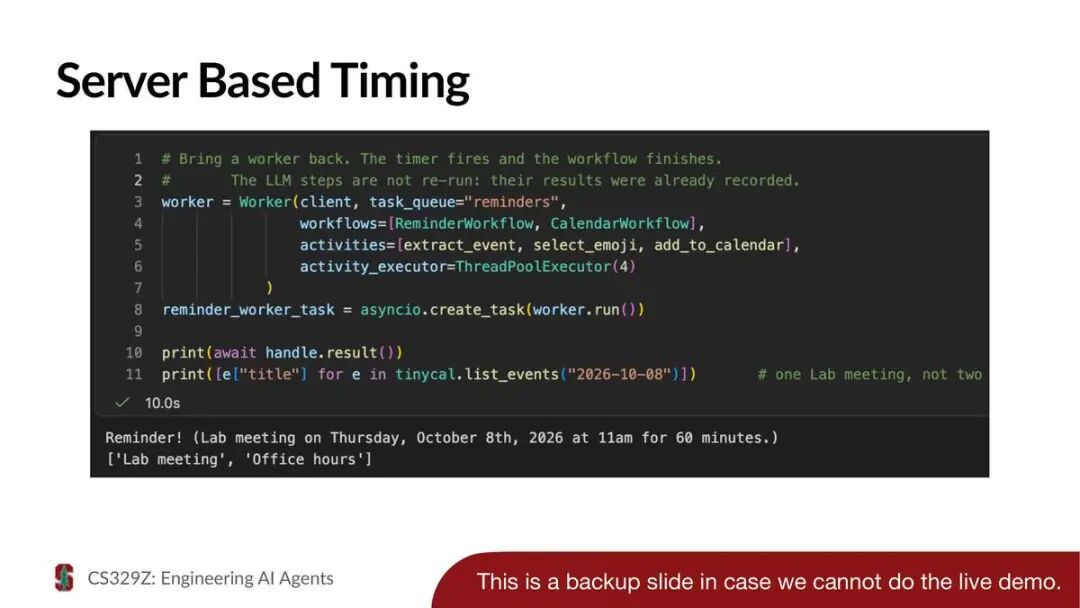
第 115 页的注释是:把 worker 带回来,计时器到点,workflow 跑完。LLM 那几步不会重跑,因为它们的结果已经记录过了。
新起一个 worker 后,打印 workflow 的结果和 10 月 8 日的事件列表。结果是一条提醒:「Reminder!(10 月 8 日周四上午 11 点 60 分钟的组会)」;事件列表是 Lab meeting 和 Office hours,代码注释写着:一个组会,不是两个。
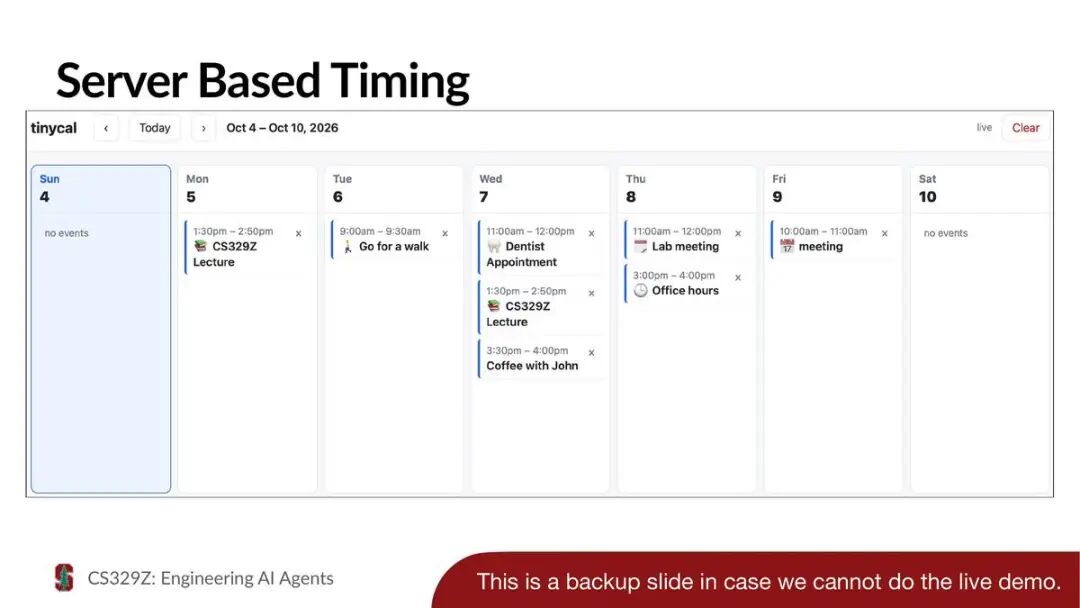
第 116 页的日历上,周四 8 日出现了 11:00 到 12:00 的 Lab meeting,下面是之前的 Office hours。
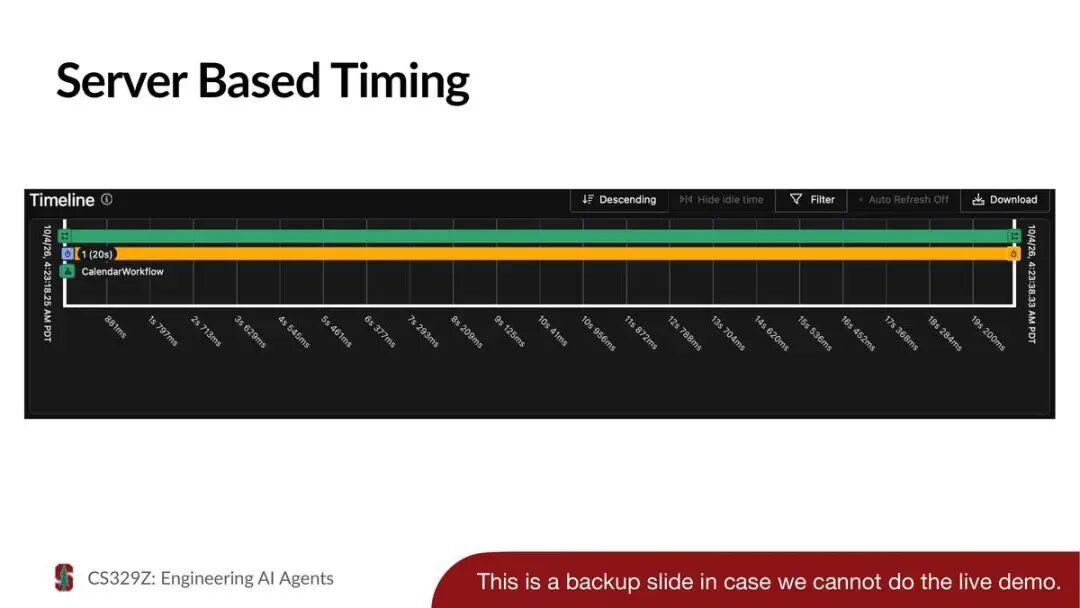
第 117 页是这次运行的时间线,中间一条橙色长条标着「1 (20s)」,就是那 20 秒的计时器。下面一行是子 workflow CalendarWorkflow。
第 118 页是小标题页「其他可观测性框架」。
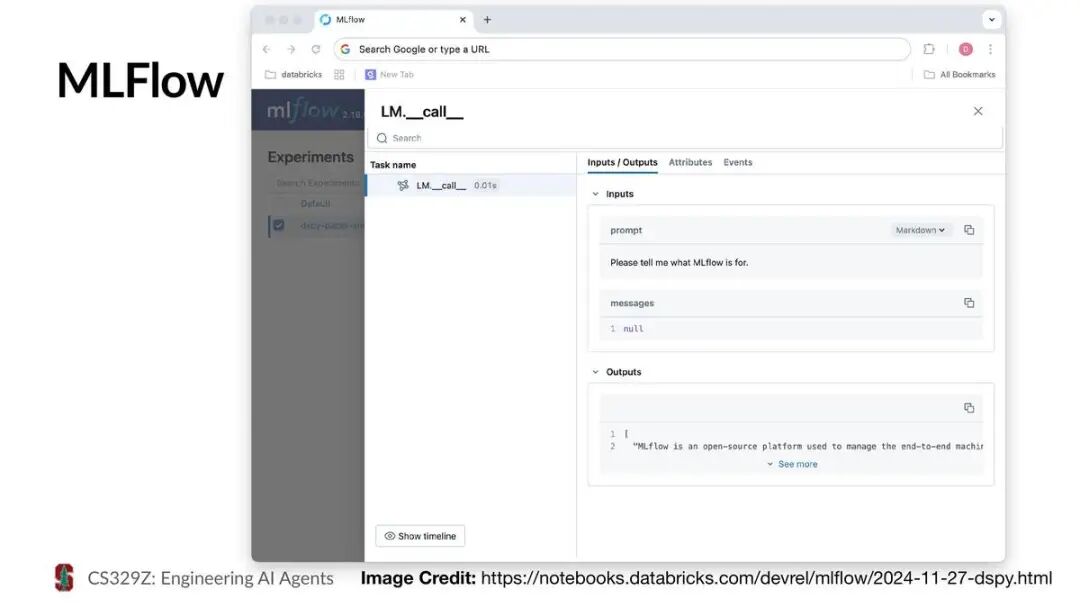
第 119 页是 MLflow,截图来自 Databricks 的一份 DSPy 示例 notebook。界面里是一次 LM.__call__ 的追踪记录,左边列出任务名,右边分输入和输出两栏:输入的 prompt 是「告诉我 MLflow 是做什么的」,输出是模型的回答。
补充MLflow 是 Databricks 开源的机器学习生命周期管理平台,后来加了对 LLM 调用的追踪。
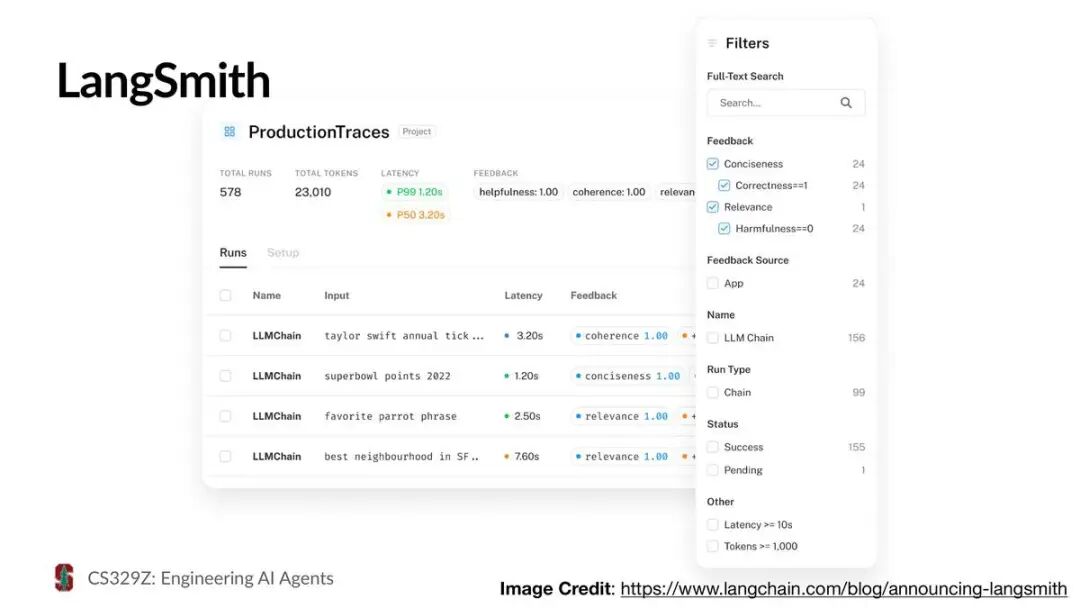
第 120 页是 LangSmith,截图来自 LangChain 宣布推出 LangSmith 的博客。界面是一个叫 ProductionTraces 的项目,上方是总运行次数,总 token 数,延迟和反馈分数等汇总,下方逐行列出每次运行的名字,输入,延迟和反馈,右边是一栏筛选条件。
补充LangSmith 是 LangChain 公司的 LLM 应用追踪和评估平台。
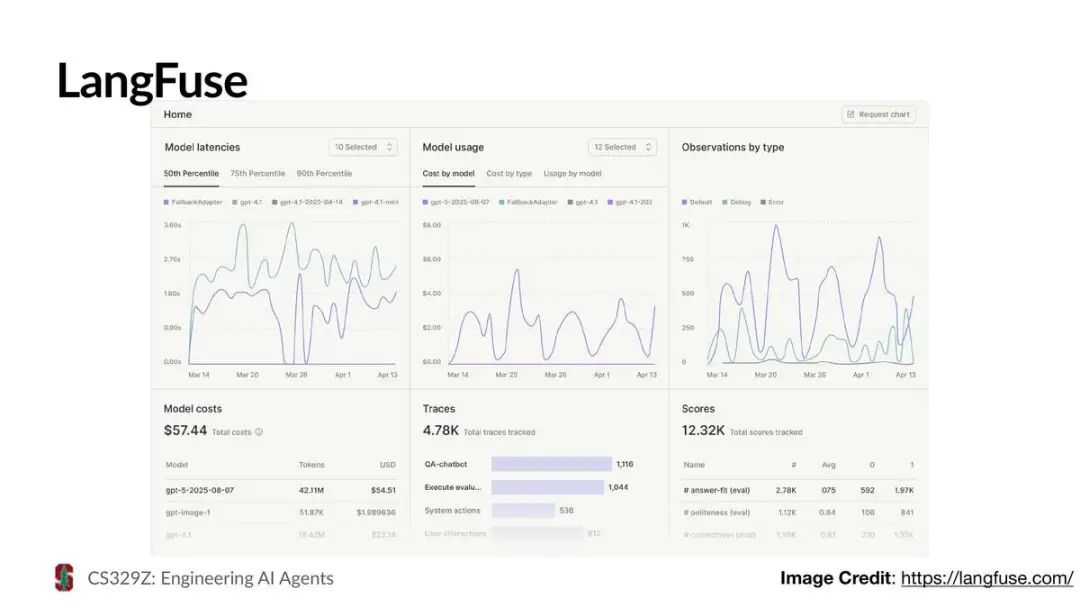
第 121 页是 Langfuse,截图来自 Langfuse 官网。界面是一个仪表盘,上排是模型延迟,模型用量,按类型统计的观测数三张折线图;下排是模型成本表,追踪记录数的条形图和评分表。
补充Langfuse 是一个开源的 LLM 应用可观测性平台。
第 122 页是这一块的小结,四条。编排让 agent 保持可靠。可观测性让调试和监控成为可能。软件工程里的最佳实践和工具,也会延续到 agent 工程里。搭好评估,监控,持久执行等等,正是「搭 agent」和「工程化 agent」的区别。
六、最佳实践与挑战
最后一块给出几条做法:能用工作流就别上 agent,让失败能看见也能恢复,用自己领域的评估来做设计决定。
第 123 页是第五块的标题页:最佳实践与挑战。
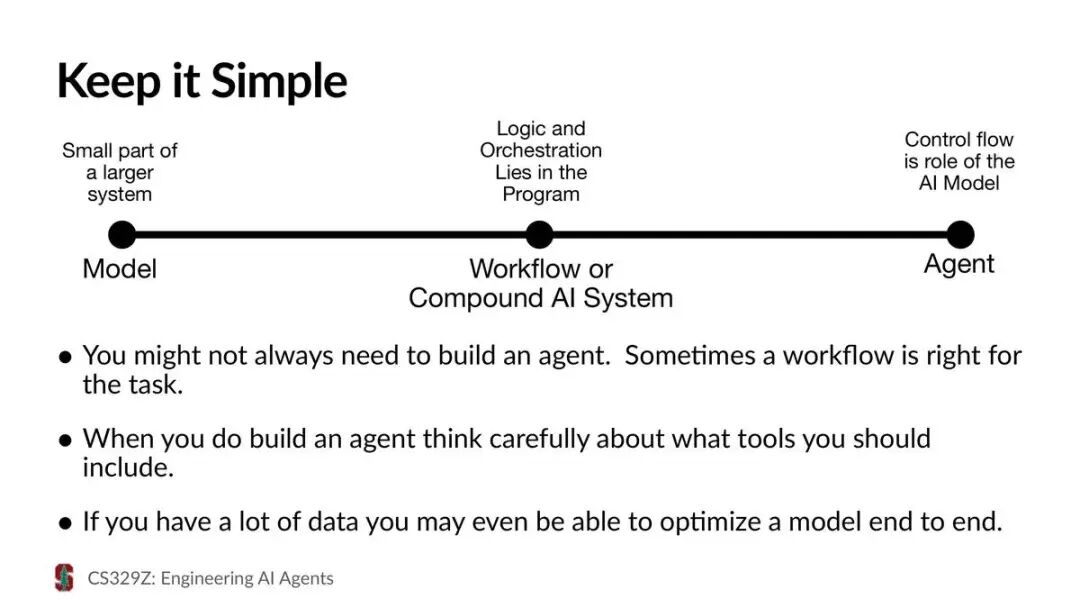
第 124 页的标题是「保持简单」,上面又放了一次那条从模型到 agent 的光谱,下面三条。你不一定总需要搭一个 agent,有时工作流才是适合这个任务的。真要搭 agent,就仔细想好该给它哪些工具。如果你有很多数据,甚至可以端到端地优化一个模型。
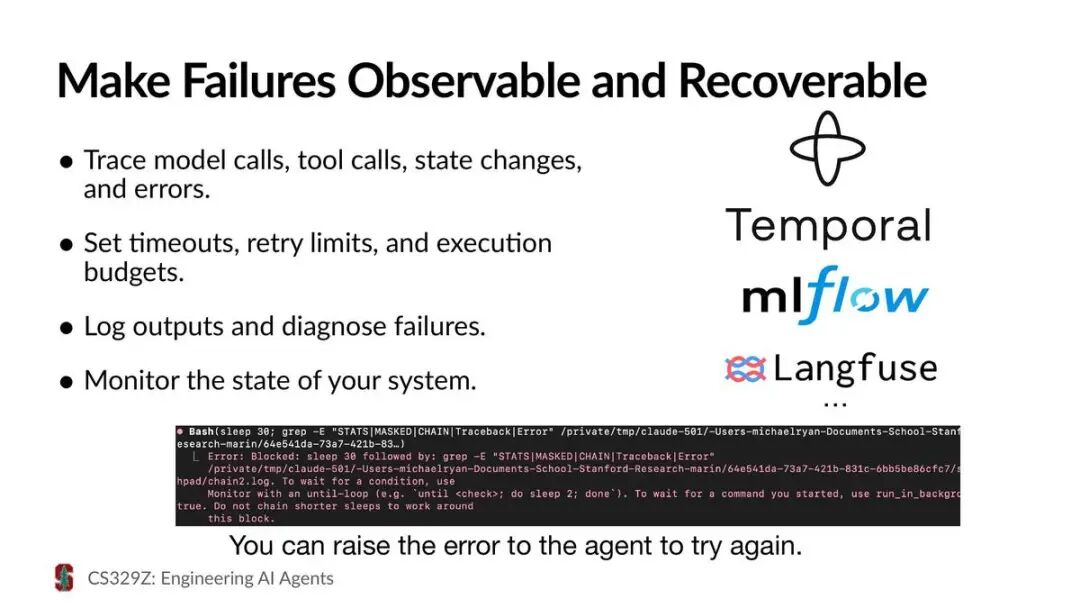
第 125 页的标题是「让失败能被看见,也能被恢复」,四条。追踪模型调用,工具调用,状态变化和错误。设置超时,重试上限和执行预算。记录输出,诊断失败。监控系统的状态。
右边是 Temporal,MLflow,Langfuse 的标志。下面是一张终端截图:agent 发出的一条先 sleep 30 秒再 grep 日志的 Bash 命令被拦了下来,报错信息告诉它,等一个条件该用带 until 循环的监控方式,等自己启动的命令该用后台运行,不要把短的 sleep 串起来绕过这个限制。截图下的说明是:可以把错误抛回给 agent,让它再试一次。
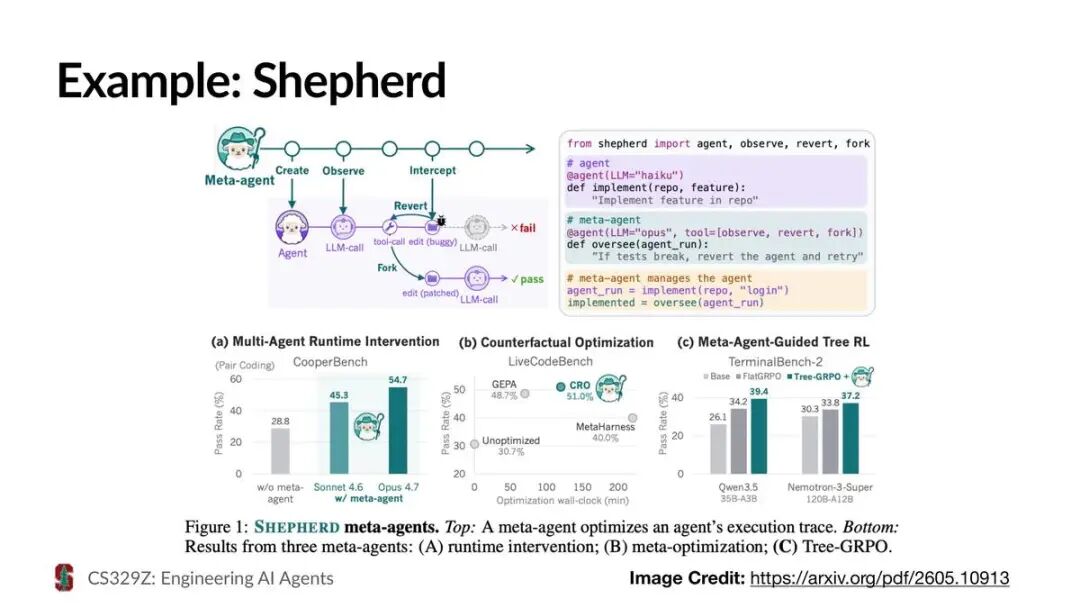
第 126 页举了一个例子:Shepherd,图来自论文 arXiv 2605.10913。
上半部分是示意图和代码。一个元 agent(meta-agent)管着一个 agent:它可以创建 agent,观察 agent 的调用,在 agent 改出有 bug 的代码时拦截,回退(revert),再从某一步分叉(fork)出一条新路径重试。右边的代码里,agent 用 haiku 模型实现一个功能;元 agent 用 opus 模型,带 observe,revert,fork 三个工具,指令是「测试挂了,就回退 agent 再重试」。
下半部分是三个元 agent 的结果。
(a) 多 agent 运行时干预,CooperBench 结对编程:不用元 agent 时通过率 28.8%;用了元 agent,Sonnet 4.6 是 45.3%,Opus 4.7 是 54.7%。
(b) 反事实优化,LiveCodeBench,横轴是优化花的时间:不优化 30.7%,GEPA 48.7%,MetaHarness 40.0%,CRO 51.0%。
(c) 元 agent 引导的树状强化学习,TerminalBench-2:Qwen3.5 35B-A3B 上,基线 26.1%,FlatGRPO 34.2%,Tree-GRPO 加元 agent 39.4%;Nemotron-3-Super 120B-A12B 上,依次是 30.3%,33.8%,37.2%。
第 127 页的标题是「做评估」,五条。做设计决定,最好的办法是以评估为依据。评估让优化成为可能。搭一个像样的评估,是做 AI 系统时最重要的步骤之一。指标要选好,比如准确率,成本,延迟。要测有代表性的任务,边界情况和失败场景。
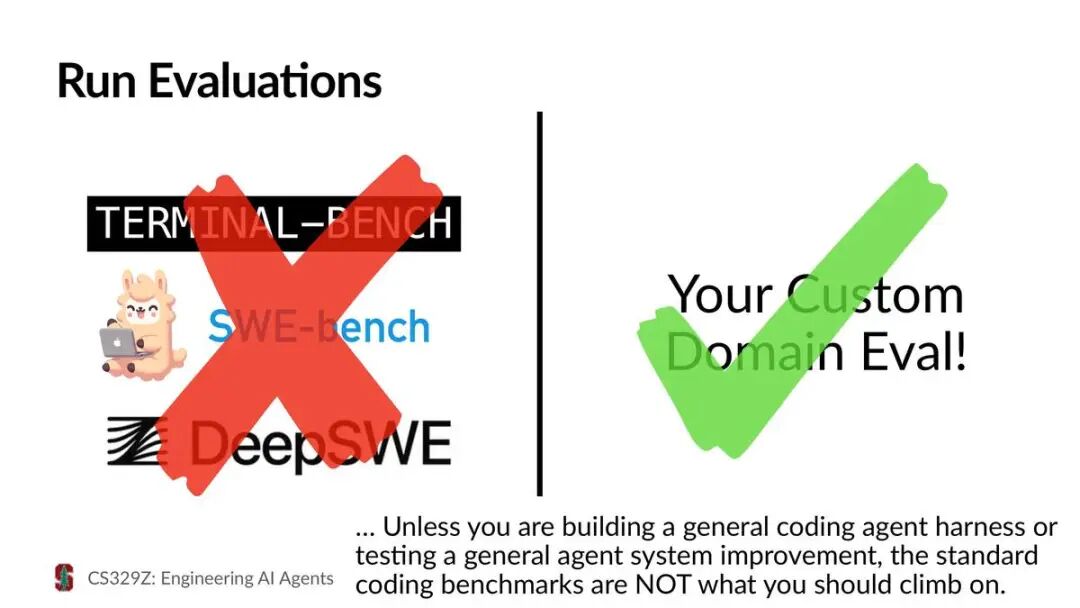
第 128 页左右对照。左边是 Terminal-Bench,SWE-bench,DeepSWE 三个标志,上面画了一个大红叉;右边是「你自己领域的评估」,打了一个绿勾。
下面一行字:除非你在做一个通用的编码 agent 脚手架,或者在测试一项通用的 agent 系统改进,否则标准的编码基准不是你该去爬榜的东西。
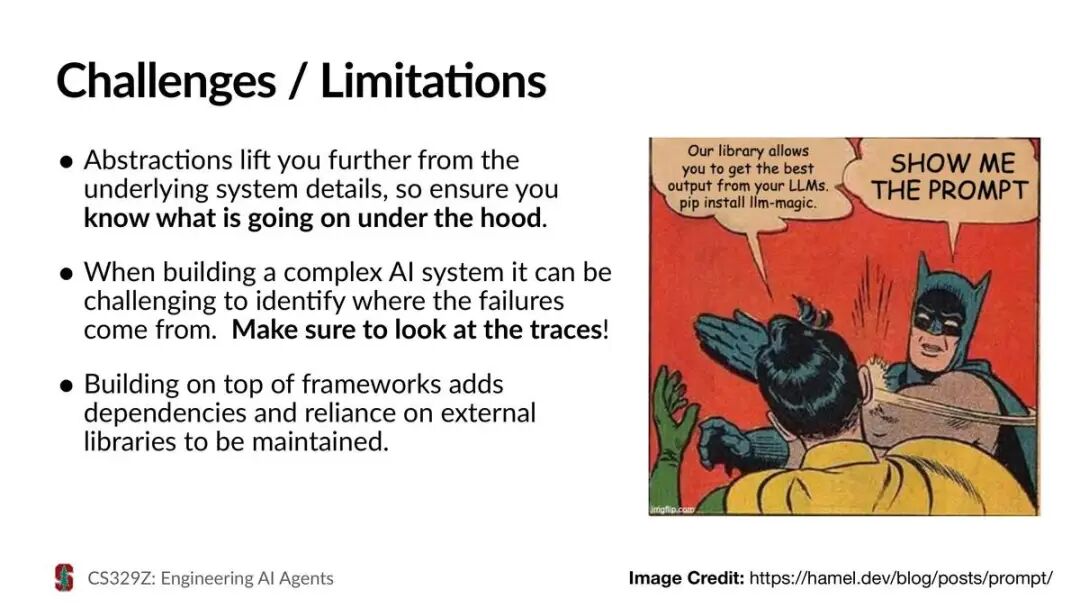
第 129 页是挑战和局限,三条。抽象让你离底层系统细节更远,所以要确保你知道底下在发生什么。搭一个复杂的 AI 系统时,很难看出失败出在哪里,一定要看追踪记录。建立在框架之上,会增加依赖,要依靠外部库有人维护。
右边是一张漫画:一个人说「我们的库能让你的 LLM 输出最好的结果,pip install llm-magic」,另一个人打断他,说「给我看提示词」。图片来源是 Hamel Husain 的博客。
补充Hamel Husain 这篇博客讲的是怎样拦截 LLM 框架实际发给模型的提示词,看清框架在底下做了什么。
第 130 页是这一块的小结,五条。工程化 agent 的过程是搭建,运行,评估,改进,是一个循环。从简单开始,增加复杂度要有理由。为失败和恢复做设计。用证据和评估来衡量质量,成本和延迟。完全弄懂你的系统是怎么运作的。
第 131 页是总结的标题页,进度条上五段都是黑色。
最后
第 132 页是这一讲的总结,五块都打上了勾。按这五块,把这一讲压成几段话:
什么叫工程化 agent:AI 系统有三根支柱,数据,系统,评估。只做系统是 AI 系统,三样一起做才是 AI 系统工程。框架按控制流交给谁,排在从模型到工作流再到 agent 的光谱上。
工作流框架:DSPy 用签名规定输入输出,用模块规定怎么完成,用优化器拿数据和指标改提示词或权重。课上的例子里,GEPA 只改了指令文本,Gemma 3 12B 在 20 条测试邮件上的得分从 55% 升到 100%。LangGraph 用共享状态,节点和边来写同一个流程,条件边由普通 Python 函数决定走向。两个框架都能用一两行代码做出一个 agent。
开源脚手架:mini SWE-agent,OpenHands,Pi,OpenClaw 在工具,历史,终端,权限,记忆上各做各的取舍。同一个模型换脚手架,Terminal-Bench 2 上的成功率最多差了 16.7 个百分点(Haiku 4.5,47.8% 对 31.1%)。Meta-Harness 让 agent 读过去所有候选的代码和日志,自己写新的脚手架。
编排与遥测:Temporal 把可能失败的调用包成 activity,由确定性的 workflow 串起来,服务器记下每一步。演示里,失败的 activity 自动重试到第 3 次成功;worker 被杀掉后 workflow 仍是 RUNNING,worker 回来后接着跑完,LLM 那几步不重跑。MLflow,LangSmith,Langfuse 负责追踪和监控。
最佳实践:能用工作流就不一定要上 agent;让失败能被看见,也能被恢复;用自己领域的评估做设计决定,标准编码基准不是该爬的榜;用框架时,要看清它在底下做了什么。
据课程官网,这一讲的必读是 DSPy 的论文,Khattab 等人,ICLR 2024:
https://arxiv.org/abs/2310.03714
按官网课表,下一讲是 10 月 12 日的「Agent Design Patterns & Scaffolds」,内容包括工作流和 agent 的分类,五种可组合的工作流模式,agent 模式(ReAct,先计划再执行,反思),以及把脚手架当作设计决定来看。必读是 ReAct 的论文。
本文是斯坦福 CS 329Z《Engineering AI Agents》(Fall 2026)第 5 讲课件的逐页讲解,非官方笔记,内容以课件原件为准。课件版权归讲师 Diyi Yang、Michael Ryan、John Yang。课程主页 https://cs329z.stanford.edu/ ,本讲课件 PDF https://web.stanford.edu/class/cs329z/slides/lecture05.pdf (链接来自课程主页课表里第 5 讲的 Slides)。

内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢