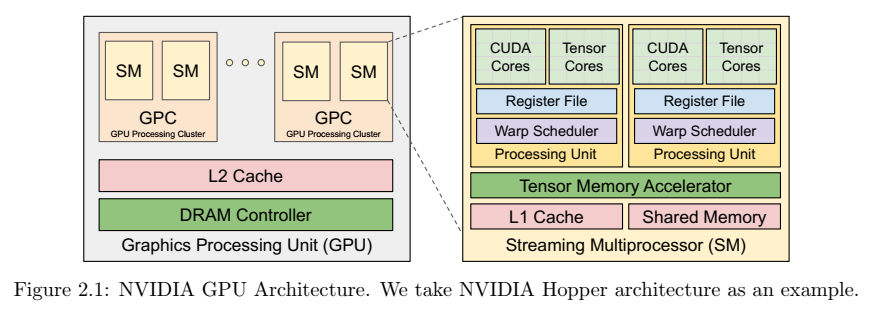
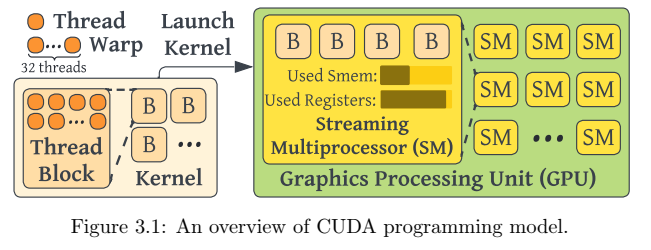
过去十年,深度学习取得了显著进展,推动了计算机视觉、自然语言处理和对话式人工智能领域的突破。深度学习模型的大规模部署,尤其是拥有数十亿参数的大型语言模型,极大地增加了计算需求,使得GPU上张量计算的效率成为重中之重。尽管已经开发出领域特定语言(DSL)和编译器来自动化生成张量程序,但现有方法在编程简易性和性能控制之间仍面临着根本性的权衡。面向调度的框架(例如TVM)难以表达最先进的GPU内核所需的细粒度优化,而像CUDA这样的底层方法则需要丰富的架构专业知识。此外,模型量化技术的日益普及也带来了对支持非标准位宽的高效GPU内核的迫切需求,而现有系统无法充分满足这一需求。
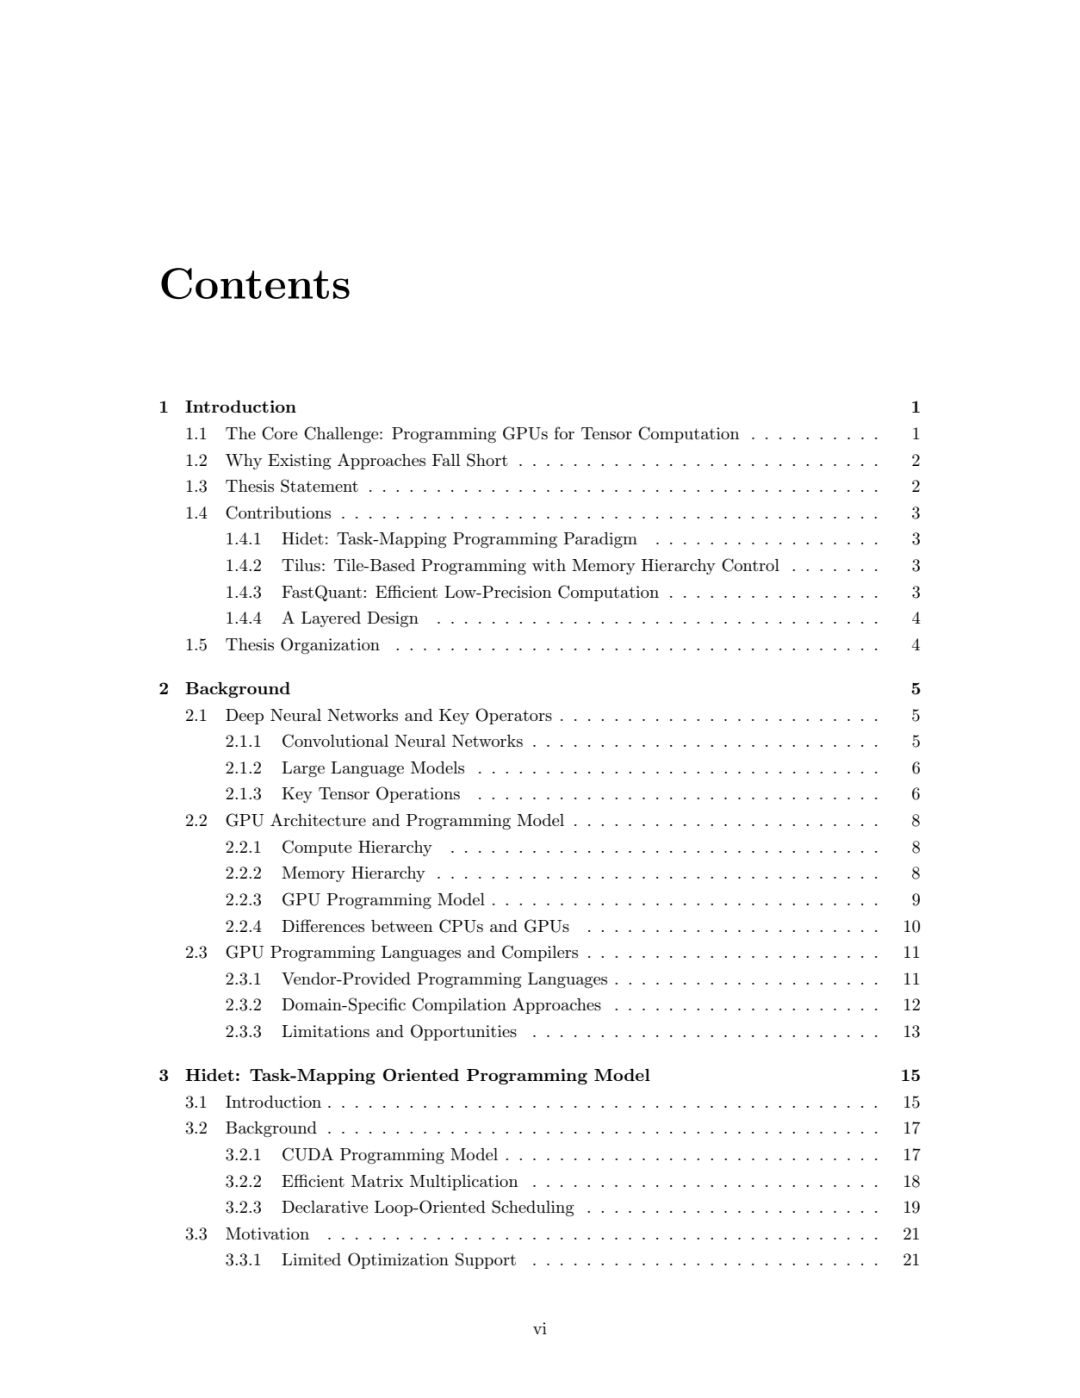
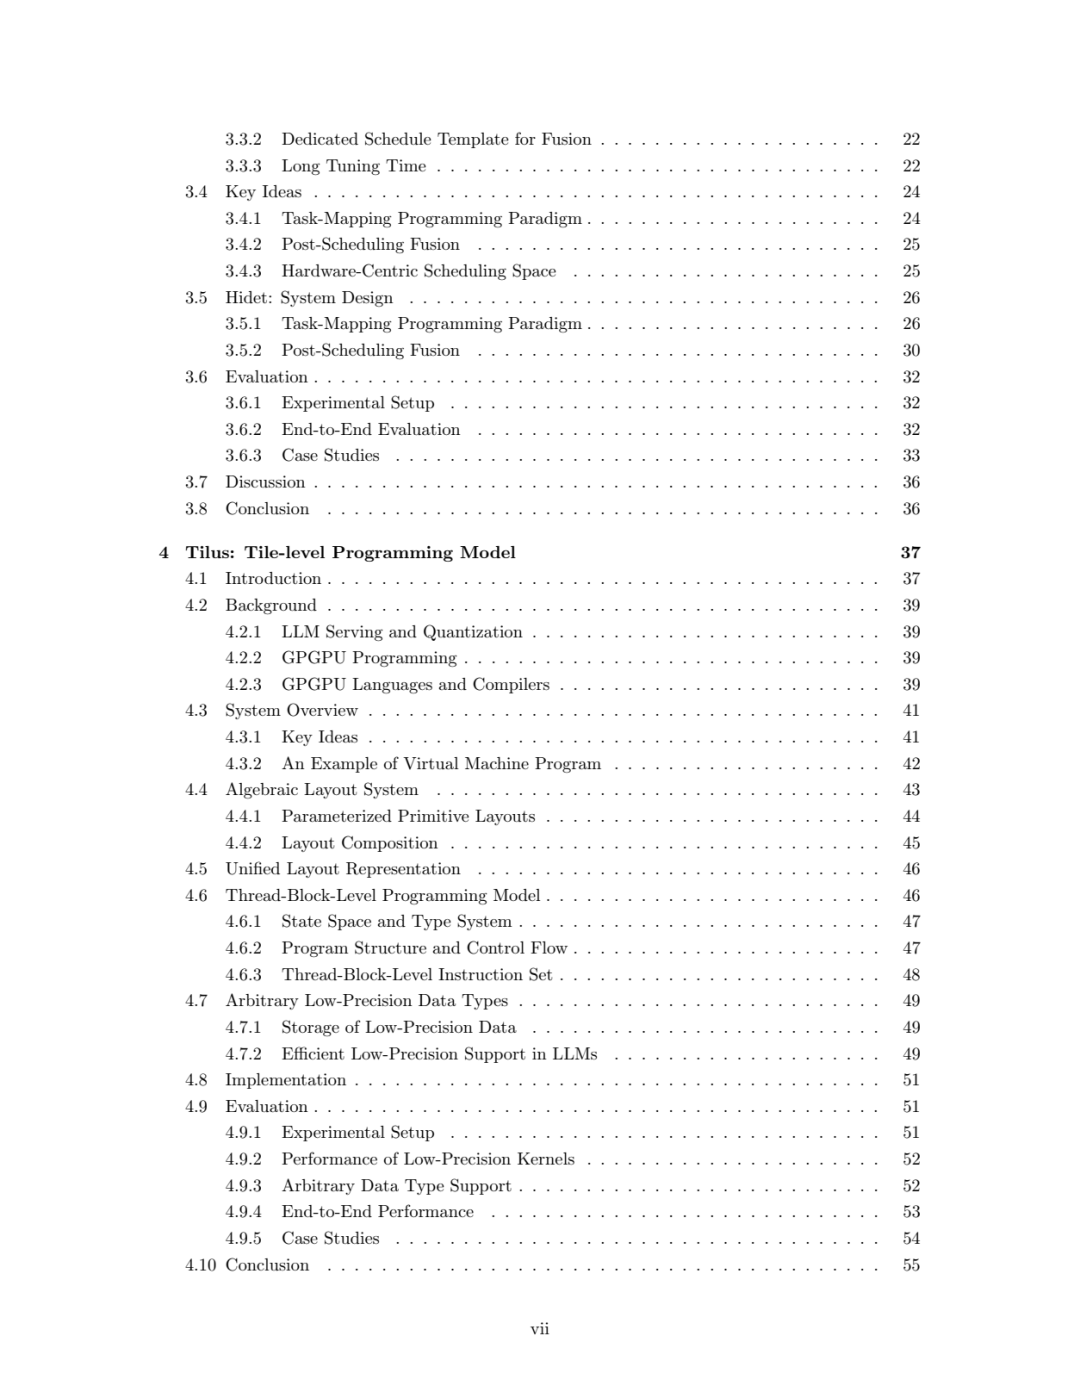
在本论文中,我们提出了一系列用于在现代GPU上进行张量编译的渐进式高级编程抽象,每个抽象都针对先前方法的一个关键局限性。
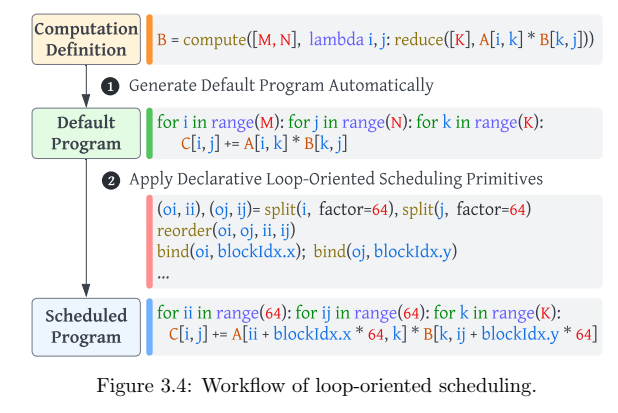
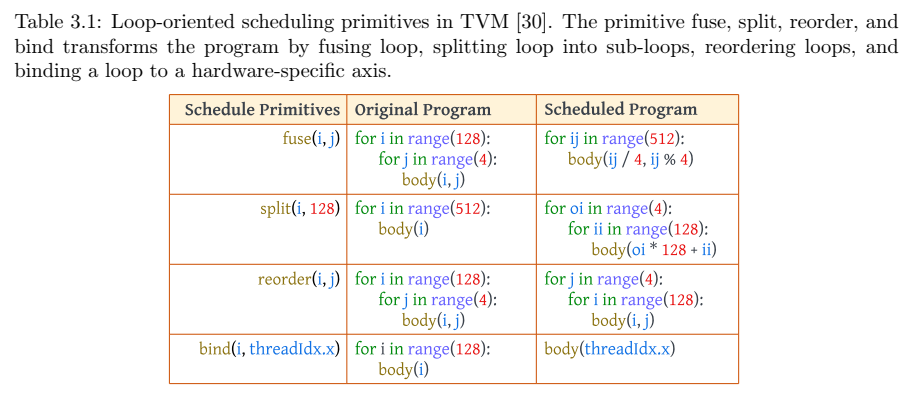
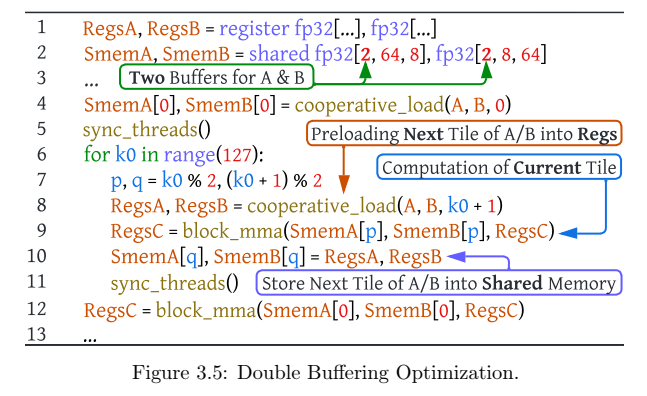
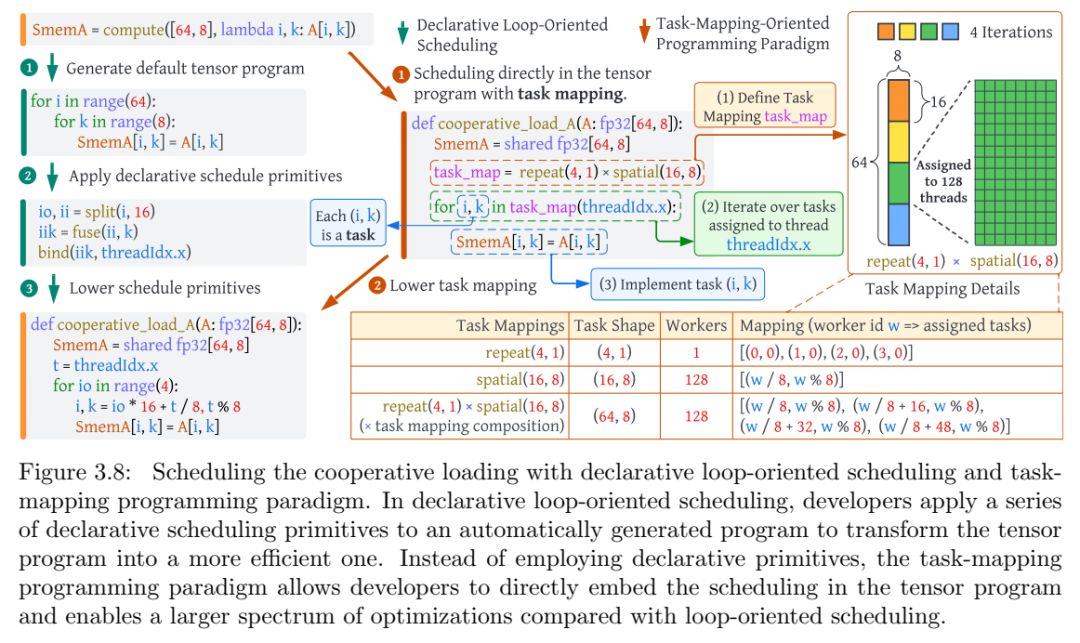
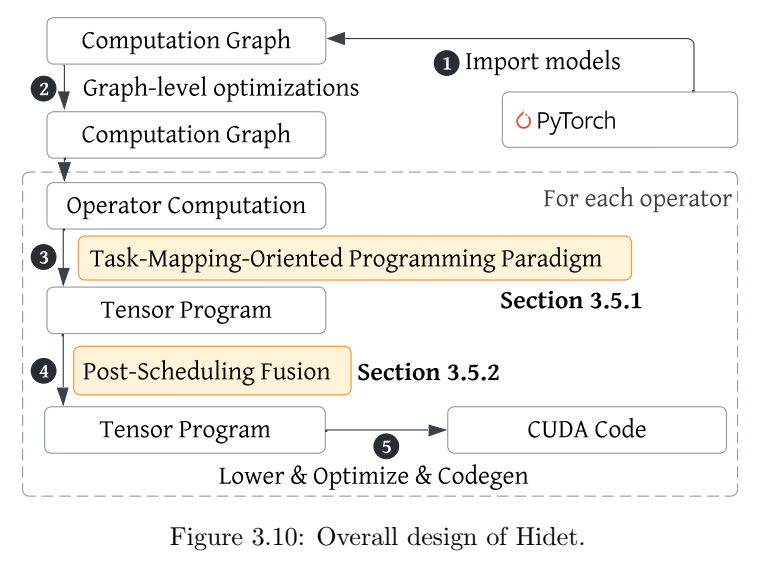
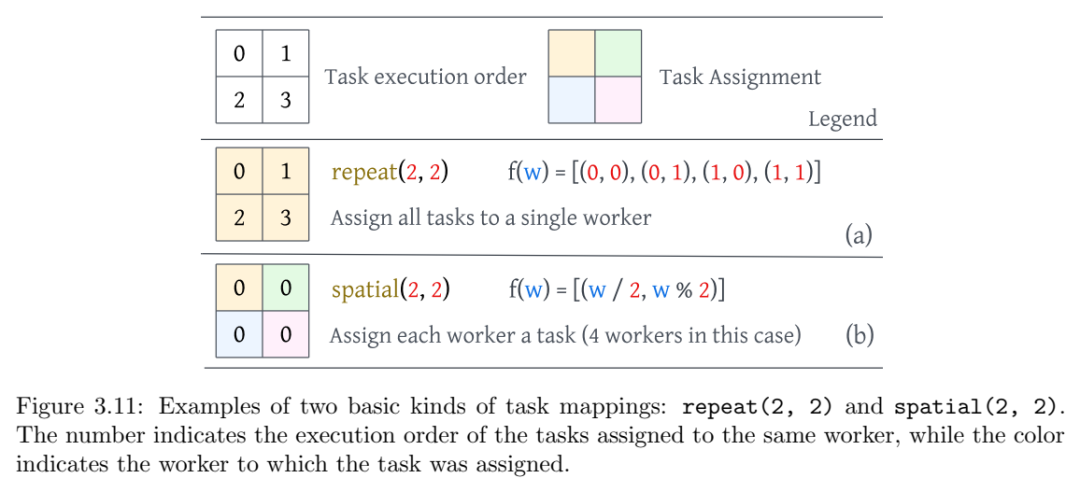
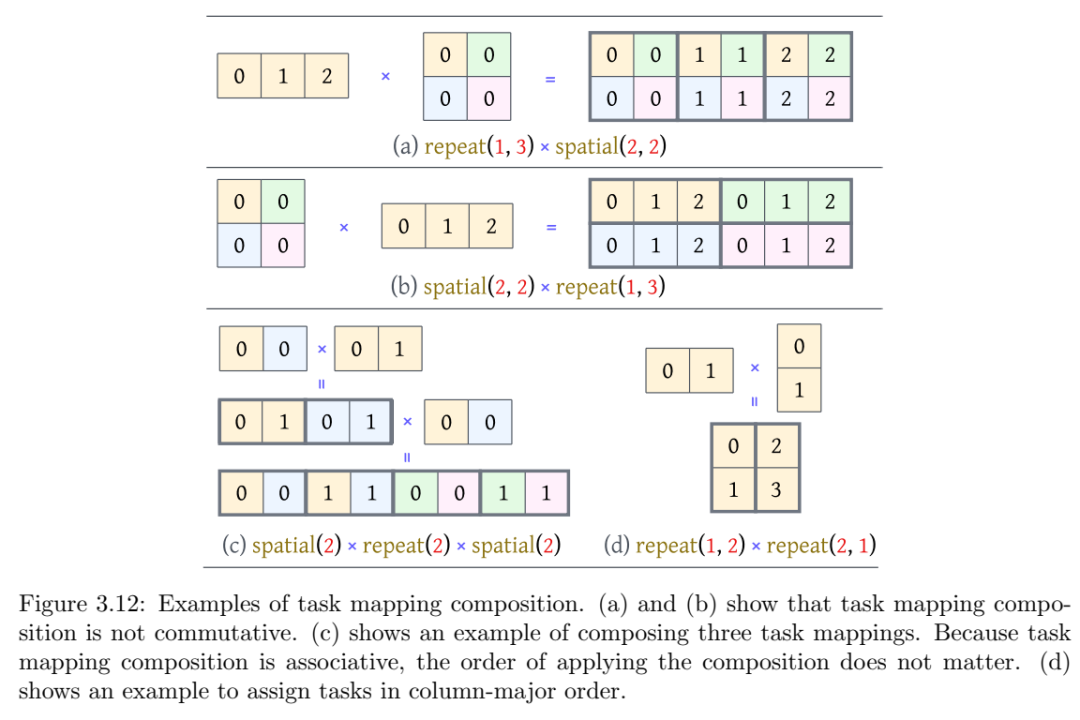
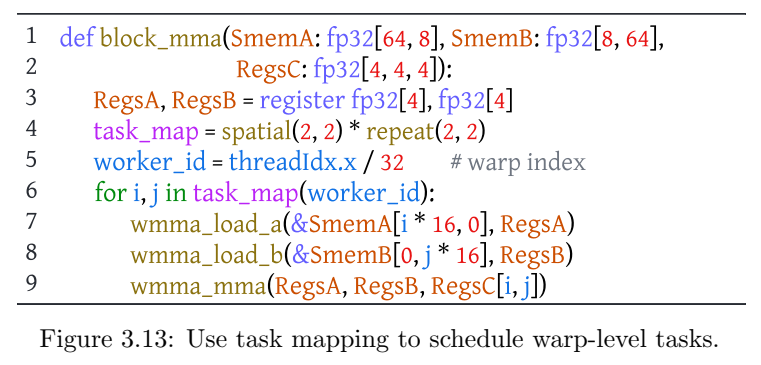
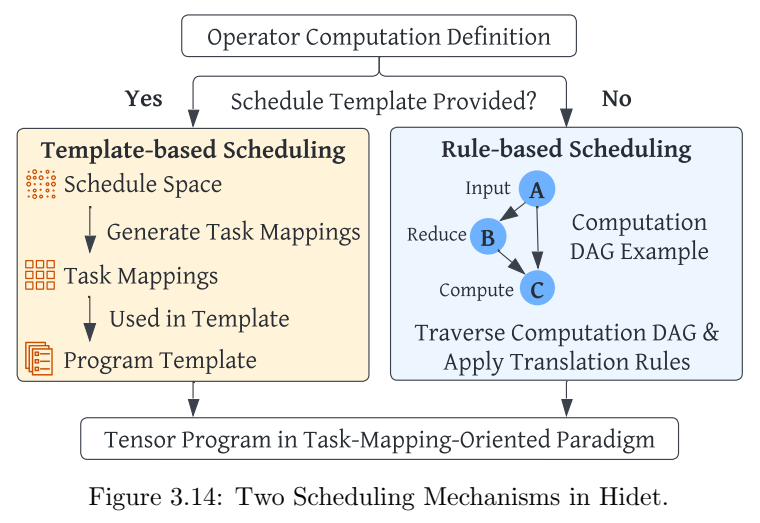
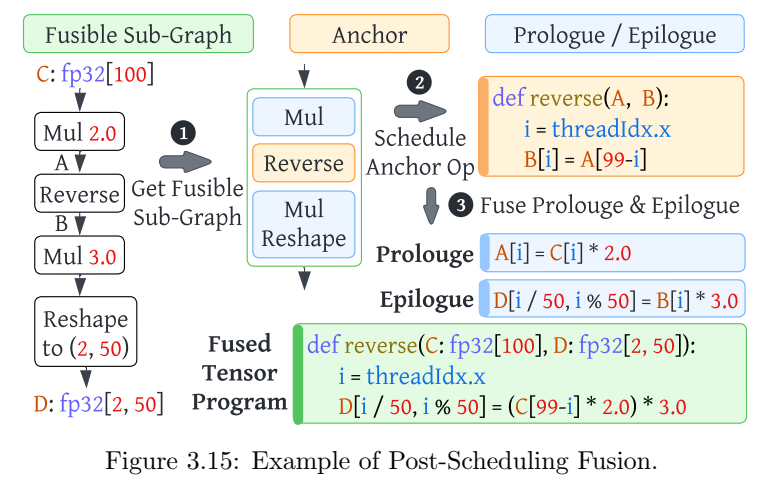
首先,我们提出了 Hidet,一种基于新型任务映射编程范式的深度学习编译器。与声明式的循环调度不同,任务映射允许开发者直接定义计算如何在 GPU 执行单元之间分配,从而能够简洁地表达诸如软件流水线等复杂的优化。Hidet 的性能比目前最先进的深度学习编译器高出 1.48 倍,同时内核调优时间缩短了 20 倍。
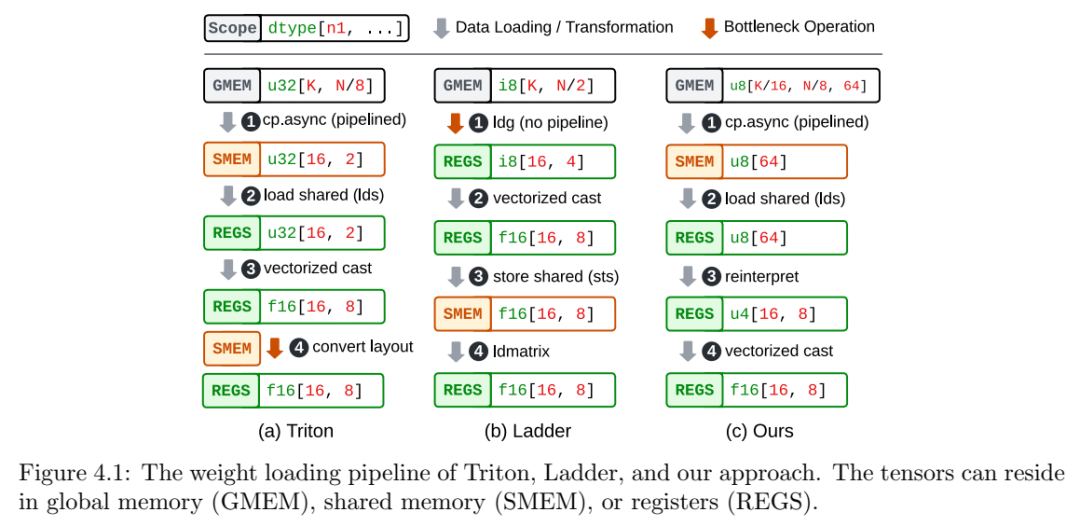
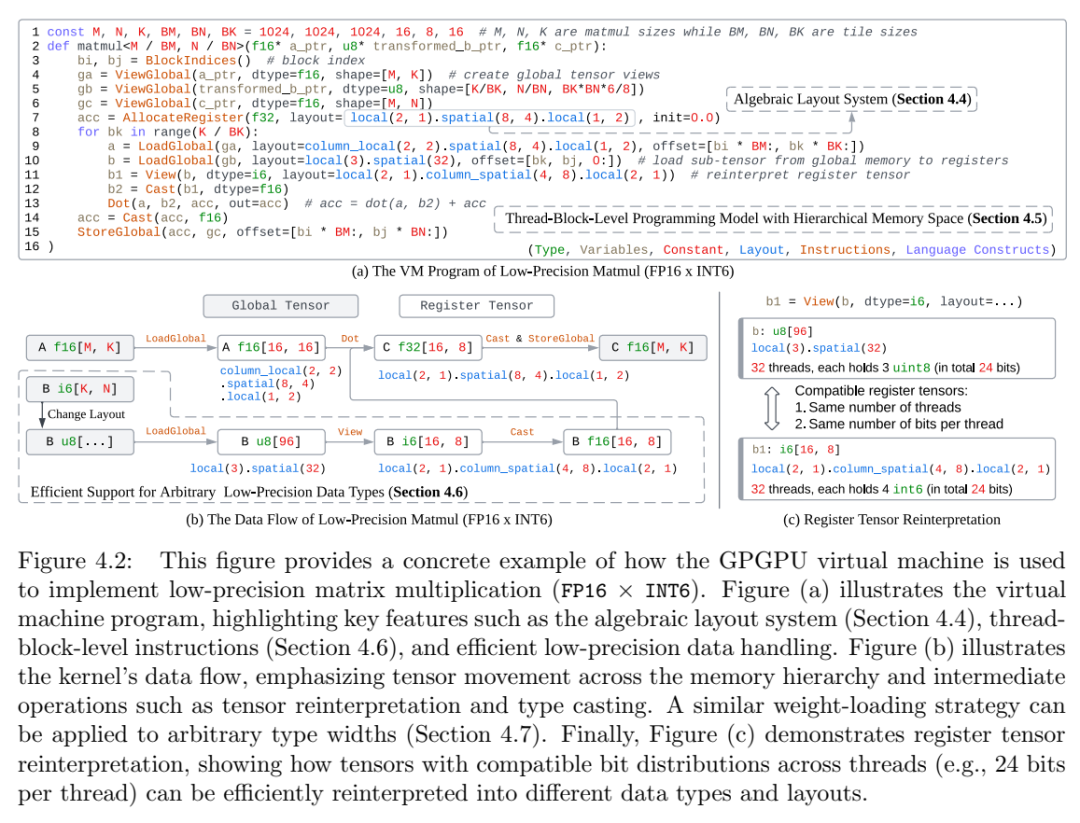
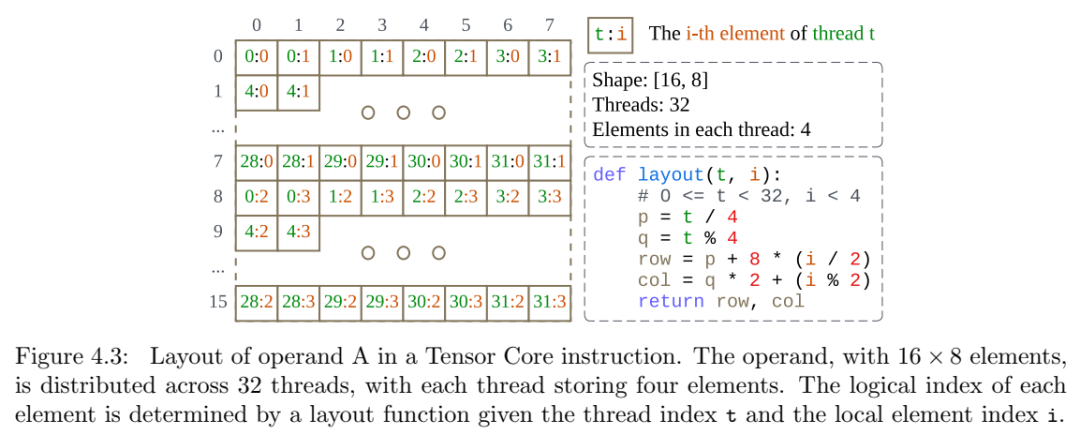
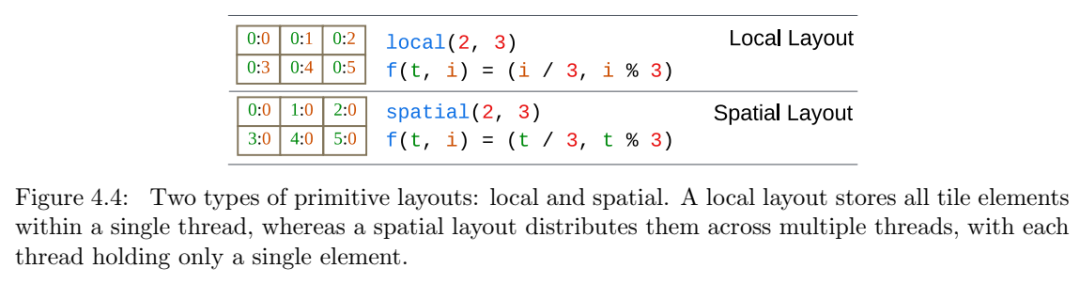
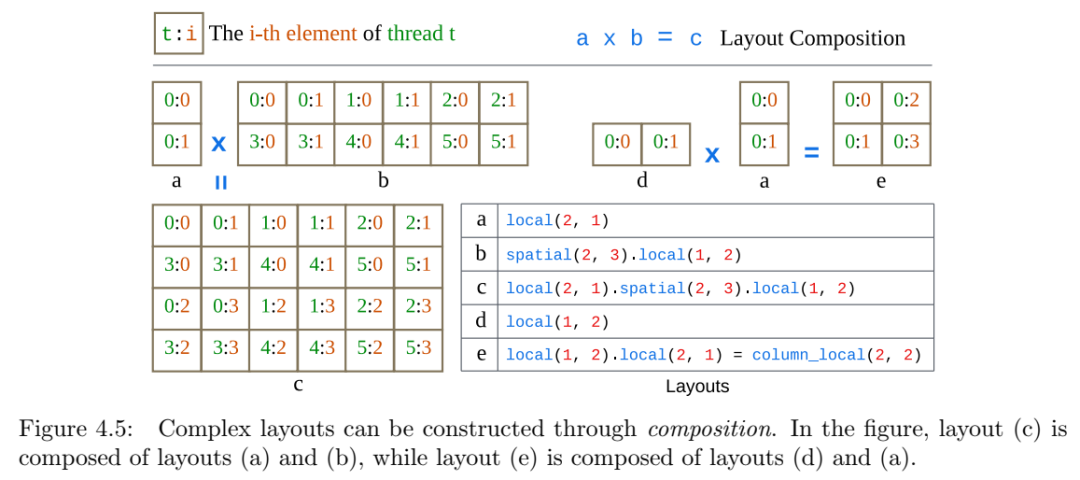
其次,我们引入了 Tilus,一种显式暴露 GPU 内存层次结构和张量图块布局的图块级编程模型。Tilus 通过提供线程块级抽象以及用于灵活数据重解释的代数布局系统,弥合了 Triton 等基于图块的语言的简洁性与实现最佳性能所需的细粒度控制之间的差距。Tilus 在矩阵乘法工作负载上的性能与厂商优化的库(例如 cuBLAS)相当,同时显著简化了内核开发。
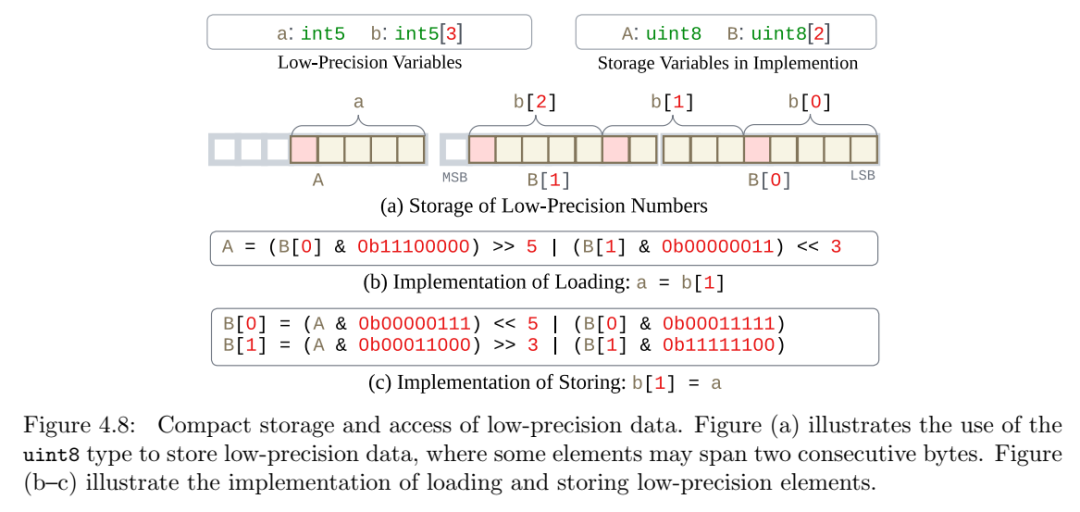
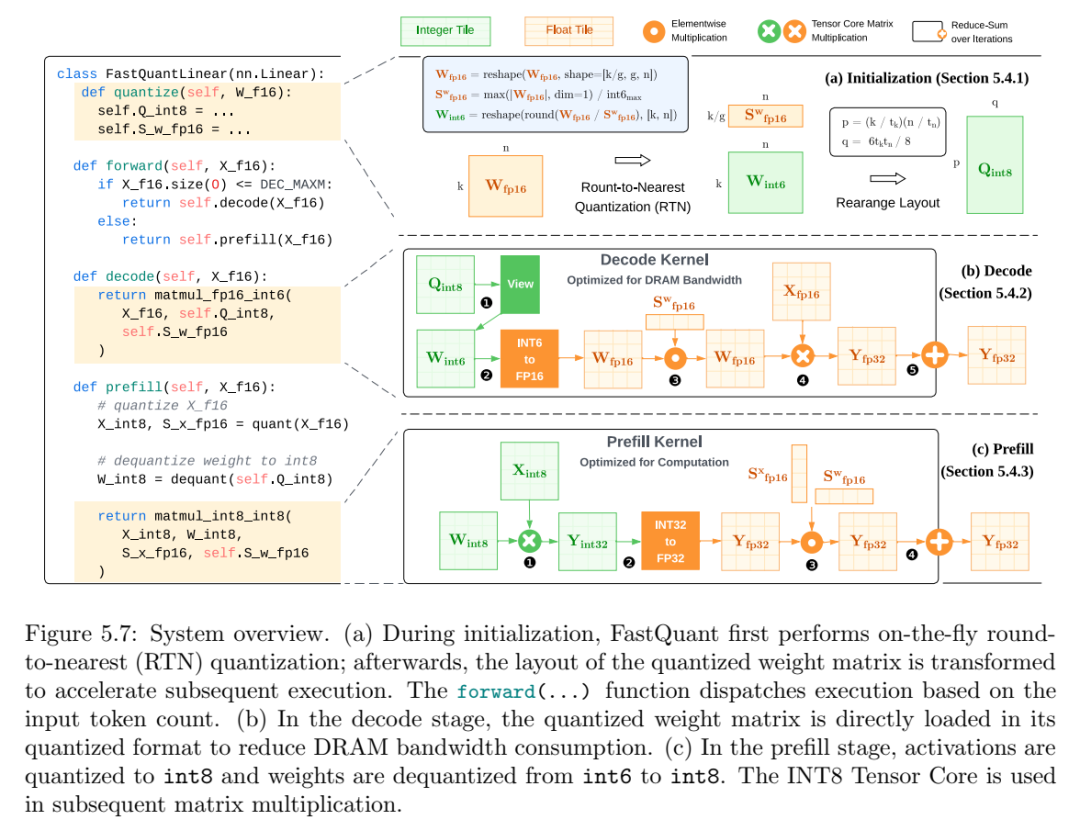
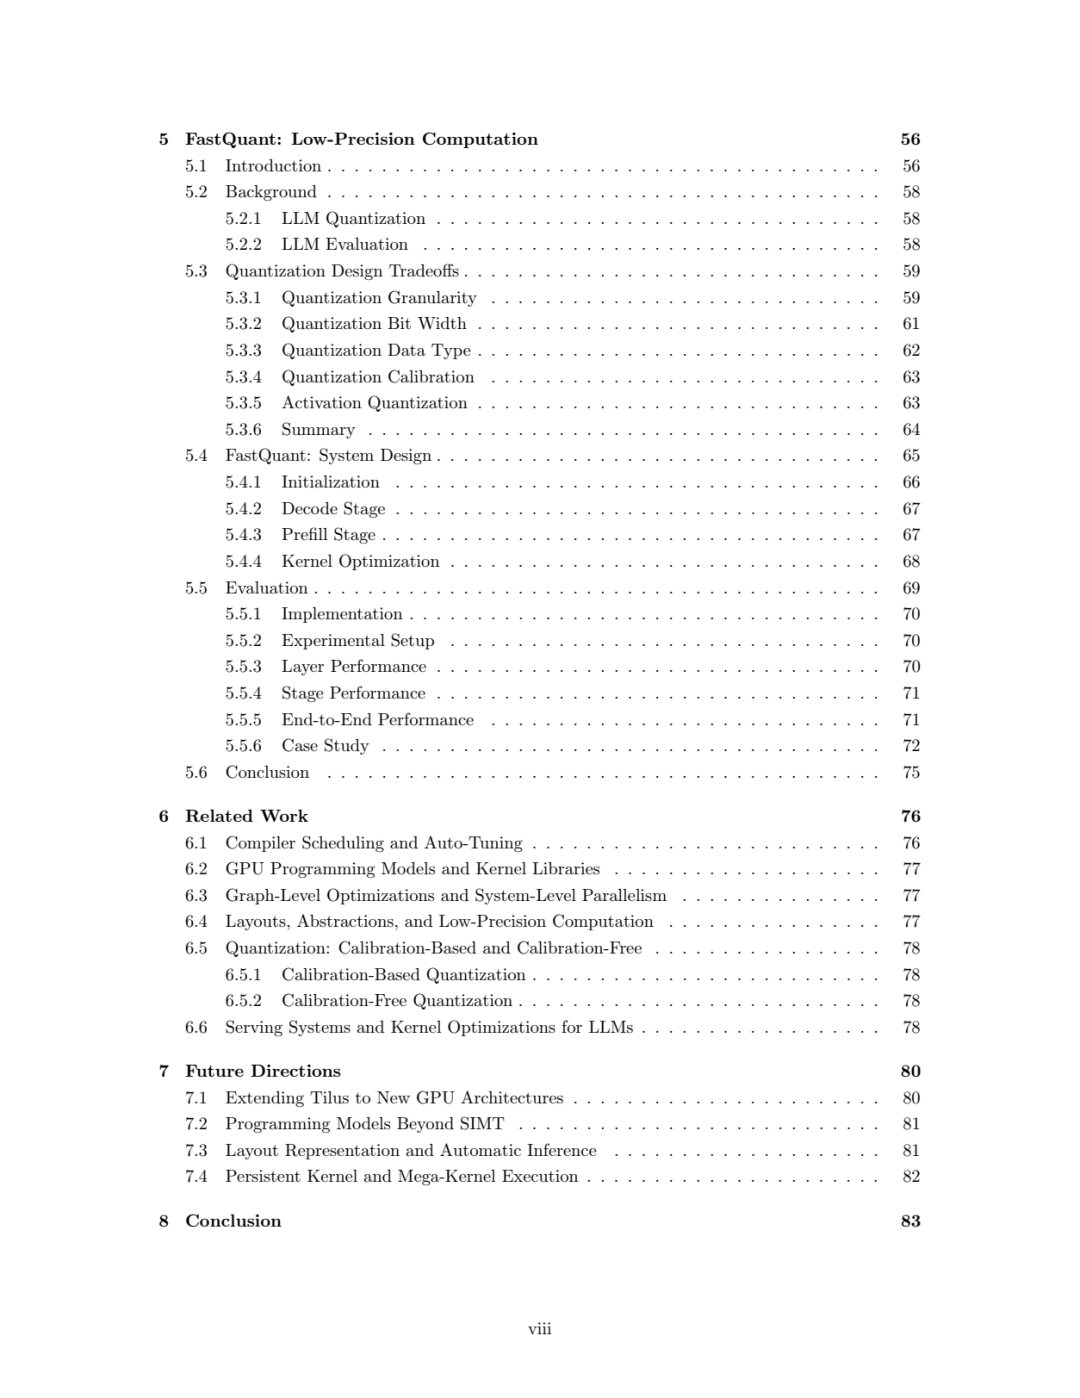
第三,我们提出了 FastQuant,它扩展了 Tilus 的功能,支持权重和激活值的量化,从而能够利用低精度张量核心实现更高的吞吐量。通过对一系列位宽进行系统评估,我们证明了 5 位免校准量化比目前最先进的 4 位校准方法具有更好的模型质量,而 6 位量化在速度提升 1.35 倍的情况下达到了 8 位量化的质量水平,有效地将免校准量化的位宽从 8 位降低到 6 位,且没有牺牲精度。
这三个系统相互依存:Tilus 通过分块级抽象扩展了 Hidet 的编译基础架构,而 FastQuant 则利用 Tilus 的布局系统来实现低精度支持。总而言之,它们通过提供更具表现力和可编程性的 GPU 编程模型,在不牺牲性能的前提下,推进了张量编译的最新技术。
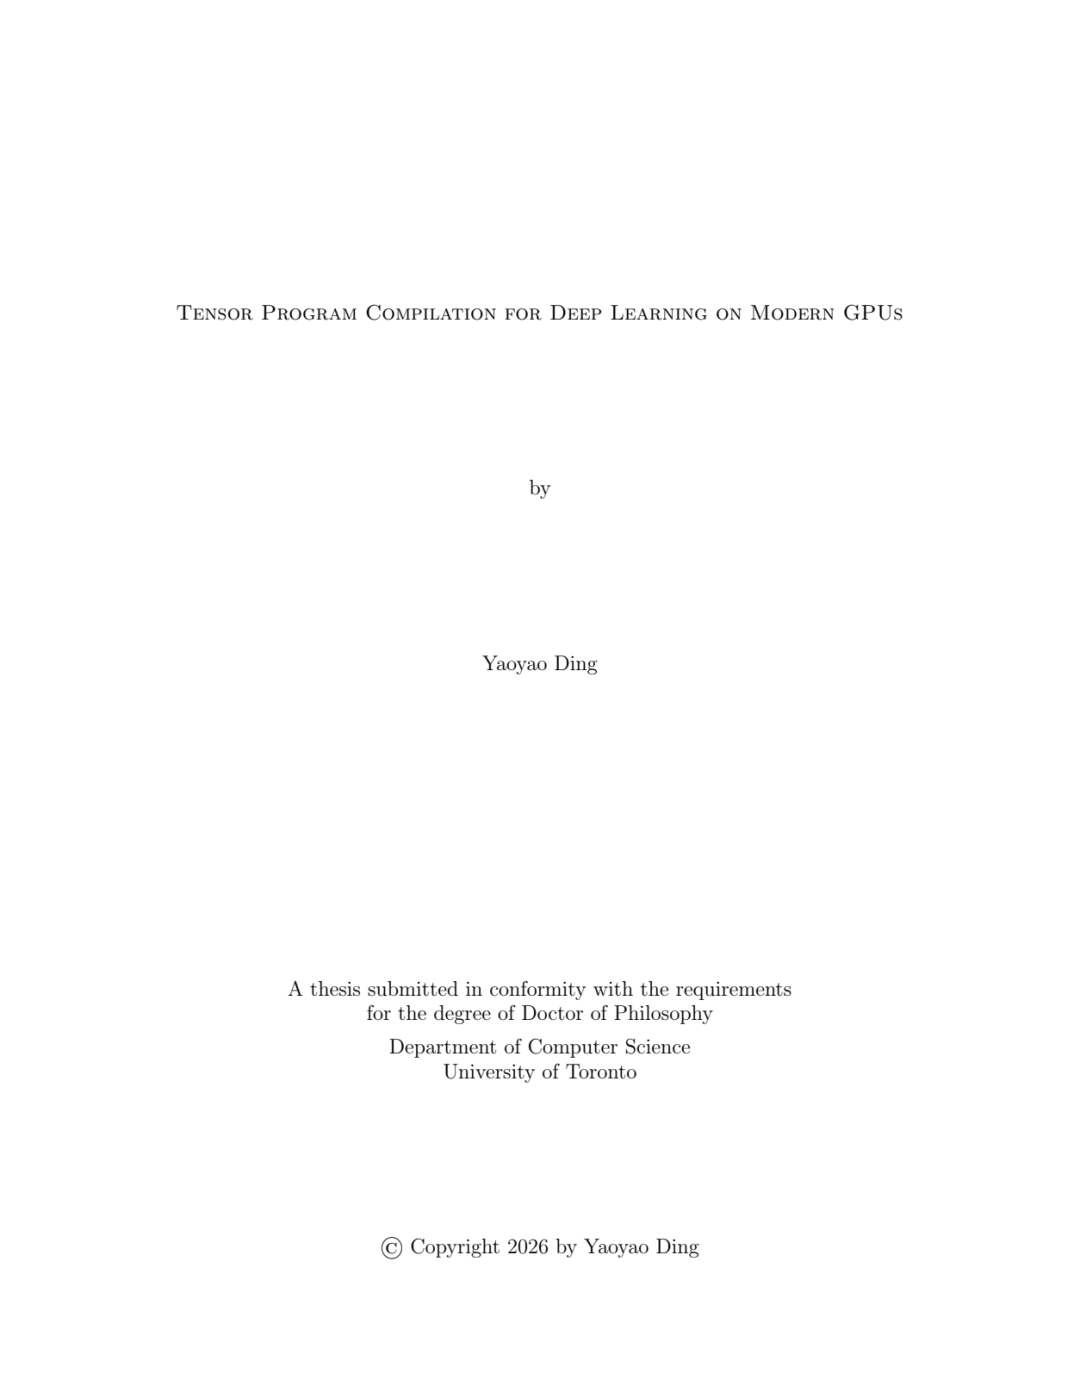
论文题目:Tensor Program Compilation for Deep Learning on Modern GPUs
作者:Ding Yaoyao
类型:2026年博士论文
学校:University of Toronto(加拿大多伦多大学)
请索引第160篇博士论文
 |  |

内容中包含的图片若涉及版权问题,请及时与我们联系删除
评论
沙发等你来抢