

点击蓝字
关注我们
姚期智
图灵奖得主、中国科学院院士、清华大学人工智能学院院长、人工智能国际治理研究院学术委员会主席
I-AIIG
部分内容转载自“清华大学交叉信息研究院”公众号
如果让AI只掌握牛顿提出万有引力之前的知识,它能独立发现万有引力吗?
面对一个陌生世界,AI能否从观察和实验出发,凝炼出基本理论框架,再基于这个理论框架理解这个世界?
这是上海期智研究院院长、清华大学交叉信息研究院院长姚期智和研究院PI、清华大学交叉信息研究院副教授袁洋指导的科研团队在代数世界模型(AWM)研究中提出的核心问题。而同时,姚期智团队又与月之暗面创始人杨植麟等人联手,用一张理论计算机科学的“考卷”检验了9个前沿大模型—结果发现,大模型在某些具体数学构造上,已经超过了人类目前公开的最好结果。看似方向不同的研究,指向的却是同一个命题:AI正在从“探索现象”走向“证明结构”,从“刷题”走向“做研究”。
从“第谷的实验记录本”到“牛顿的万有引力”
从一个简单的小游戏说起,ARC-AGI-3是前沿大模型纷纷公布成绩的交互式游戏集,每个游戏既不告诉你规则,也不告诉你目标。玩家需要自己探索:哪些东西可以移动,机关如何触发,怎样才算获胜。每个游戏,都像一个等待理解的迷你世界。
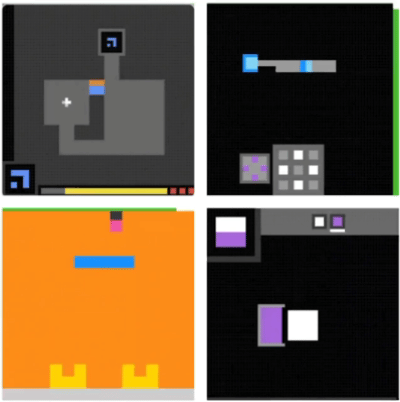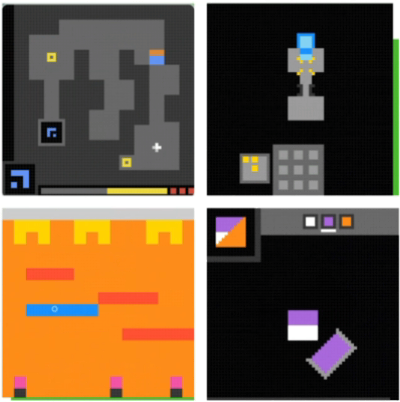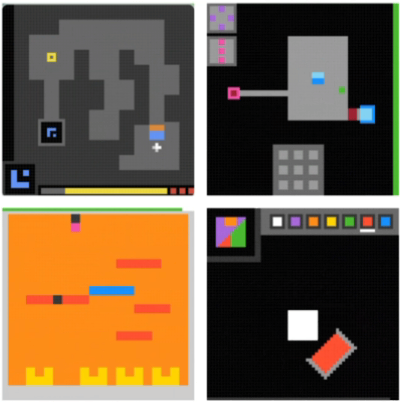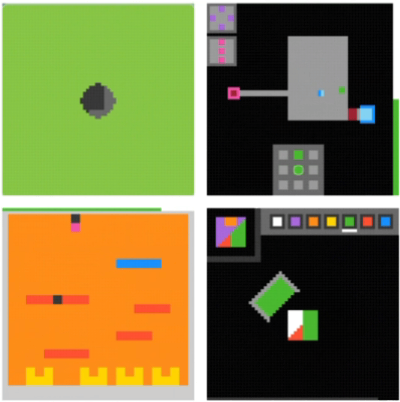
GPT Astra配合Provider Adapter框架,可以在这项评测中取得99.9%的得分。在它玩这个游戏的过程中,会把游戏机制整理成符号化的规则,信息密度很高,但各条规则之间缺少统一的结构。例如,arcprize.org的官方博客提到,Astra会生成如下的规则,描绘游戏状态、多步骤计划、控制、时间、位置等等:
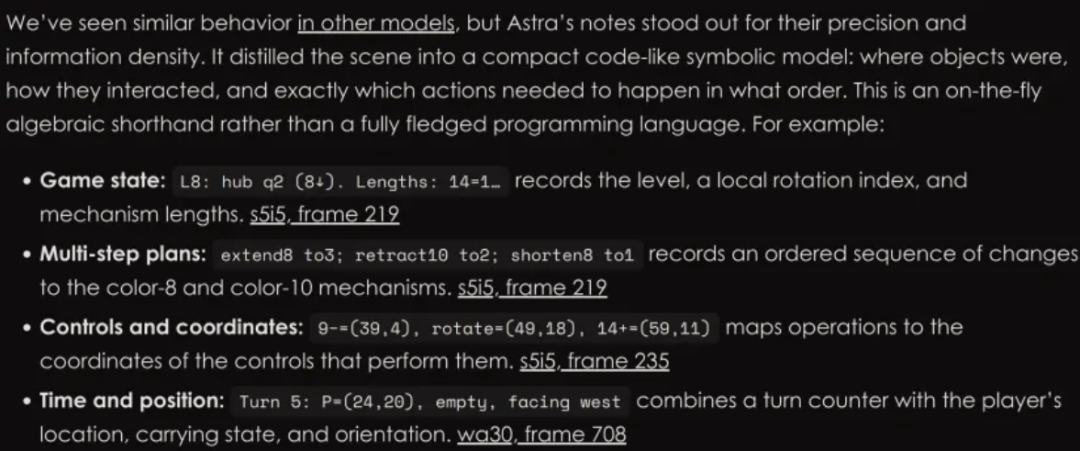
Astra生成的规则,虽然杂乱,但是比其他模型要更精确、信息密度更大
Astra在这些规则的帮助下,已经可以达到几乎完美的成绩。但是,这些规则就像是第谷的实验记录本,只给出了实验现象,却没有描述游戏世界运行的本质规律。
当游戏难度稍稍提高时,Astra就开始力不从心了。例如,我们把ARC-AGI-3中的sc25游戏中第4关和第5关调整了一下内容,并把游戏初始步数设置成了18和35步,变成了无解关卡。以第4关为例,玩家初始步数必须要19步才能获胜,18步是不行的。
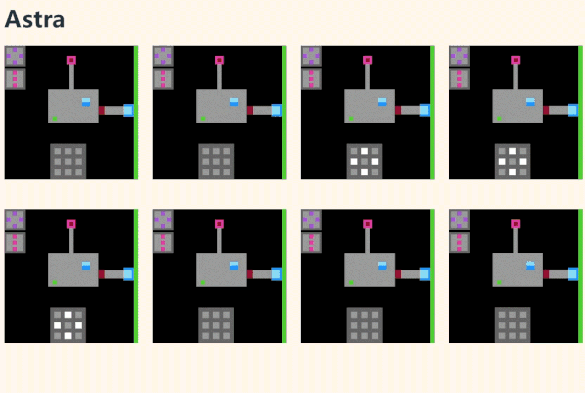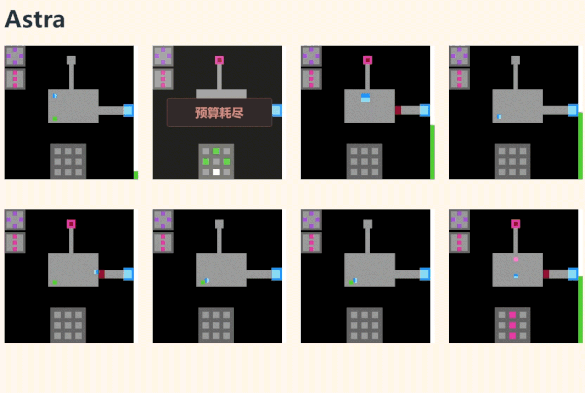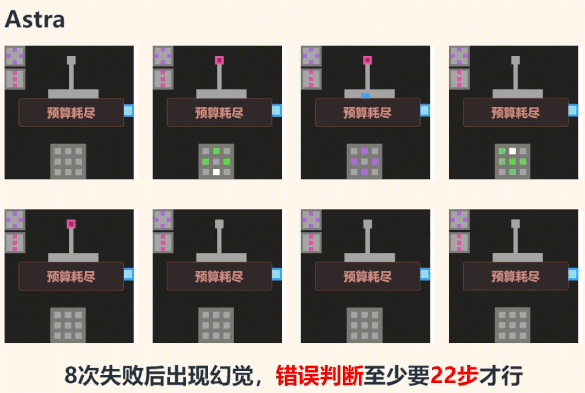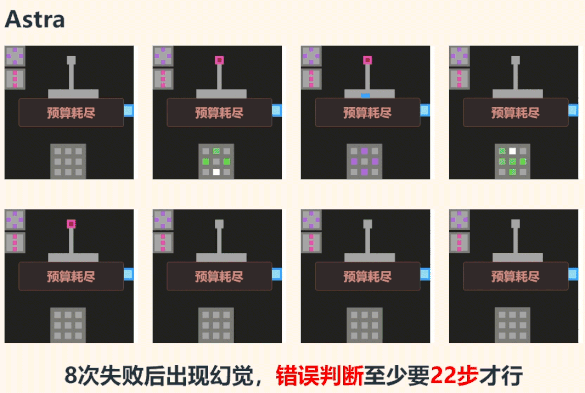
我们让Astra尝试玩这个游戏,并且让它发现游戏不能获胜时给出自己的判断。面对被调整为无解的关卡,Astra尝试了8轮之后,有些沮丧,断言18步无法获胜,并且认为取胜至少需要22步。如果我们相信它,玩这个游戏的时候,预算给到19、20、21步时也会错误地放弃。而这并不是个例。两个基线模型(GPT-6 Astra 和 Claude Opus 5.5)共 12 次运行,只有 5 次判断出“不可能”,其中 4 次给出的最低成本是错的;唯一算对的那一次,也坦白自己没有验证路径是不是最短。
这里模型给出的错误判断,其实就是我们常说的模型幻觉。在现实生活中,如果我们让智能体完成任务,这样的幻觉可能会带来非常严重的后果。作为用户,我们希望AI在任务不可能的时候能告诉我们为什么不可能,同时也能给出准确的判断,当条件发生什么变化的时候,任务才变得可能。
为了实现这一目标,单凭模型的直觉是不行的,我们需要借助代数的力量,也就是代数世界模型(Algebraic World Model, AWM)。当游戏中的对象、关系和规则被抽象为一个代数世界,AWM就可以利用大模型超强的数学能力获得超强能力。具体来说,AWM先探索游戏,把看到的现象写成可执行的Python假设/规律,并不断用新的观察检验、修正它们;然后把规律凝炼成类型化的对象和共享规则;最后形式化成Lean 4,变成假设明确、逻辑严密、可由机器核验的断言。
这一“从探索中发现规律,从规律中凝炼结构,再借助数学理解结构”的路径,恰恰也是TCS研究者的日常工作。一个TCS研究者的日常工作大概分四块:证明定理、写求解器搜索实例、构造满足特定性质的数学对象、以及对着那些几百年没人解决的公开猜想死磕。之前的AI评测基准只覆盖其中一块,没有人把四块放在一起考过。这就导致一个问题:我们知道GPT-6能证明定理,也知道它能写代码,但不知道它能不能像一个真正的TCS研究者那样,完整地走完一个研究周期?
上海期智研究院、清华大学交叉信息研究院姚期智、袁洋团队,联合月之暗面(Kimi)创始人杨植麟等人首次联手发表论文:《TCSExam:在TCS研究的全范围内评估前沿大型语言模型》。他们给 9 个前沿大模型出了一张名叫TCSExam的理论计算机科学考卷,100 道题,覆盖 TCS 研究的完整链条。所有判分结果都由Lean证明器和可执行检查器给出。
TCSExam完整版有100道专家审核过的任务,分定理证明、求解器工程、构造、开放猜想四条赛道。
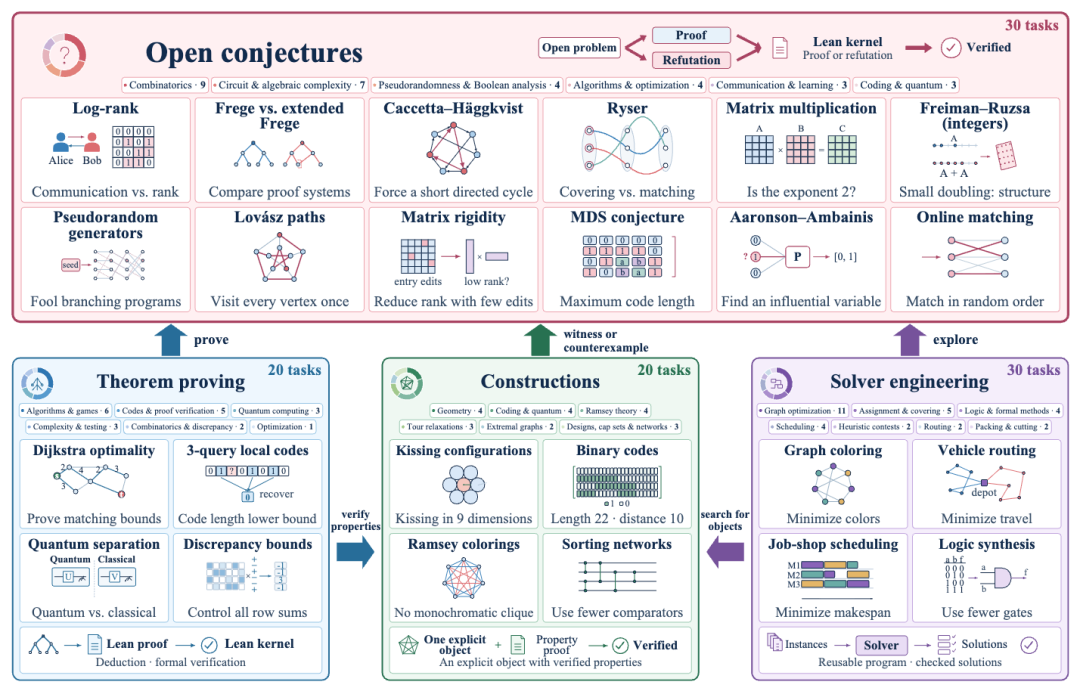
TCSExam各赛道下的任务
结果GPT-6 Astra在bare模式下拿下70%的完成率,意味着20道研究级定理它完整证明了14道,Kimi K3.1 Pro以38.3%排第二,剩下六个模型最高不超过11.7%。
两个研究不约而同地把Lean 4作为“可核验的数学语言”,这绝非偶然。Lean 4提供的不只是一个判分工具,更是一种让AI的结论“承担可检查的理由”的方式。
而面对sc25游戏中第4关和第5关,AWM(基于较弱的Opus 5)只需要尝试两次,就可以对世界有很好的理解,并且可以直接证明,这两个关卡无解,并且只需要再多一步就可以获胜。基于较弱的Opus 5,AWM尝试ARC-AGI-3中所有的25个游戏,183关全部通关,得分是99.9%,同时通关动作数只有人类基线的43%。
构造能力:AI超越人类公开记录的信号
在TCSExam的构造赛道,模型要生成具体的数学对象,比如码、图、几何构型,附带性质证书,GPT-6 Astra平均得分104.9,超过了人类公开参考基线。Kimi K3在测试过程中做出了两个改进:一个是124顶点无三角形图的边数从629推到630,另一个是量子纠错码[[25,7,6]]的最小距离从5提到6。这意味着AI在某些具体数学构造上,已经超过了人类目前公开的最好结果。
而这种“构造”能力,在AWM的框架中同样有清晰的对应。AWM从范畴论中寻找灵感,范畴论里有两个重要工具,叫做投射极限(projective limit)和归纳极限(inductive limit)和归纳极限,它们是数学中构建新对象和新结构的重要工具。基于这两个工具,AWM从探索阶段留下的零散假设出发,不断将其抽象凝炼为概念清晰、关系一致、可以推理的世界模型。换句话说,AWM所做的,正是在陌生世界中“构造”出一个可推演、可检验的代数结构——这与TCSExam构造赛道所考察的“生成满足特定性质的数学对象”,在认知机制上高度同构。
两项研究都没有回避AI的局限,而且它们发现的局限呈现出惊人一致的“不均匀性”。
大模型在TCS上的能力分布极其不均匀。同一个模型,可能在命题定理证明上一道都做不出来,但在构造任务上能改进人类的公开记录:DeepSeek V4.1 Flash 0910就是这样的例子,bare定理证明0分,但构造任务有产出,甚至超越人类已知最优。另一个发现是提示的杠杆效应:Kimi K3在bare模式解决了3道定理,到了guided模式能解决7道,这说明模型其实知道很多证明片段,只是不知道怎么把它们串起来。而30道公开猜想,暂时没有任何一个模型在评测的12小时内独立完整证明或证伪了其中任何一道。
这种“知道片段却串不起来”的困境,与AWM观察到的现象如出一辙。Astra生成的规则虽然杂乱,但比其他模型要更精确、信息密度更大,然而这些规则缺少统一的结构,所以当游戏难度提高时,模型给出的错误判断就是典型的模型幻觉。AWM的解法,正是用范畴论的工具把这些零散假设“串起来”——通过投射极限和归纳极限的四个方向,不断迭代,构建好的世界模型。
从“我成功了”到“让我证明给你看”
两项研究最深刻的共鸣,在于它们重新定义了“AI做数学”的价值标准。哪怕模型没有完整解决公开猜想,它也能产出有数学价值的中间结果。GPT-6 Astra给出了Alon-Jaeger-Tarsi猜想在F₅域下n≤9的形式化验证特例,拓展了人类之前已知的范围。这些特例和边界结果,虽然不能直接解决猜想,但本身就是数学贡献。之前我们评测大模型做数学,要么看定理证明完成率,要么看竞赛题得分。但中间产出同样重要——一个模型可能解不出开放猜想,但它能帮数学家把某个特例验证了,把某个上界改进了,把某个求解器跑通了。这就是实实在在的科研贡献。
这正是AWM所追求的工作方式:让探索留下结构,让结构能够执行,让结果能够被证明,再让证明回到新的实验中接受检验。面对一个陌生环境,AI最终交出的不应只有一条成功轨迹,还应包括一份清晰的世界模型:世界中有哪些对象,动作如何改变世界,目标为什么可以达到,或者为什么一定不可能。为了能够更好地理解真实世界,AWM需要不断地沿着下面的路径循环迭代:
观察 → 假设 → 实验 → 抽象 → 证明 → 再观察
这也是“让AI像牛顿一样思考”的真正含义。它不是让AI模仿某位科学家的语言,而是让AI学会从现象出发,建立能够解释和预测世界的基本结构,并对自己的结论承担可检查的理由。
离真正的AI数学家还有多远?
30道开放猜想,0个独立完整解决。这个数字,本身就很说明问题。今天的大模型已经能做什么?在既有框架内改进已知结果,把已有的证明片段重新拼接,在人类画好的边界里再往前挪一小步。但真正的猜想解决,需要跳出现有框架,提出全新的概念和方法。它需要在黑暗里,自己找到方向。论文里提到一个细节:有两个模型复用了 OpenAI 已公开的 Ryser 猜想和 MIRUP 猜想反例,完成了两道公开猜想任务,但仍然没有模型独立证明。这个结果至少说明,这类公开猜想已经落入模型能力的可触及范围。只要配上更严格的信息隔离,限制对已有答案的检索,它们就能成为更锋利的试金石,真正测出大模型的成色。然而,正如AWM所展示的,从“探索”到“证明”的这条路,本身就已经是一次深刻的范式转变。我们期待的下一代智能体,应该不只会说“我成功了”,还能够说:“这就是我所理解的世界。在这个世界中,目标应该如何到达,或者一定不可能到达 —— 让我证明给你看!”
论文题目:
Algebraic World Model: From Exploration to Proofs
论文链接:
http://arxiv.org/abs/2610.40503
论文题目:
TCSExam: Evaluating Frontier LLMs on the Full Range of TCS Research
论文链接:
https://arxiv.org/pdf/2611.07962

内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢