

单细胞测序让科学家得以在单个细胞的微观分辨率下系统刻画复杂的生物系统,研究基因调控、细胞状态与发育动态。然而,现实中的科研常常面临一个尴尬的瓶颈:虽然单细胞转录组(scRNA-seq)数据相对丰富,但能够同时测量多种分子模态的多组学测序却因成本高昂而极为稀缺,绝大多数研究仍局限于单一的转录组模态。这种持续存在的“模态缺失”现象,严重限制了细胞表征的稳健性。近日,由澳门理工大学魏乐义教授团队和天津大学苏苒教授团队领衔的研究在国际权威学术期刊《自然·通讯》(Nature Communications)上发表了题为《scMomer: a pretraining framework for inferring robust cellular representations from single-cell transcriptomes》的重要成果。研究团队开发了一种三阶段渐进式预训练框架scMomer,成功实现了仅凭单细胞转录组输入,就能推断出具备“多模态觉察能力”的稳健细胞表征。
从“雾里看花”到“洞察全局”:打破单细胞模态限制
在人工智能大模型时代,细胞可以被看作基本的生物信息单元,高维分子特征类似于语言或视觉中的结构化信号。过去,诸如scBERT、scGPT、scFoundation等大模型通过海量转录组数据学习到了通用的单细胞表征。然而,由于转录组主要反映下游的基因表达输出,它错过了由染色质开放性等表观遗传学特征所捕获的上游调控潜力。虽然开发多模态模型是水到渠成的方向,但现实中却面临三大物理与技术壁垒:大规模成对多组学数据极度匮乏、推理时强依赖多模态输入导致无法适应普适的单模态场景、以及染色质开放性元件(CREs)在不同数据集间缺乏统一“词表”。这些严苛的现实约束促使团队思考:能否利用有限的配对数据在训练阶段进行监督,从而在推理时仅凭常见的单细胞转录组输入,就能释放多模态表征的强大威力?
三阶段渐进式预训练:一场巧妙的“知识蒸馏”
为了破解这一难题,scMomer巧妙地设计了三阶段预训练策略。在阶段一中,模型通过自监督的掩码建模,分别在单模态数据集上独立预训练RNA与ATAC编码器,让模型各自掌握基因共表达依赖以及染色质长程开放模式的“语法”。在阶段二中,研究团队将预训练好的编码器在约30万个细胞的胚胎多器官成对多组学图谱数据上进行联合微调与对齐。在阶段三中,研究团队通过跨模态知识蒸馏,冻结了多模态教师模型,训练了一个轻量级的RNA驱动学生网络,让其直接从基因表达输入中去预测和重构由对齐后ATAC编码器生成的染色质感知潜伏特征。通过这一过程,上游的表观调控知识被成功“蒸馏”并注入到了转录组网络中,使模型在实际应用时仅需输入scRNA-seq数据,就能生成兼具转录与表观特征的多模态觉察表征。
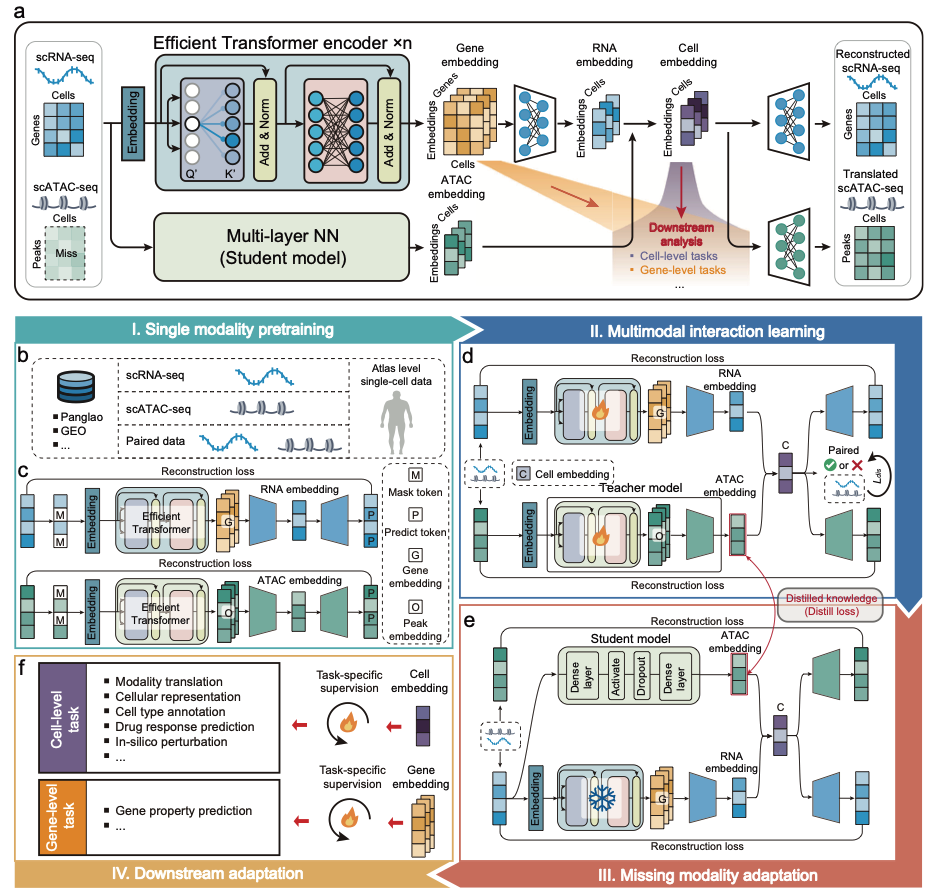
图1. scMomer三阶段预训练和下游适配的框架概述。
下游场景大显身手:从跨模态翻译到多维生物学解析
凭借强大的表征能力,scMomer在跨模态翻译、多样本整合、细胞类型注释、癌症药物响应预测等多个下游任务中展现出强劲的性能。scMomer不仅能高精度预测二值化ATAC谱,其预测的染色质开放性特征还展现出极高的生物学一致性,能精准追踪细胞类型特异性的差异开放峰。在主动脉动脉瘤和心肌病等复杂的疾病队列中,scMomer的零样本嵌入能精准识别稀疏细胞群,并在极端病理和肿瘤微环境中保持极强的鲁棒性。此外,在面对极端细胞不平衡比例,scMomer依然稳健超越现有主流方法;将其嵌入集成至DeepCDR后,在未见药物泛化中同样表现亮眼。
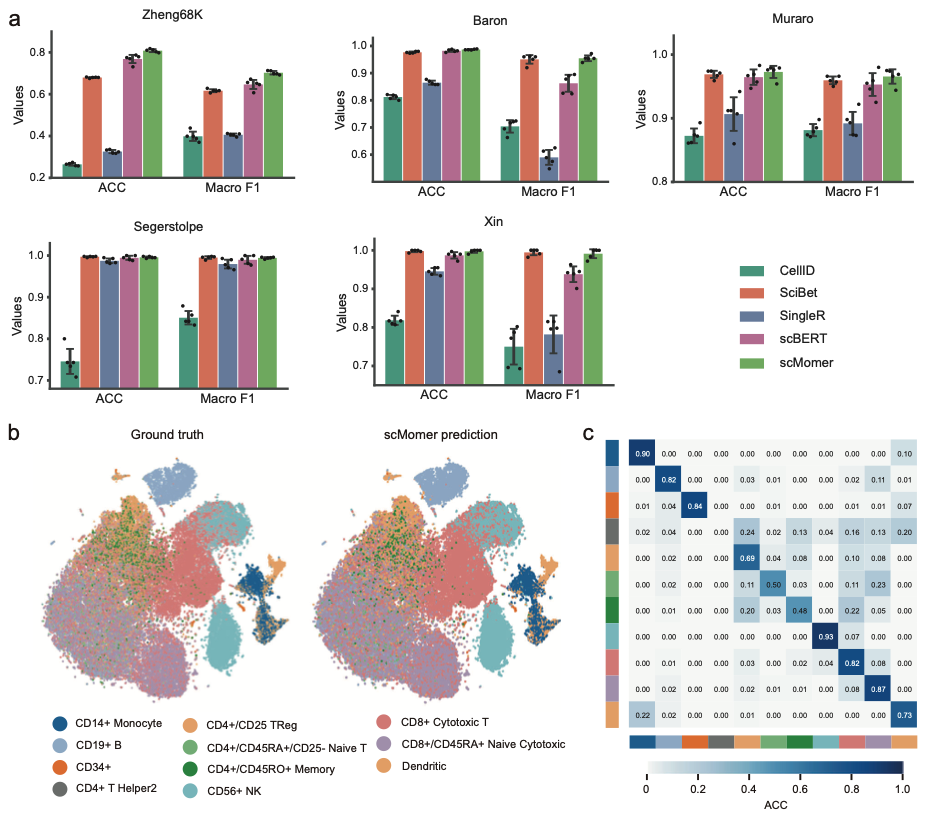
图2. scMomer在下游任务中取得更优性能。
迈向虚拟细胞:开启单细胞人工智能新纪元
scMomer的成功开发,不仅打破了传统单细胞模型“单模态信息受限”与“多模态推理必须依赖配对数据”的双重桎梏,也为“AI for Science”浪潮下的虚拟细胞(Virtual Cell)模拟奠定了关键的表征基础。正如魏乐义教授团队所展望的那样,随着未来表观基因组学统一词表技术的成熟,该框架有望进一步扩展至RNA-蛋白质等多模态及双向通用推理场景。
参考资料
Liu, Y., Zou, Q., Su, R., and Wei, L. scMomer: a pretraining framework for inferring robust cellular representations from single-cell transcriptomes. Nat Commun (2026).
https://doi.org/10.1038/s41467-026-78811-3
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢