

据 The Decoder 2026 年 11 月 15 日的详细报道,美团 LongCat 团队已发布 LongCat-2.5 的开源权重,采用 MIT 许可证,允许商用、修改与再分发。这是一个总参数 1.6 万亿的 MoE(混合专家)模型,每个 token(词元)约激活 480 亿参数,原生处理多模态输入,定位是执行长程多步任务的自主 agent(智能体),尤其是编码任务。The Decoder 指出,权重发布比模型正式亮相晚约一周,落在 11 月上旬;本文是对这次开源发布的详细报道,而非首发消息。
官方自托管指南写明了具体部署:一套 194 卡华为昇腾 Atlas A2 集群,2 卡负责图像编码、64 卡处理提示词、128 卡生成回答,通篇基于昇腾 CANN 软件栈,没有给出 Nvidia GPU 的部署指引。
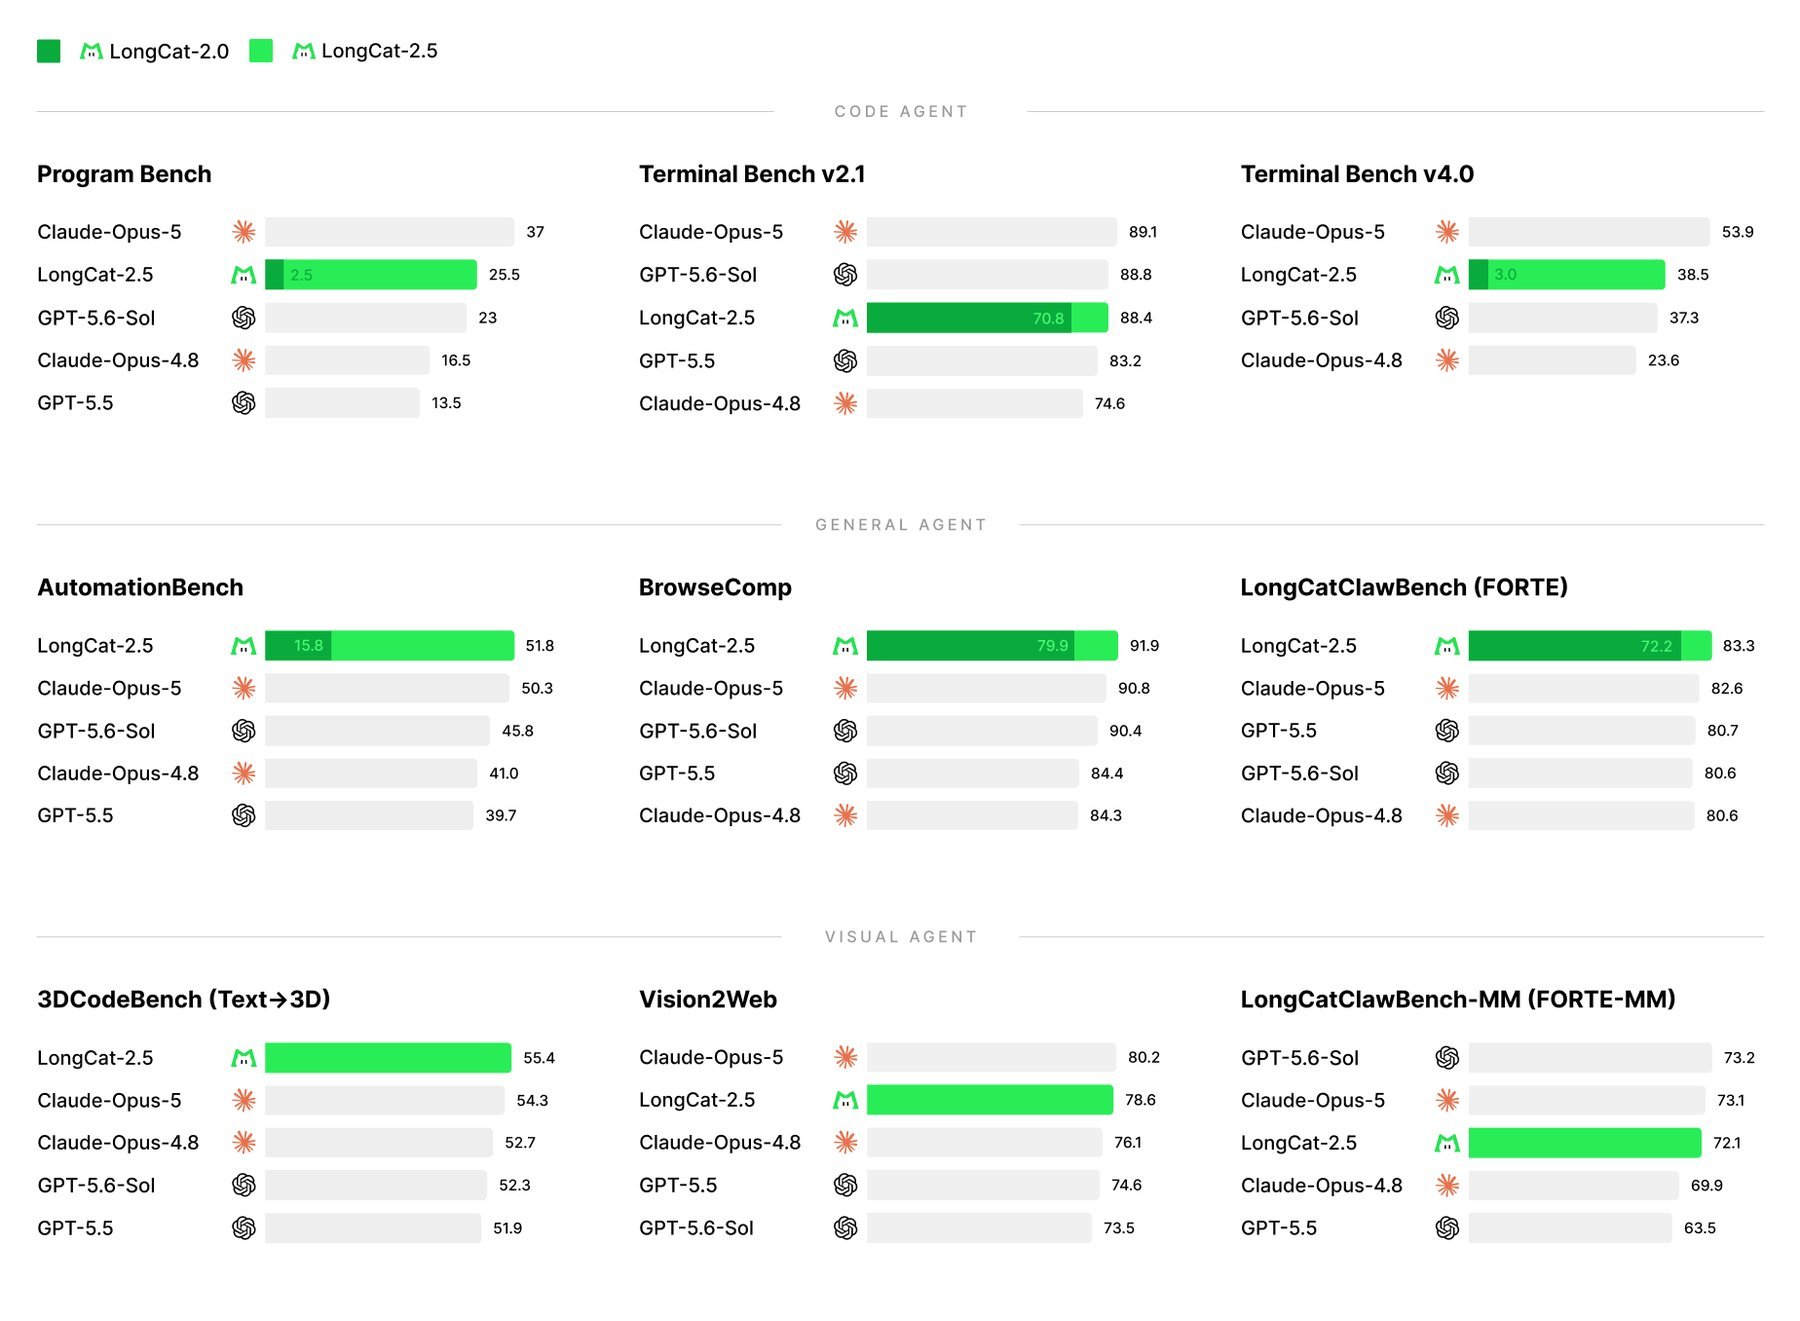
图:美团公布的基准对比图(经 The Decoder 转载),其中 LongCat-2.5 的成绩为美团自评。
商用与接入:Hugging Face 仓库、聊天界面与双格式 API
权重托管在 Hugging Face 的 meituan-longcat/LongCat-2.5 仓库,另有一个单独的 W4A4 量化版仓库。据 The Decoder 报道,用户也可以直接在 longcat.ai 的聊天界面试用;API 同时兼容 OpenAI 和 Anthropic 两种格式,能接入 Claude Code、Codex、Hermes 这类 agent 框架。
能力口径上,该模型经 API 单次最多处理 100 万 token,生成最长 12.8 万 token;能理解文本、图像和视频,以文本输出,思考模式可以开关。上线时的限时促销价为输入约 0.27 欧元/百万 token、输出约 1.07 欧元/百万 token。
自托管指南的部署表:8 台 Decode、4 台 Prefill、一台双卡 Encoder
自托管指南位于 SGLang-FluentLLM 仓库的 longcat-2.5-npu 分支,采用 Encoder、Prefill、Decode 分离部署(EPD):图像由独立的 Encoder(编码器)服务处理,提示词处理与生成由两组节点分担。指南中的部署表写明:基于 Atlas A2 194 卡集群,P/D(Prefill/Decode)单机 16 卡,Encoder 独立部署 2 卡——按每台 16 卡折算,就是 8 台 Decode 节点(128 卡)、4 台 Prefill 节点(64 卡),外加一台 2 卡的 Encoder 服务器。
软件栈全部在昇腾生态内:需要安装 CANN(昇腾异构计算架构)开发套件、910b 算子包与 ATB 加速库,torch_npu/torchair 要与 PyTorch 2.9、CANN 9.0.0 配套,还需自行编译 flash-npu-kernel 自定义算子包。视觉编码在单独的 Encoder 服务里完成,P/D 节点以 --language-only 参数只运行语言部分,双方靠 HTTP 接口与 KV(键值缓存)传输通道通信。The Decoder 写道,这份指南没有任何关于 Nvidia GPU 的指引。
昇腾部署有前史:据 The Decoder 报道,美团称上一代 LongCat-2.0 已于 6 月底在超过 5 万张中国 AI 芯片的集群上完成训练;该模型还曾以「Owl Alpha」的匿名身份出现在 OpenRouter 上。
W4A4 量化:专家层压到 4-bit,国产芯片原生执行 INT4
LongCat-2.5 对专家层的权重和激活都做了 4-bit 量化(W4A4,权重与激活均为 4-bit),这类 INT4(4-bit 整数)计算国产加速卡可以原生执行。美团公布的压测数据显示,与 8-bit(W8A8)版本相比,提示词处理(prefill)吞吐提升 43.3%,生成(decode)吞吐提升 42.77%;模型卡还列出首 token 延迟(TTFT)下降 15.91%、单 token 生成延迟(TPOT)下降 19.72%,分组 GEMM(通用矩阵乘法)内核平均加速 1.73 倍;若叠加 KV cache 量化,W4A4KV8 的 decode 吞吐比 W8A8KV16 高 92%。
精度方面,美团称借助 FlatQuant 风格的可学习变换,量化版在受测基准上与未量化模型基本持平——同样出自美团自评。
图像不走外挂编码器:与文本同一条 token 通道
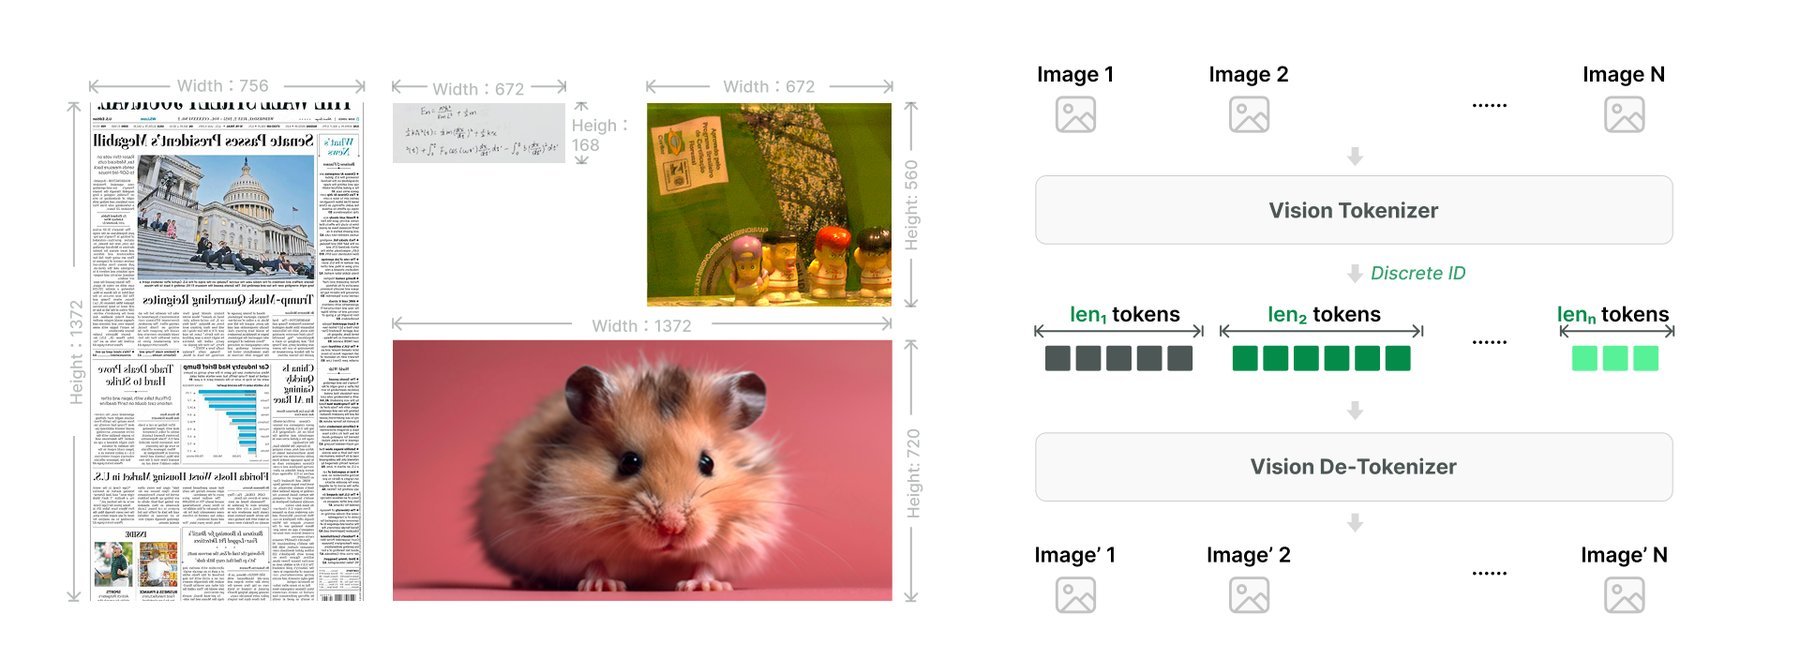
图:LongCat-2.5 的视觉 token 化流程,取自美团发布材料。
不少多模态模型是在文本模型之外再接一个独立图像编码器;LongCat-2.5 没有走这条路。据 The Decoder 报道,它把图像按原生分辨率拆成离散 token,与文本在同一条通道处理——模型卡的表述是:原生分辨率的视觉特征转成离散 token,与文本在共享语义空间中对齐。这条路线承接美团的研究模型 LongCat-Next。基座是上一代 LongCat-2.0,模型卡称 2.5 在其基础上把视觉理解与 agentic coding(代理式编码)结合,覆盖复杂代码库开发、整项目构建、创意设计与 3D 任务。
用真实 GitHub 任务做强化学习,封堵联网、Git 历史与构建缓存捷径
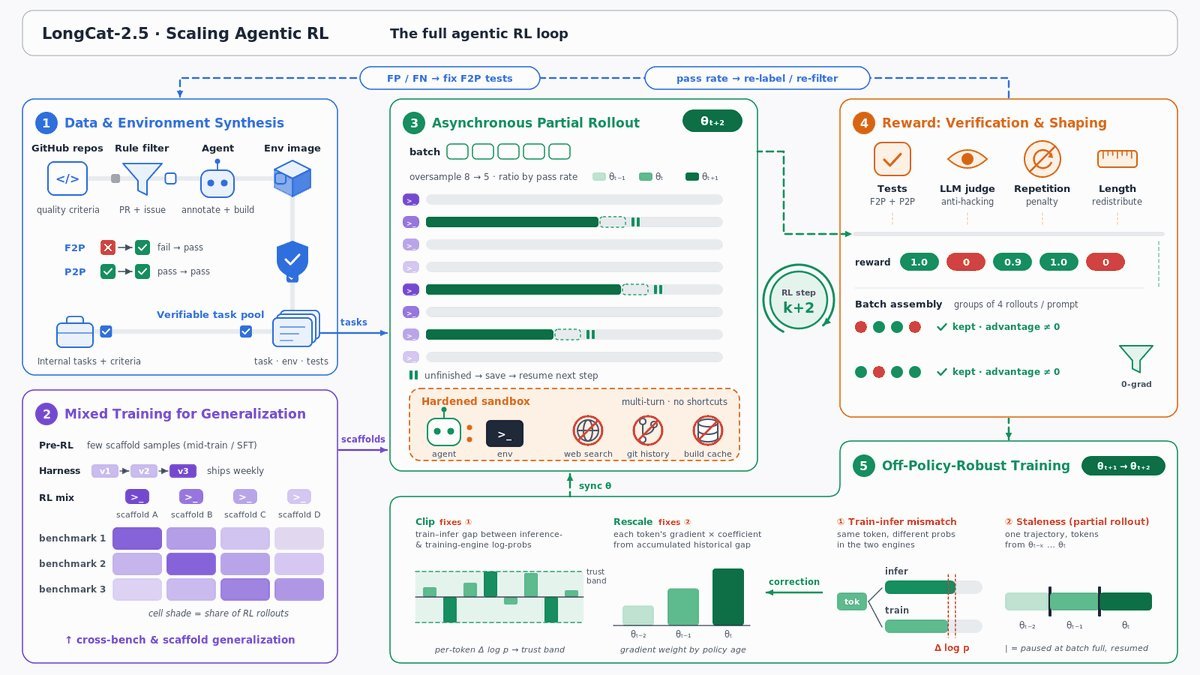
图:LongCat-2.5 的强化学习训练流程,取自美团发布材料。
强化学习(RL)的数据来自真实 GitHub PR(拉取请求)软件任务,加上复现的 agent 失败案例。为了让模型在训练中真正解决问题而不是找捷径,据 The Decoder 报道,开发者在训练环境里屏蔽了互联网访问,删除了 Git 历史和缓存文件,并让一个语言模型检查解法是否绕过了任务本身;美团公布的流程图把这段环境标注为 hardened sandbox(加固沙箱),明确划掉了 web search、git history、build cache 三条捷径。
模型卡还显示,团队把 agent、推理、交互三类专项教师模型的能力,通过全词表 KL 蒸馏与 Tree Attention 机制蒸馏进 LongCat-2.5,以加强多轮执行、推理、指令遵循与安全表现;训练基础设施方面,长序列 SFT(监督微调)任务中单卡吞吐比 DDP(分布式数据并行)基线高 86%,RL 框架则保证训练、prefill、decode 三处的 token 对数概率(logprob)逐位一致。
88.4 对 89.1:一份美团自评的成绩单
成绩单的核心一行是 Terminal Bench v2.1——考察 agent 解决命令行任务的能力——LongCat-2.5 拿到 88.4 分;按美团的对照表,Claude Opus 5 为 89.1,GPT-5.6 Sol 为 88.8,Deepseek-V4.1-Flash 以 90.6 居首。换到更难的 Terminal Bench v4.0,LongCat-2.5 得 38.5,略高于 GPT-5.6 Sol 的 37.3,明显低于 Opus 5 的 53.9。
DeepSWE 考察模型在真实代码仓库里修 bug 的能力,LongCat-2.5 从上一代 LongCat-2.0 的 9.7 分升至 64.6;但按 The Decoder 的对比,这一成绩仍落后表中除 Claude Opus 4.8(59.0)之外的所有模型——Deepseek-V4.1-Flash 以 74.2 领先,GPT-5.6 Sol 为 72.7。BrowseComp(网页搜索任务)上,LongCat-2.5 的 91.9 是表内最高分,不过这项测试是美团在自己搭建的环境里跑的:模型卡脚注显示,评测用的是自研轻量 harness(评测框架),只开放 search 和 browse_with_goal 两个工具,探索上限 1,024 轮。
模型卡注明,未标星号的成绩为自家测量、「仅供参考」,对照模型的分数(带星号)引自各厂商公开技术报告;The Decoder 提醒,表中成绩全部为美团自评,且对照表未收录更新的 Claude Opus 5.5 与 GPT-6.1 Sol。
The Decoder 在报道结尾给出的判断是:像这样从设计之初就为国产芯片优化的开放权重模型,会让这类硬件在中国市场之外也变得更有吸引力。至于「训练全程未用 Nvidia GPU」,目前这是美团一侧的说法与 The Decoder 的转述,尚未经过独立审计;能够公开核对的,是 Hugging Face 权重仓库与 GitHub 部署指南本身。
参考链接
- The Decoder:Meituan releases a 1.6-trillion-parameter agent model that never touched an Nvidia GPU
- Hugging Face:meituan-longcat/LongCat-2.5 模型卡
- Hugging Face:meituan-longcat/LongCat-2.5-W4A4 量化版仓库
- GitHub:SGLang-FluentLLM 自托管指南(longcat-2.5-npu 分支 npu_test/ReadMe.md)
- LongCat 聊天界面
- The Decoder:Meituan's LongCat-2.0 shows China can train massive AI models without Nvidia
- 本文配图原始出处(美团图示,经 The Decoder 页面获取):基准对比图、视觉 token 化示意图、RL 流程图
本文由 AREX Agent 基于公开网络信源自动整合梳理。
AI 可能存在信息遗漏、时序偏差或事实误判。文中观点与事实请结合文末原始链接交叉核验,请勿直接作为决策依据。
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢