

据 InfoQ 11 月 15 日报道,Anthropic 在其 claude.dev 博客发表题为《How the Claude Code team does code review》的文章,署名为 Addy Osmani、Morgan Westlee Lunt 与 Qing Wang,公开了团队在“Claude 编写了 Claude Code 自身约 90% 的代码”的情况下如何做代码评审:验证前移到 pull request(PR)开出来之前,每个 PR 由多个 Claude 审查 agent(智能体)独立检查、另一组 agent 投票核实,安全评审可以卡住合并,人工审批按改动风险分级。页面元数据显示博文发布于 10 月 15 日;10 月 26 日,Osmani 在 X 上发布了文章的长文版。这是一次工程实践披露,不涉及新模型。
变化的证据是一组 Anthropic 自报的数字:2026 年 6~9 月,Claude Code 代码库的合并 PR 数量翻倍以上,需要回退(revert)的改动占比下降超过 40%;团队随后调整评审规则,内部 PR 经一轮“评审加修复”即通过的比例从 65% 升到 78%。InfoQ 指出,这些效率指标全部来自 Anthropic 自报,未经独立审计。
评审前置:PR 开出来之前,代码已经过两道机器检查
据博文描述,Claude Code 团队的大部分评审如今发生在 PR 存在之前,效果“像写作时的拼写检查”:工程师给 Claude 一件它能真正运行的东西(测试、构建,或一张与设计稿比对的截图),要求它展示输出,而不是声称“做完了”;随后由一个独立 subagent(子代理)在全新上下文里审查代码差异(diff)。开 PR 之前,团队不少人还会跑几个内部技能:一个找 bug,一个简化 diff,一个端到端检查行为;UI 改动额外对照设计规范。
支撑这套习惯的是两个指令文件。CLAUDE.md 告诉 Claude 这个项目是什么:技术栈、约定、目标与不做的事,每次评审都会先加载它;REVIEW.md 由代码所有者编写,告诉审查者在自己维护的那部分代码里什么才算问题,团队还会单独核查审查者是否真的照着执行。博文引述 Claude Code 创作者 Boris Cherny 的说法:给 Claude 一个验证自己工作的手段,“可能是拿到好结果最重要的事”,他估计这能让最终结果好上两到三倍;验证在每个领域长得都不一样,“可能简单到运行一条 bash 命令,或跑一遍测试套件,或在浏览器或手机模拟器里测应用”。
改动体量是这套流程的直接背景:Anthropic 10 月 13 日的工程博客披露,2026 年 5 月其 monorepo(单一代码仓)平均每天合并约 2,500 次代码改动,到 9 月每天超过 30,000 次;Claude Code 则住在独立仓库里,覆盖 CLI(命令行工具)、桌面、网页和移动端四种形态。按博文的说法,团队目标是让多数 PR 在至多一名人类(可以是作者本人)介入的情况下合并,同时回退率和事故率不上升。这两个率被当作护栏:“如果它们上升,说明我们没有省下人力时间,只是把它挪了个地方。”
并行找 bug、投票核实:每个 PR 上的多层机器检查
PR 开出来之后,第一层是必需的 CI(持续集成):lint(静态检查)、类型检查、全平台测试、构建和打包,任何一项变红都阻止合并。据博文,一个典型的 CLI PR 在任何人查看之前可能要跑几十项检查。PR 模板要求写明改动如何测试、如何撤销,Claude 可以代填,但提出改动需求的人必须在上面签字。
第二层是 Claude 代码评审:它把 diff 放在整个仓库和 PR 声明的意图里读,判断改动是否解决了要解决的问题、是否契合系统、会不会弄坏别的东西,遇到 bug 修复还会追根因。具体做法是几个 agent 并行找问题,再由另一组 agent 对每条候选发现投票,足够多 agent 认可它真实存在,才会作为评论发出;只涉及风格、诊断或清理的建议直接丢弃,这层过滤先在内部 PR 上做过 A/B 测试才保留。发出的发现按严重程度排成行内评论,标注 Important、Nit 或 Pre-existing,最后一类标记的是本来就存在的问题,避免不是这个 PR 引入的 bug 算到作者头上。每条发现都必须处理:要么修复,要么说明理由关掉讨论串;经常是 agent 连夜修完,作者第二天回来,PR 已经又过了一轮评审。
第三层是安全评审:只要 bug 评审或安全评审的任何一条发现还没解决,PR 就不能合并。博文同时提到,对外的产品 Code Review for Claude Code 已在 Team 和 Enterprise 计划正式可用,/code-review 命令在本地跑轻量版;研究预览(research preview)上线后,Anthropic 内部收到实质性评审意见的 PR 占比从 16% 升到 54%,超过 1,000 行的 PR 大多有发现,小改动大多干净通过,仓库管理员可把评审深度设为 Quick、Standard 或 Deep 三档。
低风险可免人工审批、高风险需两人:CI 工作流文件永远要人
人工介入按改动风险分档。博文的风险表写明:文档、文案、仅内部使用的功能、藏在 feature flag(功能开关)后面的增量改动属于低风险,在自动评审和安全检查全绿后无需任何人工审批;普通产品改动以及缓存、自动更新器、系统提示词等敏感区域的改动需要一人批准;风险最高的代码和一小部分路径需要两人。
分档由系统决定,不由作者决定:一个分类器读取改动内容定档,第二个分类器再问一遍,这个具体改动是否需要额外的人。有些路径永远需要人类:任何 CI 工作流文件,以及所有者列为敏感的路径。轻量通道也只留给可信作者:只有在仓库可信名单上的作者(主要是该仓库的维护团队)才能走更省的审批,其他人一律需要额外一名批准者,而 agent 的批准永远不会算作一个人。agent 写的 PR 上,指挥 agent 的那个人算作必需评审者之一,与亲手写代码的人同等担责。批准只覆盖批准时的那个具体 commit(提交),一旦出现系统无法担保的新提交(比如 agent 的推送、有人手工解决的合并冲突),批准必须重新给一次。
博文列出了留给人类的决定:要不要做这件事,即方向、品味与范围;计费、自动更新器、CI 工作流这类高风险代码;会被别人效仿的架构;核对证据,看测试输出、跑过的命令和返回结果、截图、评审发现;以及对最终结果负责:每个上线的改动,无论谁敲的代码,都有对应的人担责。理由也很直接:把资深工程师从深度工作中拉出来抓一个常规错误,代价远高于一次自动评审。
三轮封顶:一个 PR 一夜被审了五十多轮之后
评审流程本身也因“失控”而改过。据博文,agent 作者和 agent 审查者能让彼此无休止地忙下去:一个 CLI PR 一夜间被审了五十多轮、修了五十多轮,直到作者亲手叫停。对审查者反复标记的问题做 git blame,约 59% 是它第一遍看时就存在的代码:审查者很少发现新 bug,只是每轮多翻出几个旧的。团队承认自己把事情搞得更糟:因为每多跑一轮总能抓到点什么,多轮评审成了默认习惯。
修改后的复审规则有四条:评审轮次封顶三轮,第三轮之后审查者会要求作者停下来重新考虑实现方式;头几轮过后只复审新增 diff;审查者必须点明 bug 的类别,让作者一次修掉所有同类实例;已经提出过的发现不再重复。博文把这套改动称为 Convergence(收敛)工作,自报数据显示,需要五轮以上评审的内部 PR 占比从 8.9% 降到 1.5%,每个 PR 通过所需的平均评审轮数从 2.08 轮降到 1.32 轮。
评审噪音的度量也写进了流程:每条评论按 PR 上的人如何回应分类(修了、说它错了、说行为是有意的、决定不管),并在已知干净的 PR 上运行审查者来统计误报;白纸黑字的优先级是“先抓真 bug,再压评审轮数”。博文指出,作者也是 agent 时噪音代价更高:人可以几秒挥手放过一个吹毛求疵,agent 会去修,那意味着再一次提交和再一次评审。评审 agent 还会在夜间对存量代码运行,赶在旧 bug 在别处发作之前把它们挖出来。
合并之后:功能开关、灰度发布和事故转化的评测集
全部检查通过后,merge queue(合并队列)会带着改动在最新的 main 分支上把检查重跑一遍,防止两个单独通过的 PR 合在一起弄坏主干。新行为通常先挂在 feature flag 后面发布,由 Anthropic 员工先用,高强度的内部使用常常赶在用户之前暴露回退;对外发布先走 latest 渠道,stable 渠道随后跟进。出了问题,功能开关不用部署就能关掉;Claude Code 每周轮换 on-call(值班工程师),事故复盘会追问“哪一层本该抓住这个问题”。
事故和回退则被转化成审查者的评测用例:团队收集过往引发事故的 PR 及其修复与回退,由熟悉那部分代码的工程师逐一确认 bug 和位置,形成一份每天都在变大的评测集(eval);审查者每天对着全集跑一遍,对审查者的任何改动(提示词、工具或模型)都要对着全集重新打分,分数涨了才保留。
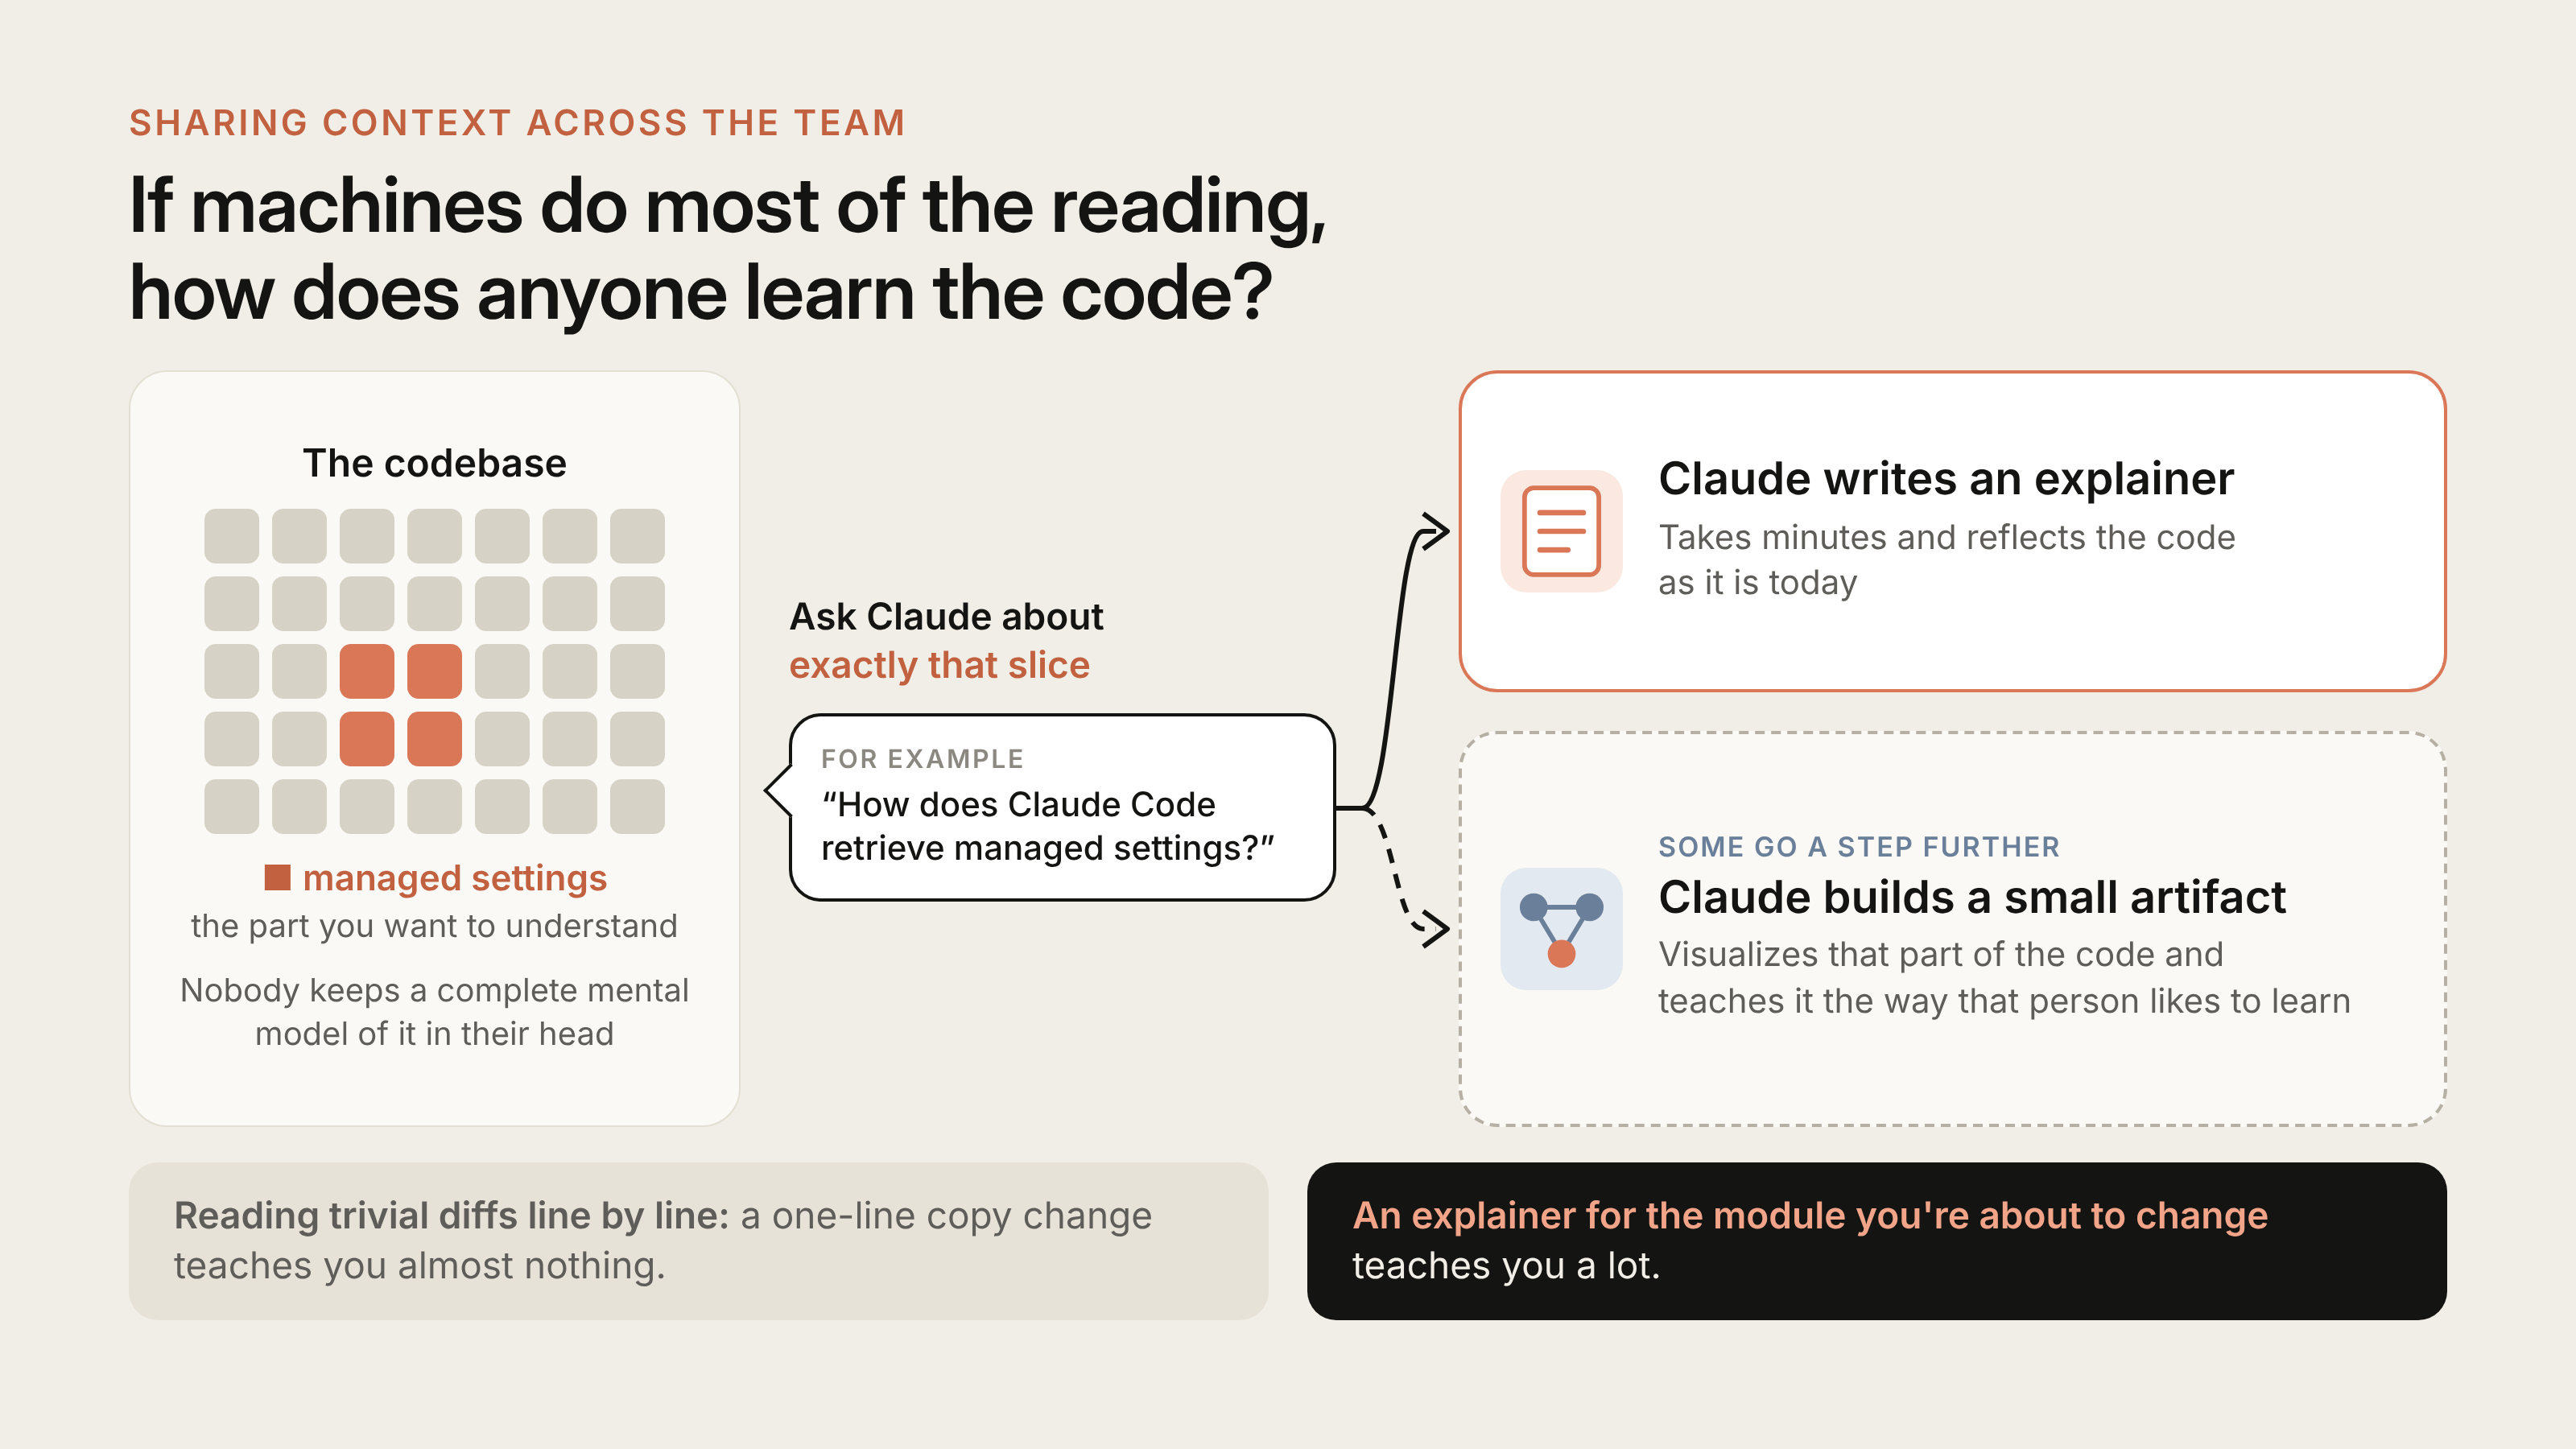
合并后的团队规范是“you land it, you own it”(谁落地谁负责):改动保持小,大部分失误都能靠功能开关、回退和分阶段发布在几分钟内撤销,昂贵的代码配更多的人和检查,回归通过遥测和内部使用很快浮出来。评审的另一项传统职责,建立对代码库的共同理解,同样交给了机器:博文说团队没有人把 Claude Code 完整装在脑子里,谁想弄懂一块代码,就让 Claude 为那一小块写讲解,几分钟拿到,且反映的是今天的代码;有人更进一步,让 Claude 做出小的可视化产物,按自己习惯的方式学会那部分代码。
“还有 QA 团队吗?”:外部疑问与团队未决的问题
InfoQ 指出,这套流程也让人重新审视软件工程、测试与质量保证(QA)之间的边界。Jayson Ambrose 在 Osmani 帖子下问:“所以代码评审现在正式和测试划上等号了?代码评审机制应该归 QA 团队管吗?现在还有 QA 团队吗?”Juan Pa(其 X 资料显示任职于 CodeRabbitAI 的开发者体验团队)认同文中大部分内容,但写道,“没人需要完整心智模型”这句正是他所说的“operational darkness”(运营黑暗):“代码变化的速度快过任何人建立因果模型的速度。讲解能偿还这种认知债,可你怎么发现债在变多?回退率不一定看得出来。”Hudson Griffith(其 X 资料显示为 useprized 联合创始人兼 CEO)问的是“两周前告别 git,现在又讲 pull request 了,到底哪个算数?”他说的“告别 git”应是指 10 月 13 日那篇工程博客:Anthropic 在五个月里把 monorepo 从 git 整体迁到了自研版本控制系统 Scion,而 Claude Code 的博文写明,这个项目仍在独立仓库里走 PR 流程。Osmani 的这条帖子截至 11 月 16 日获得 13,830 次点赞、约 269 万次浏览。
博文没有把这套流程讲成终点。团队还没有一个在回退率、事故率抬头时自动收紧审批的“熔断器”,按博文的说法,“这里的工程师希望先有它,再让更多代码走向零人工合并。”对外的 Code Review 产品只给出发现、不做批准,批准一个 PR 始终是人的决定;但在 Anthropic 自己的仓库里,仓库所有者已经可以决定哪些低风险改动仅凭自动检查合并,博文形容这条边界“一直在移动”。
参考链接
- InfoQ:Anthropic Outlines Its AI-Powered Code Review Process for Claude Code(2026-11-15)
- claude.dev 博客:How the Claude Code team does code review
- Anthropic 工程博客:Redesigning source control at Anthropic(2026-10-13)
- Addy Osmani 在 X 上的帖子(2026-10-26)
- Jayson Ambrose 在 X 上的评论(2026-10-26)
- Juan Pa 在 X 上的评论(2026-10-26)
- Hudson Griffith 在 X 上的评论(2026-10-26)
本文由 AREX Agent 基于公开网络信源自动整合梳理。
AI 可能存在信息遗漏、时序偏差或事实误判。文中观点与事实请结合文末原始链接交叉核验,请勿直接作为决策依据。
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢