

据 MarkTechPost 11 月 15 日的报道,旧金山语音 AI 公司 Bland 于 11 月 13 日在 X 上发布通告,介绍其全双工(full-duplex)speech-to-speech(语音到语音)模型 Tofu-1,企业研究预览(research preview)申请在产品页同步开放。按 Bland 的自述,Tofu-1 在通话中同时听与说、边说话边推理,能将来电者与电视、哭泣的孩子等背景人声区分开;目标场景是行驶中的汽车、医院病房和弱信号线路——用产品页的原话说,「最要紧的电话很少发生在好条件下」。
Bland 用一个名为 TV Test(电视测试)的情境说明风险:客户还没回答客服「是否取消保单」的确认,房间里电视的一句「Yes」就可能被基于转写的代理当成客户的回答。与能力描述并列的是另一组事实:模型闭源、由 Bland 托管,参数量、延迟、基准成绩与定价均未公布;页面上的演示音频由 Bland 生成,TV Test 情境也被 Bland 自己标注为「示意,而非录制的模型输出」。
级联方案先转文字再回答,丢掉的恰恰是「谁在说话」
Bland 在产品页解释了它认为现有系统做不到的事:今天大多数语音代理是级联(cascade)架构——先把语音转成文字,交给语言模型,再把回复转回语音,每一步都会丢掉通话的一部分:谁在说话、这句话在对谁说、说话人有没有迟疑、有没有说完。Tofu-1 改为直接处理音频,声音携带的这些信息对模型保持可用。
产品页用一个场景说明目标:暴雨天,一位女士来电报告大树压到了房产,她站在雨里、信号很差,儿子在一旁不停问她问题,她念地址念到一半停下来回应儿子。Bland 认为人会在不经意间处理好这通电话:听出她转开了注意力、等她回来、忽略雨声,再从断掉的地方接着记地址。
页面配套给出这通电话的逐句分层标注:来电者的三句话、孩子的一句「妈妈?」、客服的一句「慢慢来」,每句都标出受话对象、背景声(雨、雷声)与韵律(急促、压低、仓促)。Bland 把对应的音频能力归纳为三项:说话人区分——分辨说话者、判断每句话在对谁说;噪声分离——把人声从哭泣的孩子、电视、高速车流、医院广播与按键音中分离出来;副语言理解——听出迟疑、沮丧与紧迫。MarkTechPost 补充了两个厂商口径的信息:Bland 未公布模型内部架构;训练数据按其自述为数百万小时真实对话。
TV Test:一句清晰的电视人声,为什么比噪声更难对付
Bland 把电视称作「最难的案例之一」:广告说「立即拨打」,新闻主播在提问,剧中人说「Yes」——每一句都是清楚、可懂的语音,但没有一句是说给电话那头客服的。TV Test 要回答的问题是:模型能否一边跟着来电者,一边忽略属于另一个场景的语音。Bland 认为降噪解决不了它,因为电视声不是噪声,而是来自错误来源的语音,而且往往比来电者更响。
页面给出的示意情境是:客服问「确认一下,您是想取消保单吗?」,客户还在找保单号、没有说话,电视里冒出一句「Yes!」。Bland 写道,基于转写的代理可能把这句当成客户的回答,直接取消保单;Tofu-1 按设计应把这句「Yes」归给电视,再向客户本人确认。
Bland 也写明了判断的依据与边界:音量不能裁决谁在说话——响的电视可能毫不相干,来电者轻轻一句更正可能是整通电话里最重要的话;而如果背景吵到来电者根本听不清,模型应该说明情况、请对方重说或换个安静的地方。「忽略电视绝不能变成猜测来电内容的原因」,产品页这样写。
边说话边干活:两种打断、一个改约,与「没办完不说办完了」
Bland 强调,全双工最难的部分在判断:模型听到的内容要能改变它正在说的话。产品页区分了两种打断:客服念保单号时,一声「嗯嗯」表示继续;一句「不对,是 4 不是 9」表示停下——模型要在话说一半时分辨这两者,还要一边不让电视抢走话头、一边放进来电者轻轻的更正。页面注明,这段时序图是概念示意,分段长度不代表实测延迟。
「边思考边说话」处理的是另一件事:核实来电者身份、查理赔状态、查福利、确认付款这些活儿进行时,通话不能停。麻烦在于活儿没干完、请求可能先变:病人在查询途中更正了预约日期,给出的答案就必须按新日期来。Bland 的原话是:「我正在查」和「你的付款已到账」是两种不同的承诺——Tofu-1 在事情做完之前不说做完了。
页面放出的两段演示音频分别是:一段 10 秒的「嘈杂背景通话」,一名男子从车内来电、乘客在一旁说话;一段 39 秒的「边说话边思考」,客服一边查资料一边保持对话。因为建模的是通话的声音而不只是文字,Bland 表示 Tofu-1 也能反向生成这种声音:第二个说话人、他们所在的空间和线路噪声。
谁能先用上:限额企业名单,面向银行、医疗、保险与政府
预览采取申请制:产品页表单收集工作邮箱、电话和月呼叫量,MarkTechPost 写明选项从每月 1,000 通以下到 50,000 通以上;页面承诺「随着名额释放会邮件通知」。Bland 点名寻找银行、医疗、保险和政府四类处理高险电话的团队,并称 Tofu-1 是其计划中的 speech-to-speech 模型家族的第一个。MarkTechPost 还转述了 Bland 给出的时间点:1 月可用。
通告帖由个人简介标注为「phone operator @usebland」的 Isaiah Granet 发出,截至 11 月 16 日查询已有约 161 万次浏览、近 3,000 次点赞。
竞品公布延迟与参数:Tofu-1 目前只有一个自报的 92%
在公开信息里找不到技术规格。MarkTechPost 明确写道,Tofu-1 未公布参数量、延迟、定价或基准成绩。它的对比表显示,竞品至少公开了部分数字——OpenAI 的 GPT-Live-1 公布 0.798 秒的轮次切换延迟(FDB v1 基准),NVIDIA 的 NemotronLabs VoiceChat 11B 公布 110 亿参数、开放权重与 448 毫秒延迟(FDB 基准);MarkTechPost 同时注明,这些数字来自各家厂商自己的页面,FDB 基准版本不同、不能直接比较。
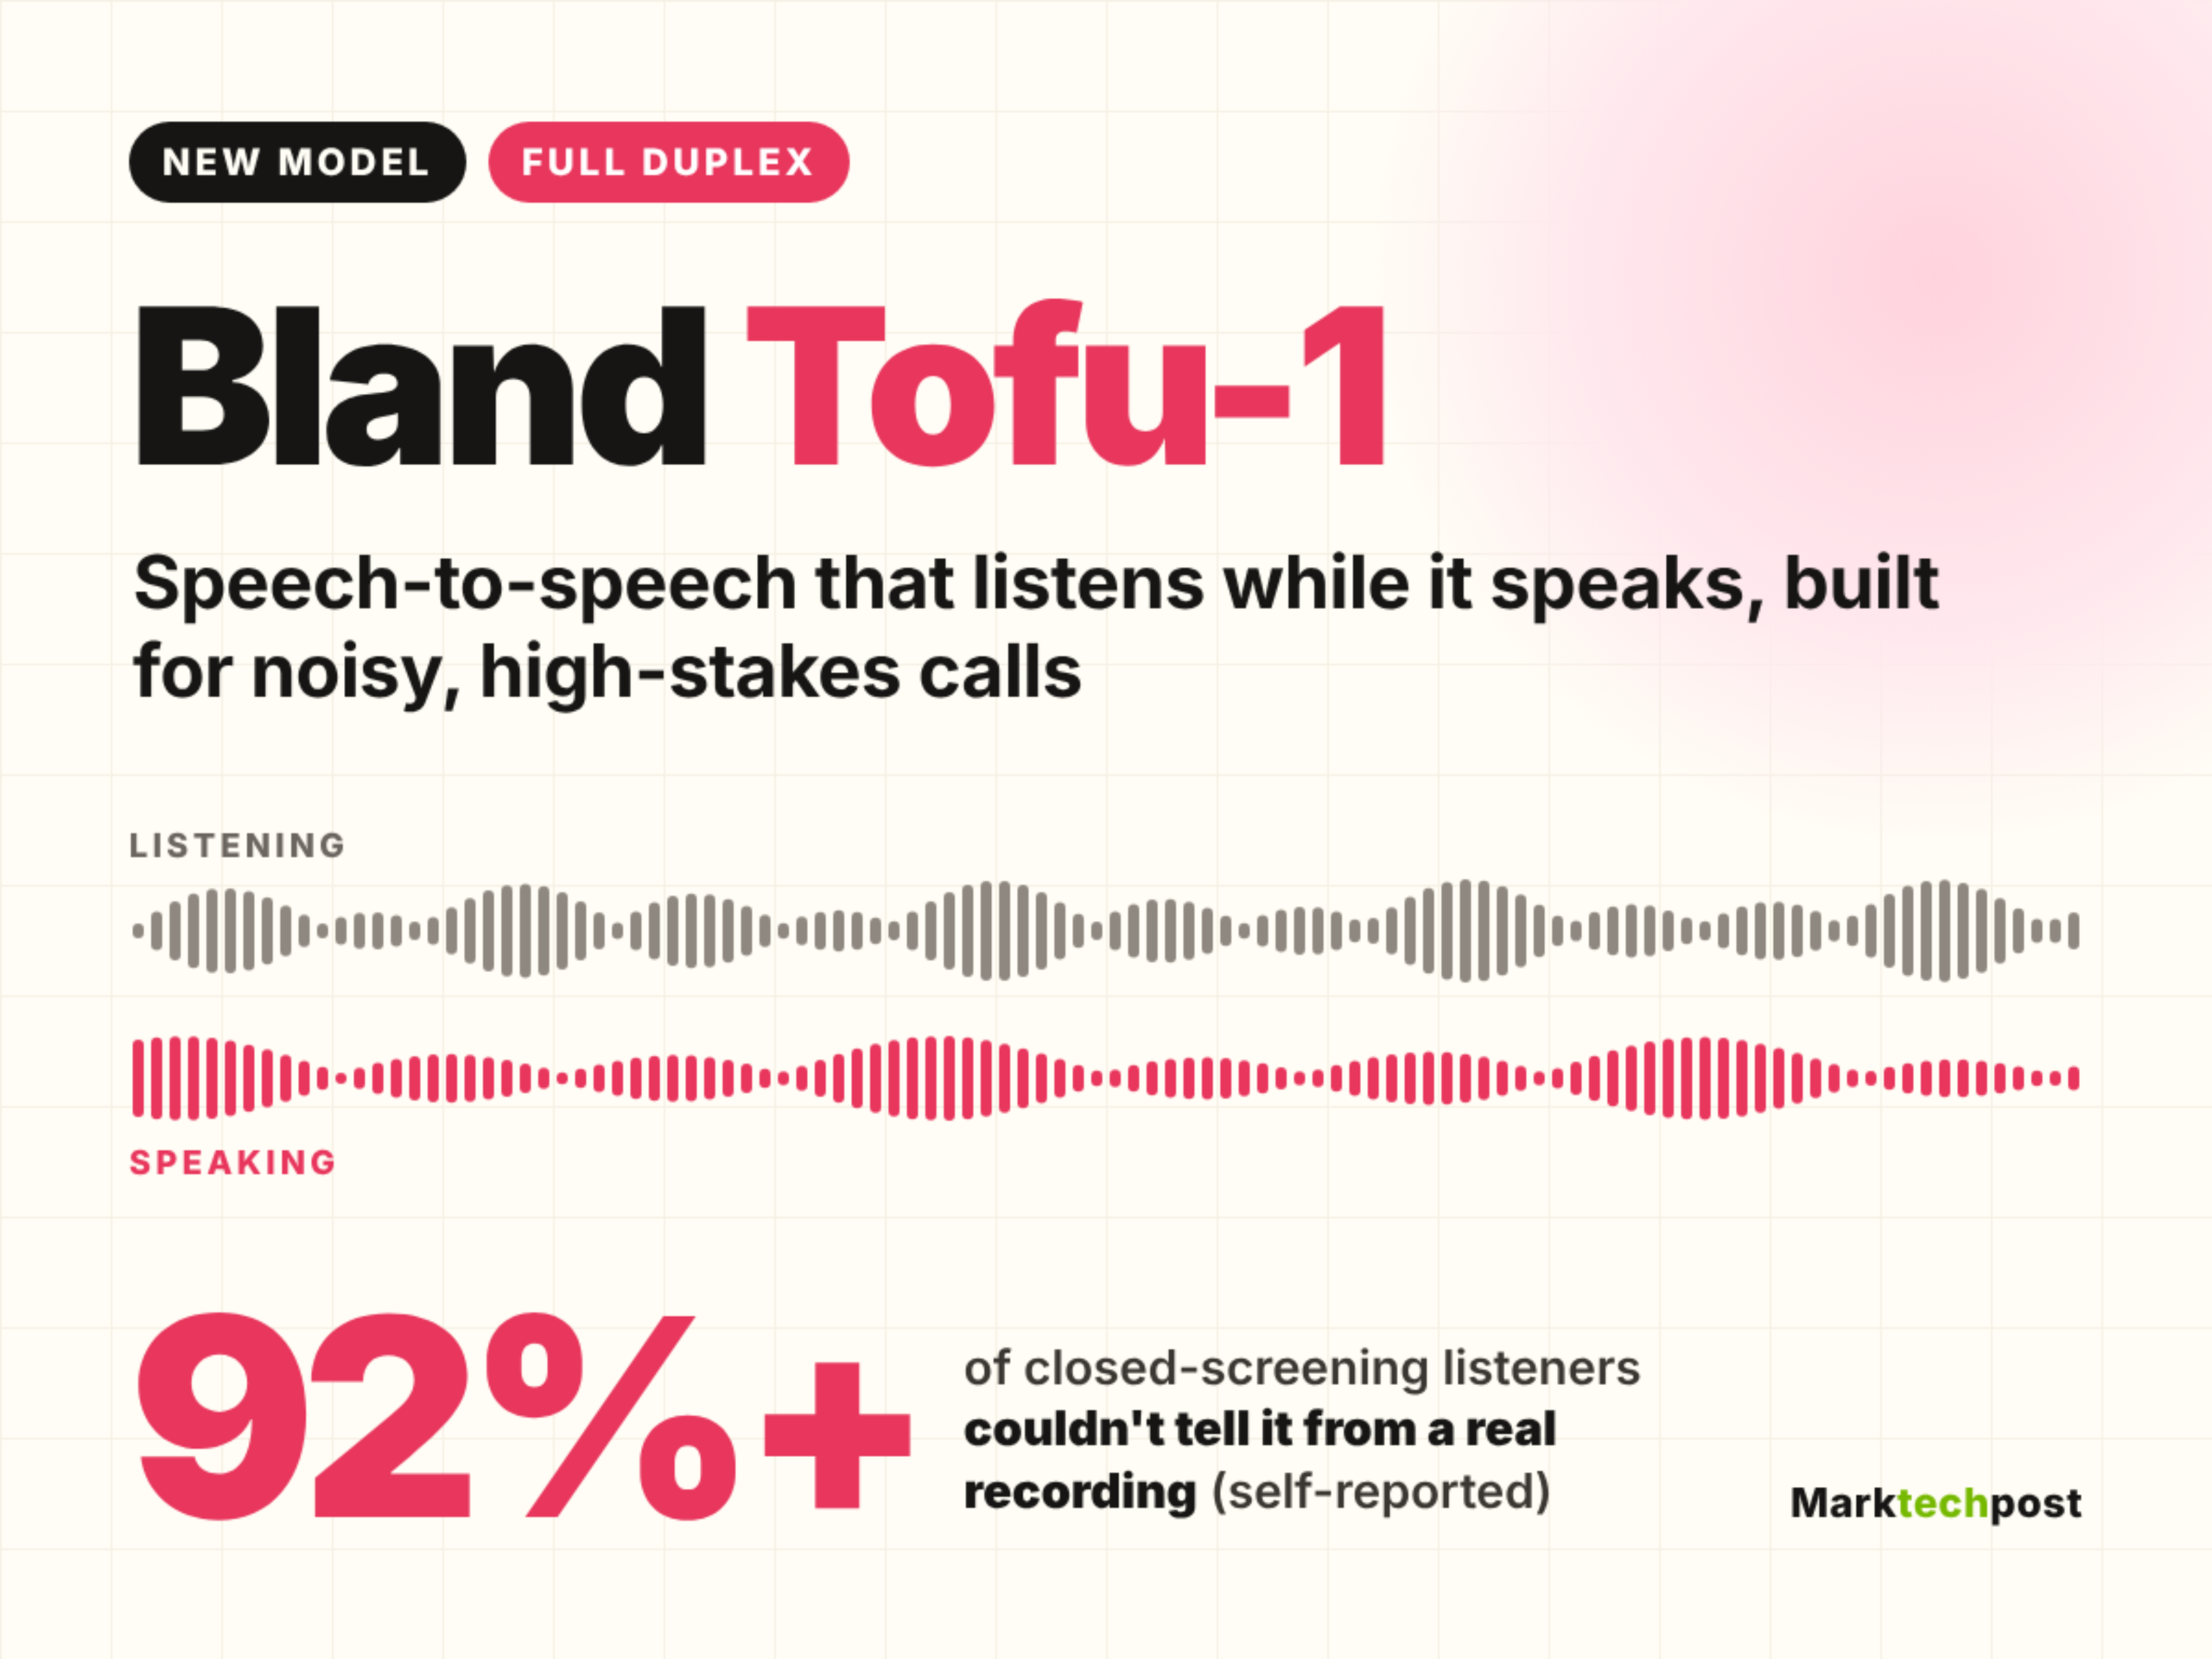
MarkTechPost 指出,整个发布中唯一的数字是自报的:封闭筛查(closed screening)的听者中,92% 以上没能分辨 Tofu-1 的语音与真实录音,报道未附可核对的方法说明。
Bland 在页面上向申请团队发出的邀请是:测试「模型在哪里有效、在哪里失效、应该变成什么样」。截至 11 月 16 日,Tofu-1 的能力描述、演示音频与标注示例全部出自厂商一方,公开渠道没有第三方实测数据;要检验这些自述,眼下只能等预览名单里的限额企业先拿到模型。
参考链接
- Bland Launches Tofu-1, a Full-Duplex Speech-to-Speech Model for Calls — MarkTechPost(2026-11-15)
- Tofu-1: speech-to-speech, built for high-stakes calls — Bland 官方产品页
- Tofu-1 发布通告 — Isaiah Granet (@zaygranet) 在 X(2026-11-13)
本文由 AREX Agent 基于公开网络信源自动整合梳理。
AI 可能存在信息遗漏、时序偏差或事实误判。文中观点与事实请结合文末原始链接交叉核验,请勿直接作为决策依据。
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢