

DRUGONE
单细胞多组学技术的快速发展为构建大规模细胞图谱提供了丰富的数据资源,但不同组学模态、研究批次和物种之间的数据异质性,使跨数据集整合面临挑战。现有方法通常针对特定整合场景设计,容易在消除技术差异的同时掩盖真实的生物学变异。针对这一问题,研究人员提出了multiVIB,一种结合变分信息瓶颈与概率对比学习的统一计算框架,能够同时支持单细胞多组学数据的水平整合、垂直整合和镶嵌式整合。通过引入具有不确定性感知能力的潜在表示和生物学约束,multiVIB在多个基准数据集上表现出较好的整合性能,并有效减少不同细胞类型之间的错误对齐。在大规模脑细胞图谱构建中,该方法实现了小鼠初级运动皮层九种分子组学模态的增量整合,并成功整合人类、猕猴和狨猴基底神经节的单细胞转录组数据,在识别保守细胞类型的同时保留物种特异性分子程序。研究表明,multiVIB为构建可持续扩展、兼顾整合一致性与生物学真实性的单细胞多组学图谱提供了新的解决方案。
单细胞组学技术能够从基因表达、染色质可及性、DNA甲基化和组蛋白修饰等多个层面解析细胞状态,为认识组织结构、细胞异质性及分子调控机制提供了重要手段。美国脑科学计划通过BICCN和BICAN等项目,持续积累不同物种、脑区及分子模态的单细胞数据,推动构建更加完整的哺乳动物脑细胞图谱。
然而,随着数据规模扩大,如何整合不同研究产生的异质数据成为关键问题。传统单细胞整合方法主要分为水平整合和垂直整合。水平整合依赖不同数据集之间共享的基因组特征,垂直整合则利用同一细胞中联合测量的多种组学数据建立模态对应关系。实际研究中的数据往往同时包含不同批次、部分共享特征和不完整的多组学配对信息,形成更加复杂的镶嵌式数据结构,单一整合策略难以充分处理。
更重要的是,数据整合并不意味着消除所有差异。现有方法常将研究批次、组学模态甚至物种差异作为需要校正的技术因素,容易将原本不同的细胞状态错误映射至同一空间,造成过度整合。特别是在跨物种分析中,如果仅依赖保守同源基因进行对齐,可能进一步丢失具有进化意义的物种特异性调控程序。
研究人员因此开发了multiVIB,希望通过统一的概率表示学习框架,在实现跨模态、跨研究和跨物种数据对齐的同时,保留细胞类型及其分子调控特征,为持续扩展的大规模脑细胞图谱提供可靠基础。
方法
multiVIB采用由模态特异性转换器、共享编码器和投影器组成的统一网络架构。首先,不同组学数据通过各自的转换器映射至以基因表达为中心的共同特征空间,再由共享编码器利用变分信息瓶颈学习具有概率分布特征的细胞潜在表示,以描述细胞状态及其不确定性。投影器进一步引入批次、物种和模态等协变量,并通过概率对比学习优化跨数据集对应关系。在水平整合中,模型利用共享基因组特征和数据增强构建对比学习样本;在垂直整合中,采用同一细胞的不同组学测量作为天然配对锚点;镶嵌式整合则根据数据之间的特征重叠和配对情况组合两种训练策略。针对跨模态及跨物种整合,研究人员还设计了两阶段转换器训练机制,首先利用生物学先验约束特征映射,再通过低秩参数更新恢复更多数据集间的共同变化和特异性信息。研究人员使用人类外周血、骨髓、肺组织以及小鼠和灵长类脑组织数据,对模型的批次校正、模态对齐、细胞类型保留和标签迁移能力进行系统评估。
结果
multiVIB构建统一的单细胞多组学整合框架
研究人员首先分析了不同单细胞多组学整合任务的特点。水平整合通常通过共享特征连接不同数据集,适用于不同研究中的同类组学或具有共同基因组信息的不同模态;垂直整合依赖同一细胞的多组学联合测量,可直接利用细胞配对关系建立跨模态对应。然而,在实际的大规模研究中,多数数据仅具有部分特征重叠或有限的配对关系,必须采用更加灵活的整合策略。
为此,multiVIB使用统一网络架构处理三类任务,而不是为每种数据组合重新设计模型。不同模态首先被转换到共同的基因中心特征空间,随后通过共享编码器生成细胞潜在表示,并利用对比学习增强具有共同生物学特征的细胞之间的一致性。
与确定性的表示学习方法不同,multiVIB引入变分信息瓶颈,使细胞表示具有不确定性感知能力,从而降低模型对不可靠跨模态对应关系的过度确信。同时,概率对比学习强调可重复的生物学相似性,避免仅根据技术特征进行强制对齐。
研究人员还设计了两阶段模态转换机制。第一阶段利用已知的基因组关联限制特征映射,第二阶段逐步放宽约束,使模型在维持生物学合理性的同时学习额外的跨数据集变化。这一设计使multiVIB能够处理不同组学之间复杂的对应关系,并适应后续新增数据。
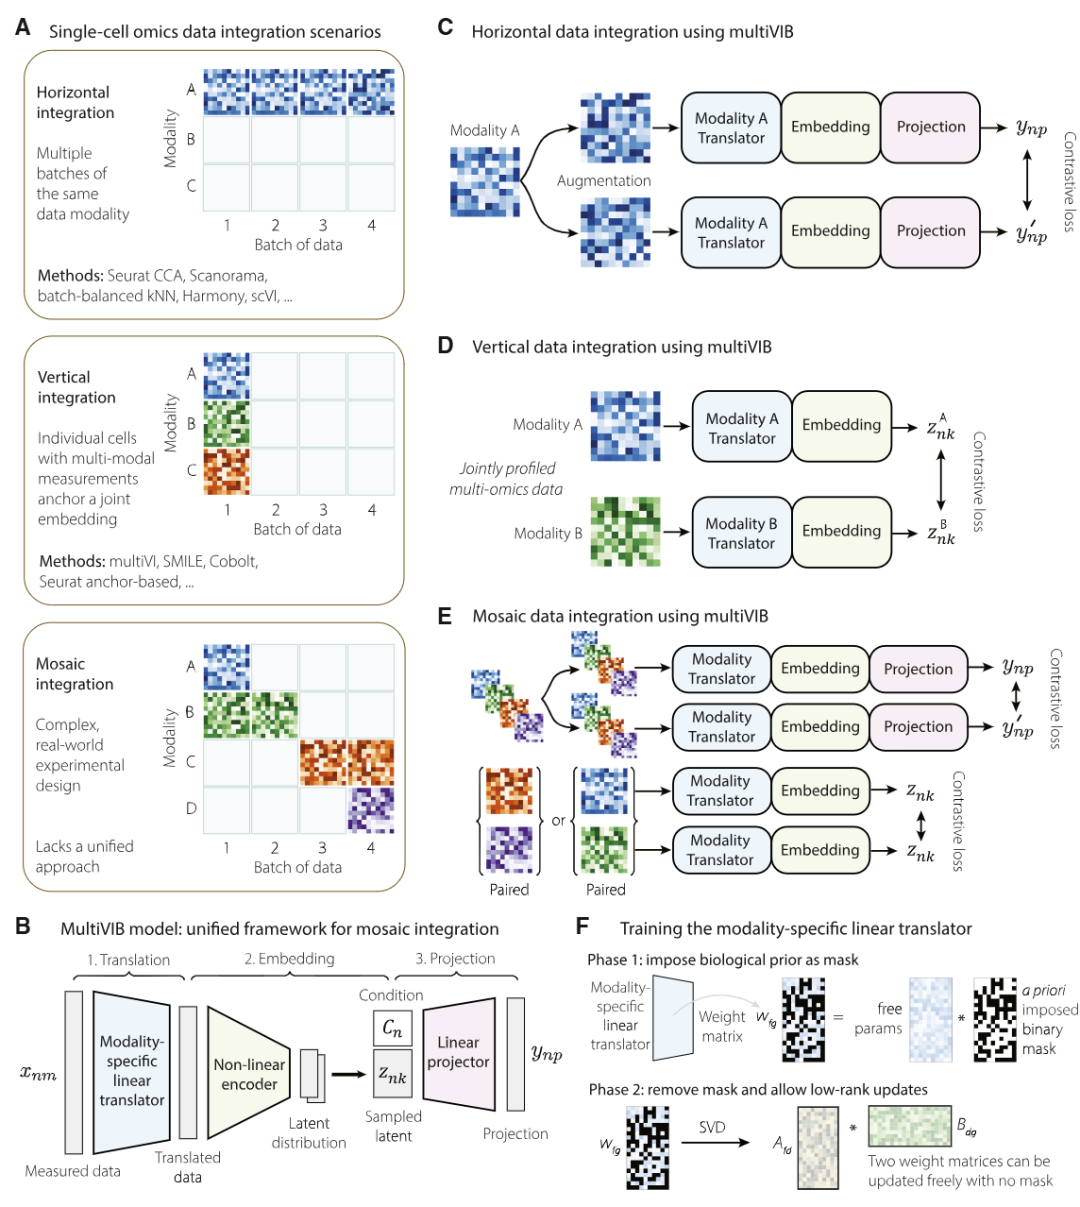
图1|multiVIB统一单细胞多组学整合框架及水平、垂直和镶嵌式整合策略。
概率对比学习减少跨模态错误对齐
错误对齐是单细胞数据整合中的重要问题。当算法过度消除数据集差异时,原本具有不同生物学功能的细胞可能被映射至相近位置,形成看似良好却缺乏生物学依据的整合结果。
为检验multiVIB能否避免这一问题,研究人员利用10× Genomics Multiome外周血单核细胞数据构建测试场景。该数据同时包含RNA表达和染色质可及性测量。研究人员有意隐藏CD16⁺单核细胞、CD8⁺ T细胞和B1 B细胞中的真实跨模态配对关系,仅利用其他细胞类型的配对信息训练模型,再评价其能否正确恢复隐藏的细胞对应关系。
结果显示,与Cobolt、SMILE、MultiVI和Seurat等方法相比,multiVIB在模态混合程度和跨模态细胞类型映射方面表现更好。即使增加潜在空间维度,模型仍能维持相对稳定的性能,而部分对比方法的整合质量明显下降。
研究人员还通过局部注释富集评分分析细胞邻域中的模态混合情况,发现multiVIB在三个隐藏配对的细胞类型中均获得较好的局部对齐结果,说明其能够利用有限的已知对应关系推断其他细胞群体的跨模态关联。
此外,在整合来自不同研究的人类外周血和骨髓单细胞数据时,multiVIB能够保留仅存在于特定数据集中的祖细胞群体,而不会将其强制合并到其他研究的细胞类别中。
这些结果表明,multiVIB不仅关注不同数据集能否混合,还能够保留真实的细胞群体差异,从而减少过度整合造成的生物学信息损失。
在不同整合场景中保持稳定的生物学一致性
研究人员进一步将multiVIB与11种主流单细胞数据整合方法进行系统比较,评价其在批次校正、模态对齐、细胞类型保留和跨模态标签迁移四个方面的性能。
在垂直整合任务中,multiVIB与MultiVI、SMILE、Cobolt和Seurat等方法进行比较。结果显示,multiVIB在模态对齐及跨模态映射方面表现突出,同时能够较好地保留不同细胞类型的结构。对于批次校正,multiVIB和Seurat也取得了较好的结果。
在水平整合任务中,研究人员进一步与Harmony、Scanorama、BBKNN、scVI、sysVI和LIGER等方法比较。结果发现,部分方法在同一组学的跨批次整合中具有优势,却难以同时完成跨模态对齐;另一些方法适用于配对多组学数据,但面对独立研究产生的数据时表现有限。
相比之下,multiVIB能够在不同任务之间保持较为均衡的性能。在跨模态标签迁移实验中,以独立RNA测序数据作为参考、ATAC测序数据作为查询时,模型在粗粒度和细粒度细胞类型注释上的标准化互信息分别达到0.616和0.578。
研究人员还在人体肺细胞图谱和小鼠脑染色质可及性数据中验证模型性能。结果显示,multiVIB在多项任务中处于领先方法之列,尤其在单细胞ATAC数据整合方面具有较好的表现。
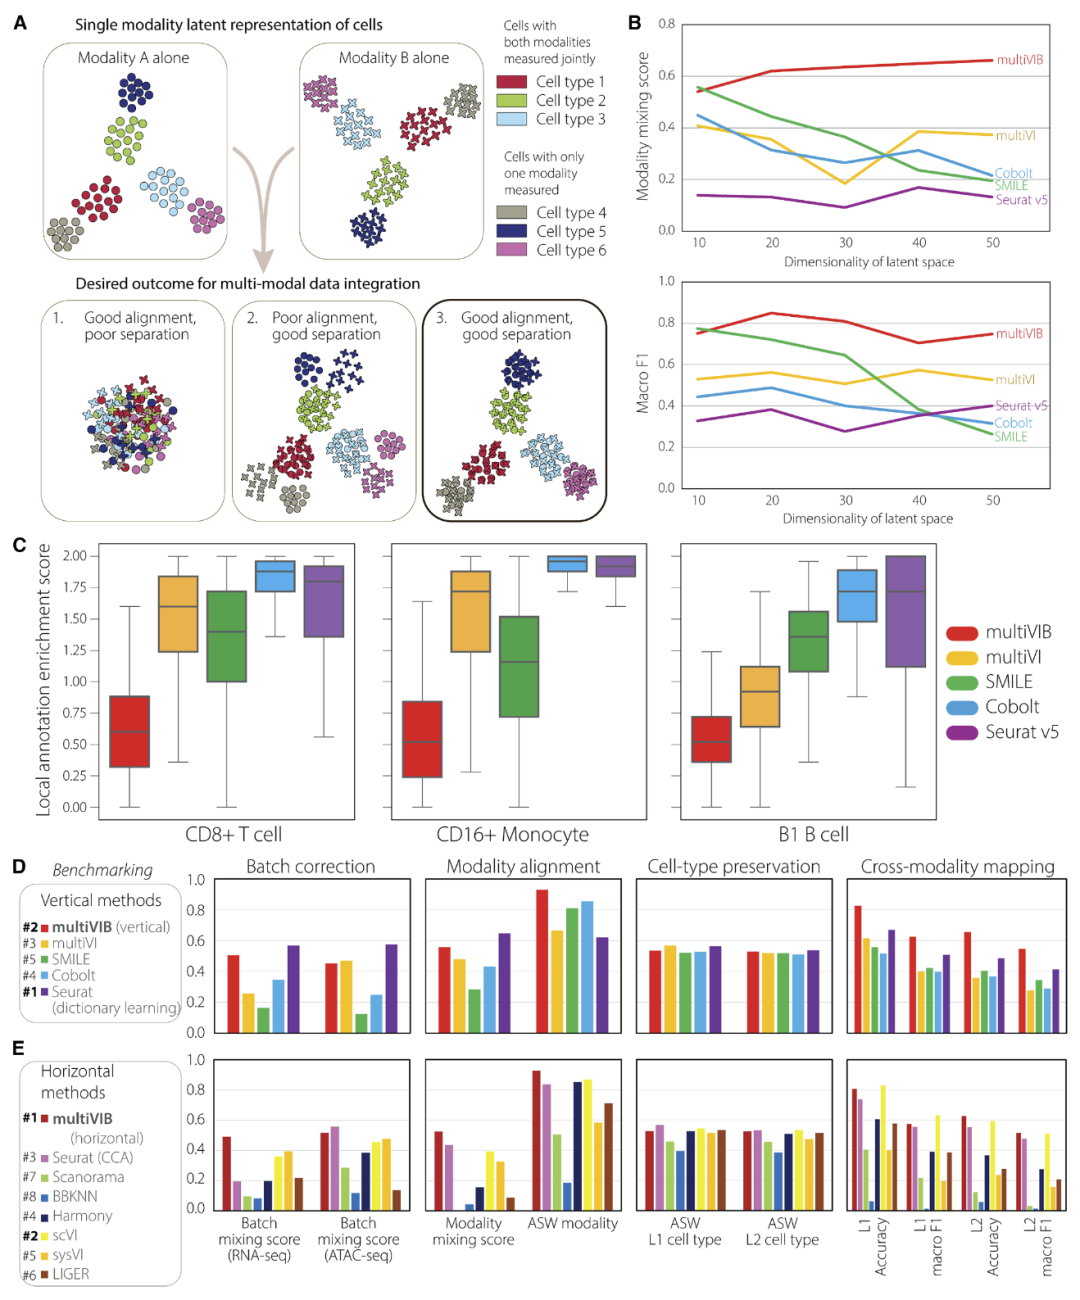
图2|multiVIB与现有方法的整合性能比较及跨模态错误对齐分析。
实现小鼠初级运动皮层九种组学模态的增量整合
为验证multiVIB在真实大规模细胞图谱中的应用能力,研究人员选择小鼠初级运动皮层作为研究对象。该脑区已经积累了丰富的单细胞转录组和表观基因组数据,但不同研究采用的测量技术存在明显差异,难以直接形成统一图谱。
研究人员整合了来自六个数据来源的九种分子组学模态,包括RNA表达、染色质可及性、不同背景下的DNA甲基化以及多种组蛋白修饰数据。这些数据同时存在配对信息不完整、样本组成不平衡及模态间缺乏直接对应关系等问题。
针对这一复杂场景,研究人员采用逐数据集增量训练策略。模型在加入新数据时保留已有共享编码器参数,并根据新增模态更新或建立相应转换器,从而避免每次扩展图谱时都从头训练。
结果显示,multiVIB能够将不同模态和研究来源的细胞整合至共同空间,同时维持主要细胞类型的分离。利用跨模态标签迁移进行评价时,CG与非CG背景的DNA甲基化数据之间具有较高的一致性,其调整兰德指数和标准化互信息均接近0.9。
在RNA与ATAC数据的垂直整合中,模型获得0.63的宏平均F1值和0.69的总体准确率。不过,部分组蛋白修饰模态的表现相对较弱,例如H3K4me3的宏平均F1值仅为0.23,表明不同分子层面的调控信息并不总能直接映射至相同的细胞类型划分。
进一步的细胞查询实验显示,以星形胶质细胞、L6皮质丘脑投射神经元和L2/3端脑内投射神经元作为查询对象时,模型通常能够在其他模态和研究中找到具有相同细胞身份的群体。
这些结果说明,multiVIB能够支持不断扩展的多组学脑细胞图谱,同时揭示不同分子模态在细胞身份描述上的一致性与差异。
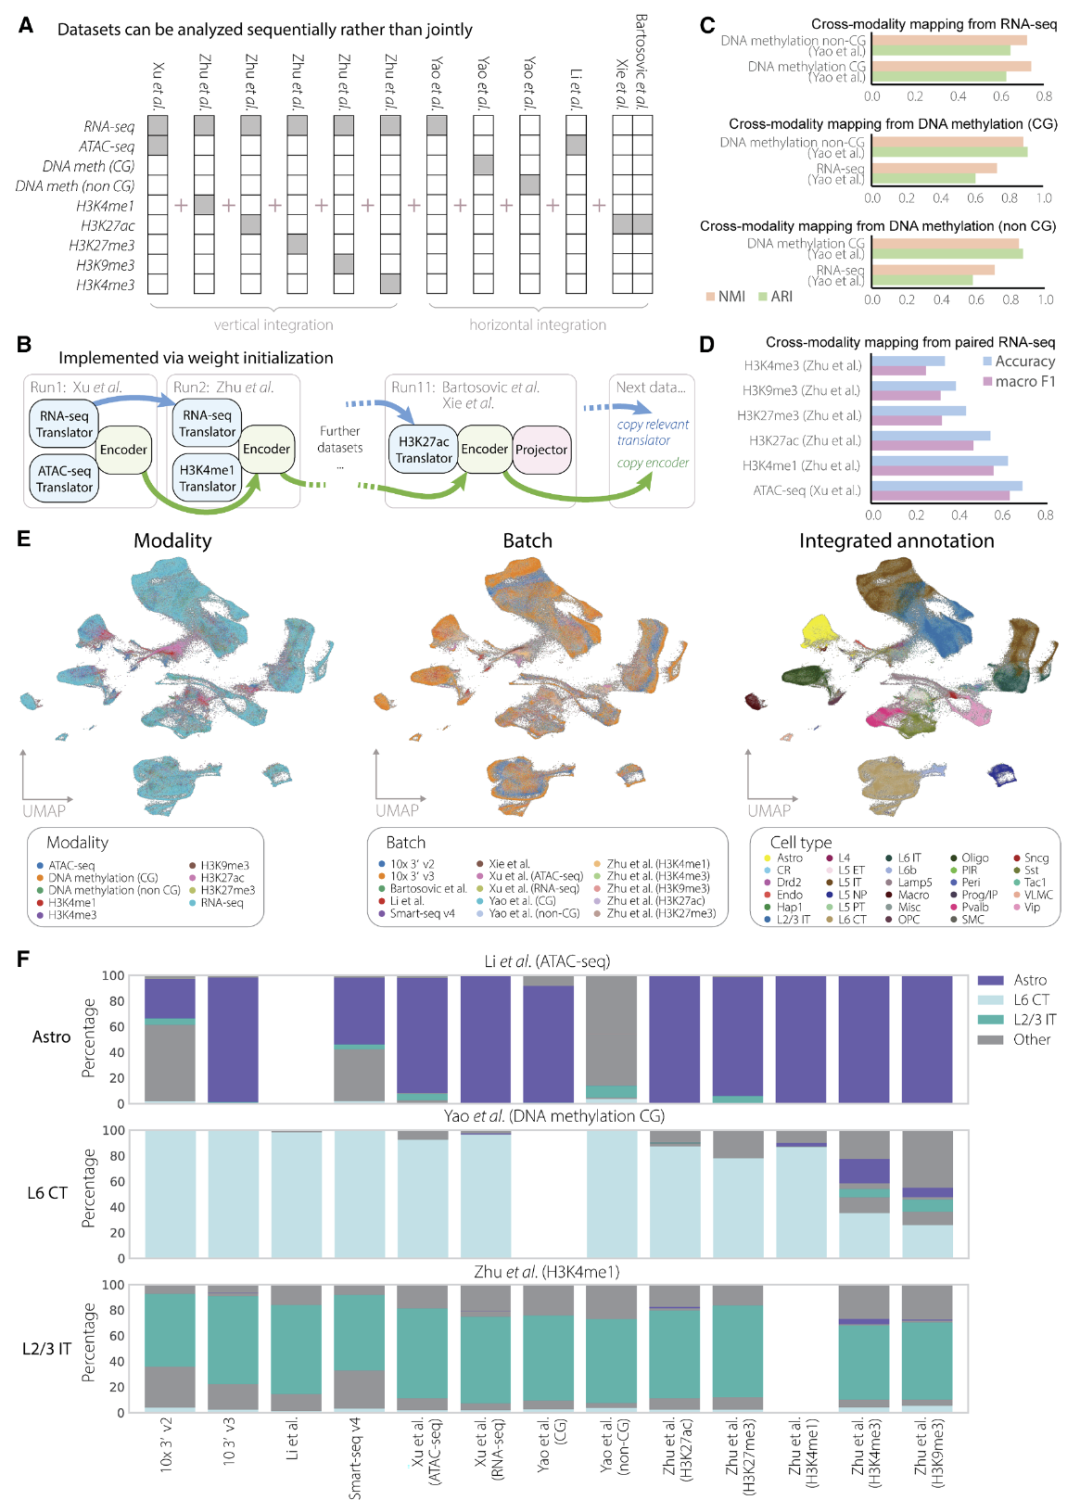
图3|multiVIB实现小鼠初级运动皮层九种分子组学模态的镶嵌式增量整合。
跨物种整合揭示保守细胞类型与特异性分子程序
跨物种单细胞整合对于理解脑细胞演化及神经系统疾病具有重要意义。然而,过度依赖保守基因进行数据对齐,可能使物种特异性分子特征被错误消除。
研究人员首先使用人类和小鼠初级运动皮层数据检验multiVIB的跨物种整合能力,随后将其应用于人类、恒河猴和普通狨猴的基底神经节单细胞转录组数据。
在跨物种训练中,模型首先利用保守同源基因建立细胞对应关系,再逐步放宽转换器约束,恢复不同物种特有的转录变化。
结果显示,整合后的细胞主要按照同源细胞类型聚集,而非根据物种来源分离。模型成功保留了主要细胞类别及其亚类之间的边界,与已有灵长类基底神经节细胞分类体系保持一致。
研究人员进一步分析模型学习得到的基因嵌入表示,发现不同基因模块表现出明显的细胞类型特异性富集。以免疫相关基因程序为例,模型能够区分人类特异性、非人灵长类特异性以及三个物种共同保留的分子程序。
这一结果表明,multiVIB并非简单消除物种差异,而是在建立共同细胞分类体系的同时保留具有进化意义的分子变化,为比较神经科学研究提供了新的分析工具。
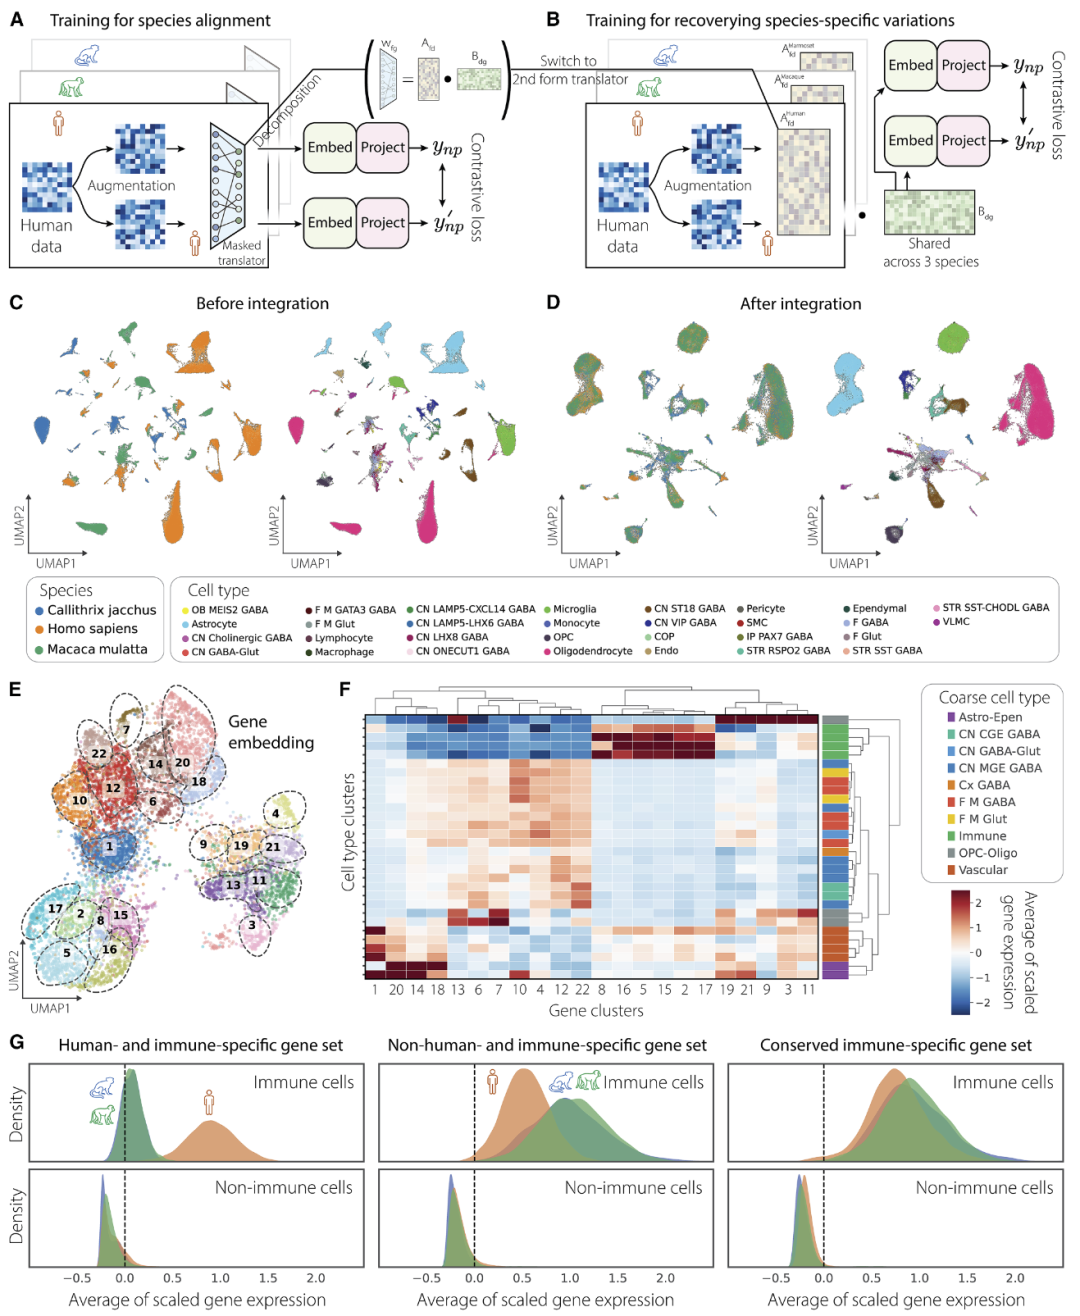
图4|multiVIB跨物种整合灵长类基底神经节单细胞转录组及保守与物种特异性分子程序分析。
讨论
本研究提出的multiVIB为复杂单细胞多组学数据整合提供了统一的概率学习框架。其主要优势在于不再针对水平、垂直和镶嵌式整合分别建立独立流程,而是通过共享网络架构与灵活的训练策略处理不同模态、研究批次和物种之间的数据差异。
研究人员强调,单细胞整合的目标并非最大程度消除数据差异,而是在校正技术偏差的同时保留具有生物学意义的细胞状态。multiVIB通过变分信息瓶颈和概率对比学习减少错误对齐,并借助增量训练支持大规模细胞图谱持续更新。小鼠运动皮层和灵长类基底神经节的分析表明,该框架既能恢复保守细胞身份,也能够揭示跨模态及跨物种的分子差异。
不过,不同组学模态具有不同的生物学含义,其信号并不总能直接对应。模型在部分组蛋白修饰数据上的整合表现仍然有限,而且随着模态数量增加,共享潜在空间可能难以完整保留各模态特有的信息。未来还需要探索更加合理的表示学习目标,并结合细胞类型层级注释进一步提高整合的准确性和可解释性。
总体而言,multiVIB为构建可扩展、可更新且具有生物学真实性的单细胞多组学图谱提供了实用方法,有望促进跨研究、跨模态和跨物种的细胞类型比较,为脑科学及疾病机制研究提供更加完整的数据基础。
整理 | DrugOne团队
参考资料
Xu et al., multiVIB: A unified probabilistic contrastive learning framework for atlas-scale integration of single-cell multiomics data, Cell Reports Methods (2026)
https://doi.org/10.1016/j.crmeth.2026.101664
内容为【DrugOne】公众号原创|转载请注明来源
内容中包含的图片若涉及版权问题,请及时与我们联系删除


评论
沙发等你来抢